Echtzeit-Spracherkennung bietet mehr als nur schnelle Untertitel. Berücksichtigen Sie vier versteckte Funktionen wie Zeiterfassung, Korrekturen, Sprechersteuerung und die Eignung für mehrsprachige Meetings, bevor Sie sich entscheiden.
Die Echtzeit-Spracherkennung kann in einer Demo hervorragend aussehen, aber in einem echten Gespräch versagen. Die ersten Wörter erscheinen vielleicht in 300 Millisekunden, doch der Satz kann sich über zwei Sekunden hinweg ständig verändern. Eine Sprecherkennzeichnung wird möglicherweise angezeigt und dann korrigiert. Ein fehlerfreies Transkript ist zwar schnell fertig, lässt aber die Negation aus, die die Entscheidung beeinflusst hat.
Deshalb ist die Frage “Wie schnell geht es?” die falsche erste Frage. Eine sinnvolle Bewertung erfordert vier Zeitmessgrößen: Zeit bis zum ersten Text, Zeit bis zum stabilen Text, Zeit bis zum Abschluss einer Bearbeitung und Zeit bis zum verwendbaren Datensatz. Jede dieser Zeitmessgrößen erfüllt eine andere operative Anforderung.
Dieser Artikel behandelt Echtzeit-Sprache-zu-Text-Umwandlung Es betrachtet die Arbeitsweise als messbare Pipeline und nicht als visuellen Effekt. Es vergleicht spezialisierte Streaming-APIs mit einem sofort einsatzbereiten, mehrsprachigen Meeting-Produkt, bietet ein wiederholbares Testskript und erklärt, wann die Transkription allein nicht ausreicht, weil die Teilnehmer Übersetzungen, Sprachausgabe oder Notizen benötigen.
Die 60-Sekunden-Antwort
Echtzeit-Sprache-zu-Text-Umwandlung Das System wandelt einen Live-Audiostream in Text um, während der Sprecher noch spricht. Der angezeigte Text ist oft vorläufig. Erste Wörter können korrigiert werden, sobald das Modell mehr Kontext erhält, eine Pause erkennt, einen Sprecher identifiziert, Satzzeichen einfügt oder eine Äußerung abschließt.
Die vier Uhren sind:
- Latenzzeit der ersten Nachricht: Wie lange dauert es, bis eine Hypothese auftaucht?
- Stabilitätslatenz: Wie lange dauert es noch, bis sich die Wörter nicht mehr verändern?
- Latenz bei Abschluss der Abbiegevorgänge: Wie lange dauert es, bis das System entscheidet, dass ein Redebeitrag oder eine Äußerung beendet ist?
- Workflow-Latenz: Wie lange dauert es, bis das Transkript für die Suche, Notizen, Aktionen, Übersetzungen oder eine Antragsantwort verwendet werden kann?
Ein Sprachassistent priorisiert möglicherweise die Aktualität der Gesprächsbeiträge, da er entscheiden muss, wann er antwortet. Barrierefreie Untertitel priorisieren möglicherweise schnell lesbaren Teiltext. Ein Besprechungsprotokoll toleriert unter Umständen eine etwas langsamere Anzeige, wenn Namen, Nummern und Sprecherzuordnung zuverlässiger werden. In einer mehrsprachigen Besprechung kommt nach der Spracherkennung ein weiterer Schritt hinzu: Die Übersetzung muss rechtzeitig eintreffen, damit jemand reagieren kann.
Echtzeit-Spracherkennung ist eine sich ständig weiterentwickelnde Hypothese.
Ein Live-Transkript wird nicht in einem Schritt erstellt:
Mikrofon- oder Systemaudio → Kodierung und Transport → Spracherkennung → vorläufige Erkennung → Überarbeitung → Finalisierung → Sprecherkennzeichnung und -formatierung → Anwendungsaktion
Der Bildschirm zeigt üblicherweise nur den mittleren Bereich an. Dadurch entsteht eine häufige Illusion: Da der Text sofort erscheint, nehmen Nutzer an, das Ergebnis sei fertig. Tatsächlich berechnet die Engine möglicherweise noch Wortgrenzen, Zeichensetzung, Sprache oder Sprecheridentität.
Spezialisierte APIs machen diese Unterscheidung explizit. Deepgram Das System liefert Zwischen- und Endergebnisse separat. Die Dokumentation erklärt, dass sich der vorläufige Text ändern kann, während die endgültigen Segmente angehängt werden müssen, um eine vollständige Äußerung zu rekonstruieren. Ein separates Signal signalisiert, dass das System einen Endpunkt wie beispielsweise eine Pause erkannt hat.
Soniox Über eine persistente Streaming-Verbindung werden finale und nicht-finale Token, Zeitstempel, Konfidenzwerte, Sprachinformationen, optionale Sprecherbezeichnungen und der Verarbeitungsfortschritt bereitgestellt. AssemblyAI Bietet in unterstützten Modellen ebenfalls Teil- und Endtranskripte, Endpunktmarkierungen, Zeitstempel auf Wortebene, Schlüsselbegriffshinweise und Streaming-Sprecherdiarisierung.
Diese Steuerelemente sind für Entwickler nützlich. Sie zeigen auch, warum ein Endbenutzer nicht urteilen sollte. Echtzeit-Sprache-zu-Text-Umwandlung allein anhand der ersten sichtbaren Linie.
Uhr 1: Zeit für die erste SMS
Die erste Zeitmessung beginnt, sobald Sprache das System erreicht, und endet, sobald die erste nicht leere Hypothese sichtbar oder für die Anwendung verfügbar wird.
Diese Messung umfasst mehr als nur Modellinferenz:
- Mikrofon- oder Besprechungs-Audioaufnahme.
- Puffergröße und Audio-Chunking.
- Resampling oder Kodierung.
- Netzwerktransport.
- Serververarbeitung.
- Rücktransport.
- Interface-Rendering.
Messen Echtzeit-Sprache-zu-Text-Umwandlung Die Daten stammen vom eigentlichen Benutzergerät, nicht von einem API-Dashboard. Die serverseitigen Werte eines Anbieters können Audiopufferung, Client-Netzwerkverbindungen, Browser-Rendering und die Verzögerung der Meeting-Plattform selbst ausschließen.
Eine schnelle erste Textausgabe ist hilfreich, wenn Nutzer die Gewissheit benötigen, dass das System reagiert. Sie ist weniger nützlich, wenn die Benutzeroberfläche sie dazu anregt, auf unfertige Wörter zu reagieren. Ein gutes Beschriftungsdesign hebt vorläufigen Text visuell hervor, ohne ihn unlesbar zu machen.
Wie man die erste Uhr testet
Nehmen Sie Audio und Bildschirm mit 60 Bildern pro Sekunde auf. Klatschen Sie einmal und sagen Sie dann: “Die Verlängerung wurde nicht genehmigt.” Markieren Sie das Bild, in dem die Wellenform oder das Klatschen den Eingang erreicht, und das Bild, in dem der erste Text erscheint. Wiederholen Sie dies zehnmal und geben Sie den Median und das langsamste Ergebnis an, nicht das schnellste.
Prüfen Echtzeit-Sprache-zu-Text-Umwandlung Unter normalen WLAN-Bedingungen, bei einem überlasteten Netzwerk, einem Laptop mit aktivierter Rauschunterdrückung und dem verwendeten Headset oder Raummikrofon ist die Geschwindigkeit der ersten Nachricht, die unter normaler Last verschwindet, kein verlässliches Produktmerkmal.
Uhr 2: Zeit für stabilen Text
Die zweite Uhr stoppt, sobald sich ein Textabschnitt nicht mehr ändert. Diese Uhr wird in den meisten Marketingpräsentationen ausgeblendet.
Betrachten wir den gesprochenen Satz:
“Versenden Sie am Donnerstag fünfzehn – Entschuldigung, fünfzig – Einheiten.”
Die Anzeige kann von “Lieferung 15” über “Lieferung 50” bis hin zu einer Korrektur mit Punktzeichen reichen. Die erste Version traf schnell ein, aber nur die endgültige Version kann gefahrlos in eine Bestellung übernommen werden.
Stabilität ist wichtig, da nachgelagerte Systeme möglicherweise zu früh reagieren. Eine Live-Zusammenfassung, ein Vertriebsassistent, ein Compliance-Trigger, eine Übersetzungsschicht oder ein Sprachagent können einen vorläufigen Fehler übernehmen. Echtzeit-Sprache-zu-Text-Umwandlung Um einen reibungslosen Workflow zu gewährleisten, sollten Entwickler die Finalitätssignale der Engine verarbeiten, anstatt jede Teilaktualisierung als abgeschlossene Anweisung zu behandeln.
Messen Sie die Revisionsdistanz, nicht nur die Verzögerung.
Protokolliere für jeden Testsatz:
- Anzahl der vorläufigen Versionen.
- Anzahl der ersetzten oder entfernten Wörter.
- Zeit zwischen dem letzten gesprochenen Wort und dem stabilen Text.
- Ob das endgültig gespeicherte Protokoll mit der stabilen Anzeige übereinstimmt.
- Ob eine nachgelagerte Aktion vor dem Erreichen des Stabilitätsniveaus ausgelöst wurde.
etwas langsamer Echtzeit-Sprache-zu-Text-Umwandlung Das System kann sicherer sein, wenn es weniger aggressiv überarbeitet wird. Der richtige Kompromiss hängt davon ab, ob die Benutzer lesen, diktieren, Software steuern oder verhandeln.
Uhr 3: Zeit bis zum Abschluss einer Runde
Worte können endgültig sein, der Redebeitrag jedoch nicht. Man kann innehalten, um nachzudenken, zu atmen, nach einer Figur zu suchen oder eine Unterbrechung abzuwarten. Erklärt das System den Redebeitrag zu früh für beendet, kann ein Sprachassistent den Nutzer unterbrechen. Wartet es zu lange, wirkt das Gespräch unkoordiniert.
Beim Endpunkting wird typischerweise Stille oder Sprachaktivität genutzt, um auf das Ende der Rede zu schließen. Deepgram Dokumente konfigurierbare Endpunkte und separate ist_final Und Rede_final Die Richtlinien des Bundesstaates weisen darauf hin, dass kurze Schwellenwerte für kurze Chatbot-Antworten geeignet sind, während längere Gesprächspausen Hunderte von Millisekunden benötigen können, bevor ein Gesprächsbeitrag als abgeschlossen gilt.
Es gibt keine universelle Sprechweise, die für jeden Sprecher geeignet ist. Ein schnelles Callcenter-Skript, eine zögerliche Anamnese, eine Vorlesung und eine zweisprachige Verhandlung erfordern unterschiedliche Pausenmuster. Der Abschluss eines Redebeitrags ist daher von zentraler Bedeutung. Echtzeit-Sprache-zu-Text-Umwandlung Messung, nicht bloß eine API-Einstellung.
Führe den Zögertest durch
Verwenden Sie diese vier Zeilen:
- “Meine Kontonummer lautet … 4172.”
- “Ich stimme zu … wenn der Liefertermin Freitag bleibt.”
- “Die Dosis beträgt fünfzehn – nein, fünfzig – Milligramm.”
- “Ana, kannst du –” woraufhin ein zweiter Sprecher unterbricht.
Zählen Sie falsche Gesprächsabbrüche, verspätete Endpunkte, Unterbrechungen und abgeschnittene Wörter. Passen Sie den Endpunktschwellenwert nur dann an, wenn die Anwendung dies erfordert. Bei einer fertigen Anwendung beobachten Sie das Verhalten und entscheiden Sie, ob es den Anforderungen entspricht.
Diese Uhr ist dort Echtzeit-Sprache-zu-Text-Umwandlung wird zu Gesprächsführung statt zu gewöhnlicher Transkription.
Uhr 4: Zeit für einen brauchbaren Datensatz
Die vierte Uhr ist für die Teams die wichtigste. Sie endet, sobald die Ergebnisse die nächste Aktion ermöglichen.
“Verwendbar” kann Folgendes bedeuten:
- Die Untertitel bleiben während der gesamten Sitzung lesbar.
- Die Sprecher sind identifizierbar.
- Namen, Zahlen und Fachbegriffe sind korrigierbar.
- Ein vollständiges Transkript kann kopiert oder exportiert werden.
- Der Datensatz ist durchsuchbar und berechtigt.
- Es werden eine Zusammenfassung und Maßnahmenpunkte generiert.
- Quelltext und übersetzter Text bleiben zusammengehörig.
- Beibehaltung und Löschung sind bekannt.
Ein System kann die ersten drei Zeitmessungen gewinnen und die vierte verlieren. Rohdaten aus dem JSON-Stream sind kein Protokoll. Schnell verschwindende Untertitel sind kein Beweismittel. Eine ansprechende Zusammenfassung ohne nachvollziehbares Transkript kann Erkennungsfehler verschleiern. Deshalb Echtzeit-Sprache-zu-Text-Umwandlung Der Einkauf muss sowohl den fertigen Arbeitsablauf als auch das Streaming-Modell messen.
Echtzeit-Sprache-zu-Text-Umwandlung Die Bewertung sollte daher zum Zeitpunkt der Nutzung und nicht zum Zeitpunkt der Erstellung erfolgen. Bitten Sie Teilnehmer, Prüfer, Entwickler und Administratoren, dieselbe Sitzung aus ihrer jeweiligen Perspektive zu testen.
Vier Routen im Vergleich anhand von vier Uhren
| Werkzeuge | Produktart | Erster Text | Stabilitäts- und Endgültigkeitskontrollen | Lautsprecherhandhabung | Mehrsprachige Rolle | Arbeitsablauf für nutzbare Datensätze | Optimale Passform |
|---|---|---|---|---|---|---|---|
| Transync AI | Sofort einsatzbereite Meeting-Übersetzungs-App | Zweisprachige Live-Anzeige | Werden vom Produkt verwaltet und nicht als API-Parameter bereitgestellt. | Automatische Unterscheidung des ausgewählten Sprachpaares; Überprüfung im Original- und übersetzten Text | 60 Sprachen, zweisprachige Untertitel, übersetzte Sprachausgabe | Übersetzungsprotokoll, Transkript und Zusammenfassung der KI-Besprechung | Einzelpersonen und Teams, die in Echtzeit sprachübergreifend kommunizieren müssen, ohne eine App entwickeln zu müssen. |
| Deepgram | Streaming-Sprache-zu-Text-API | Zwischenergebnisse können aktiviert werden | Zeigt Zwischen-/Endergebnisse, Endpunkte, Ereignisse am Ende der Sprachausgabe, Steuerung des Äußerungsendes und manuelle Finalisierung an. | Diarisierungs- und Mehrkanaloptionen hängen von der Konfiguration/dem Modell ab. | Streaming-Sprach- und Modelloptionen; die Übersetzung ist eine separate Workflow-Entscheidung. | Der Kunde muss Speicher, Bearbeitungsfunktionen, Berechtigungen, Zusammenfassungen und eine Benutzeroberfläche erstellen. | Entwickler, die Sprachagenten, Untertitel, Anrufanalyse oder benutzerdefinierte Transkriptionsprodukte erstellen |
| AssemblyAI | Streaming-Sprache-zu-Text-API | Teiltranskripte, die über eine Streaming-Verbindung zurückgegeben wurden | Intelligente Endpunktbestimmung und unveränderliche finalisierte Transkripte; modellspezifisches Verhalten gilt | Streaming-Diarisierung und Sprecherrevisionsereignisse sind in unterstützten Modellen verfügbar. | Das mehrsprachige Streaming-Modell unterstützt einen veröffentlichten Sprachsatz | Der Kunde erstellt die fertige Anwendung und den Datensatzlebenszyklus. | Produktteams, die Streaming-Erkennung mit Diarisierung und nachgelagerter Intelligenz benötigen |
| Soniox | Echtzeit-Sprach-KI-API | Nicht-finaler Token-Stream mit geringer Latenz | Final-Token-Flags, manuelle Finalisierung, Token-Zeitstempel und Verarbeitungsfortschritt | Optionale Lautsprecherdurchführung | Echtzeit-Transkription und -Übersetzung in mehreren Sprachen durch API-Konfiguration | Der Kunde entwickelt Schnittstellen, Persistenz, Überprüfung und Governance. | Entwickler, die mehrsprachige Meetings, Übertragungen, Assistenten oder Sprachschnittstellen erstellen |
Die Funktionen wurden am 3. Oktober 2026 anhand der offiziellen Produktdokumentation überprüft. Modelle, Sprachen, Beschränkungen und Preise können sich ändern.
Die Tabelle listet keinen eindeutigen Gewinner auf. Sie unterscheidet zwei Kaufentscheidungen: ein Produkt um eine Streaming-API herum entwickeln oder einen fertigen Workflow nutzen. Der beste Echtzeit-Sprache-zu-Text-Umwandlung Der Weg hängt davon ab, wer für die Audioaufnahme, das Interface-Design, die Korrekturen, die Speicherung und den Support verantwortlich ist.
Route 1: Transync AI verwenden, wenn Sprache sprachübergreifend verwendet werden muss
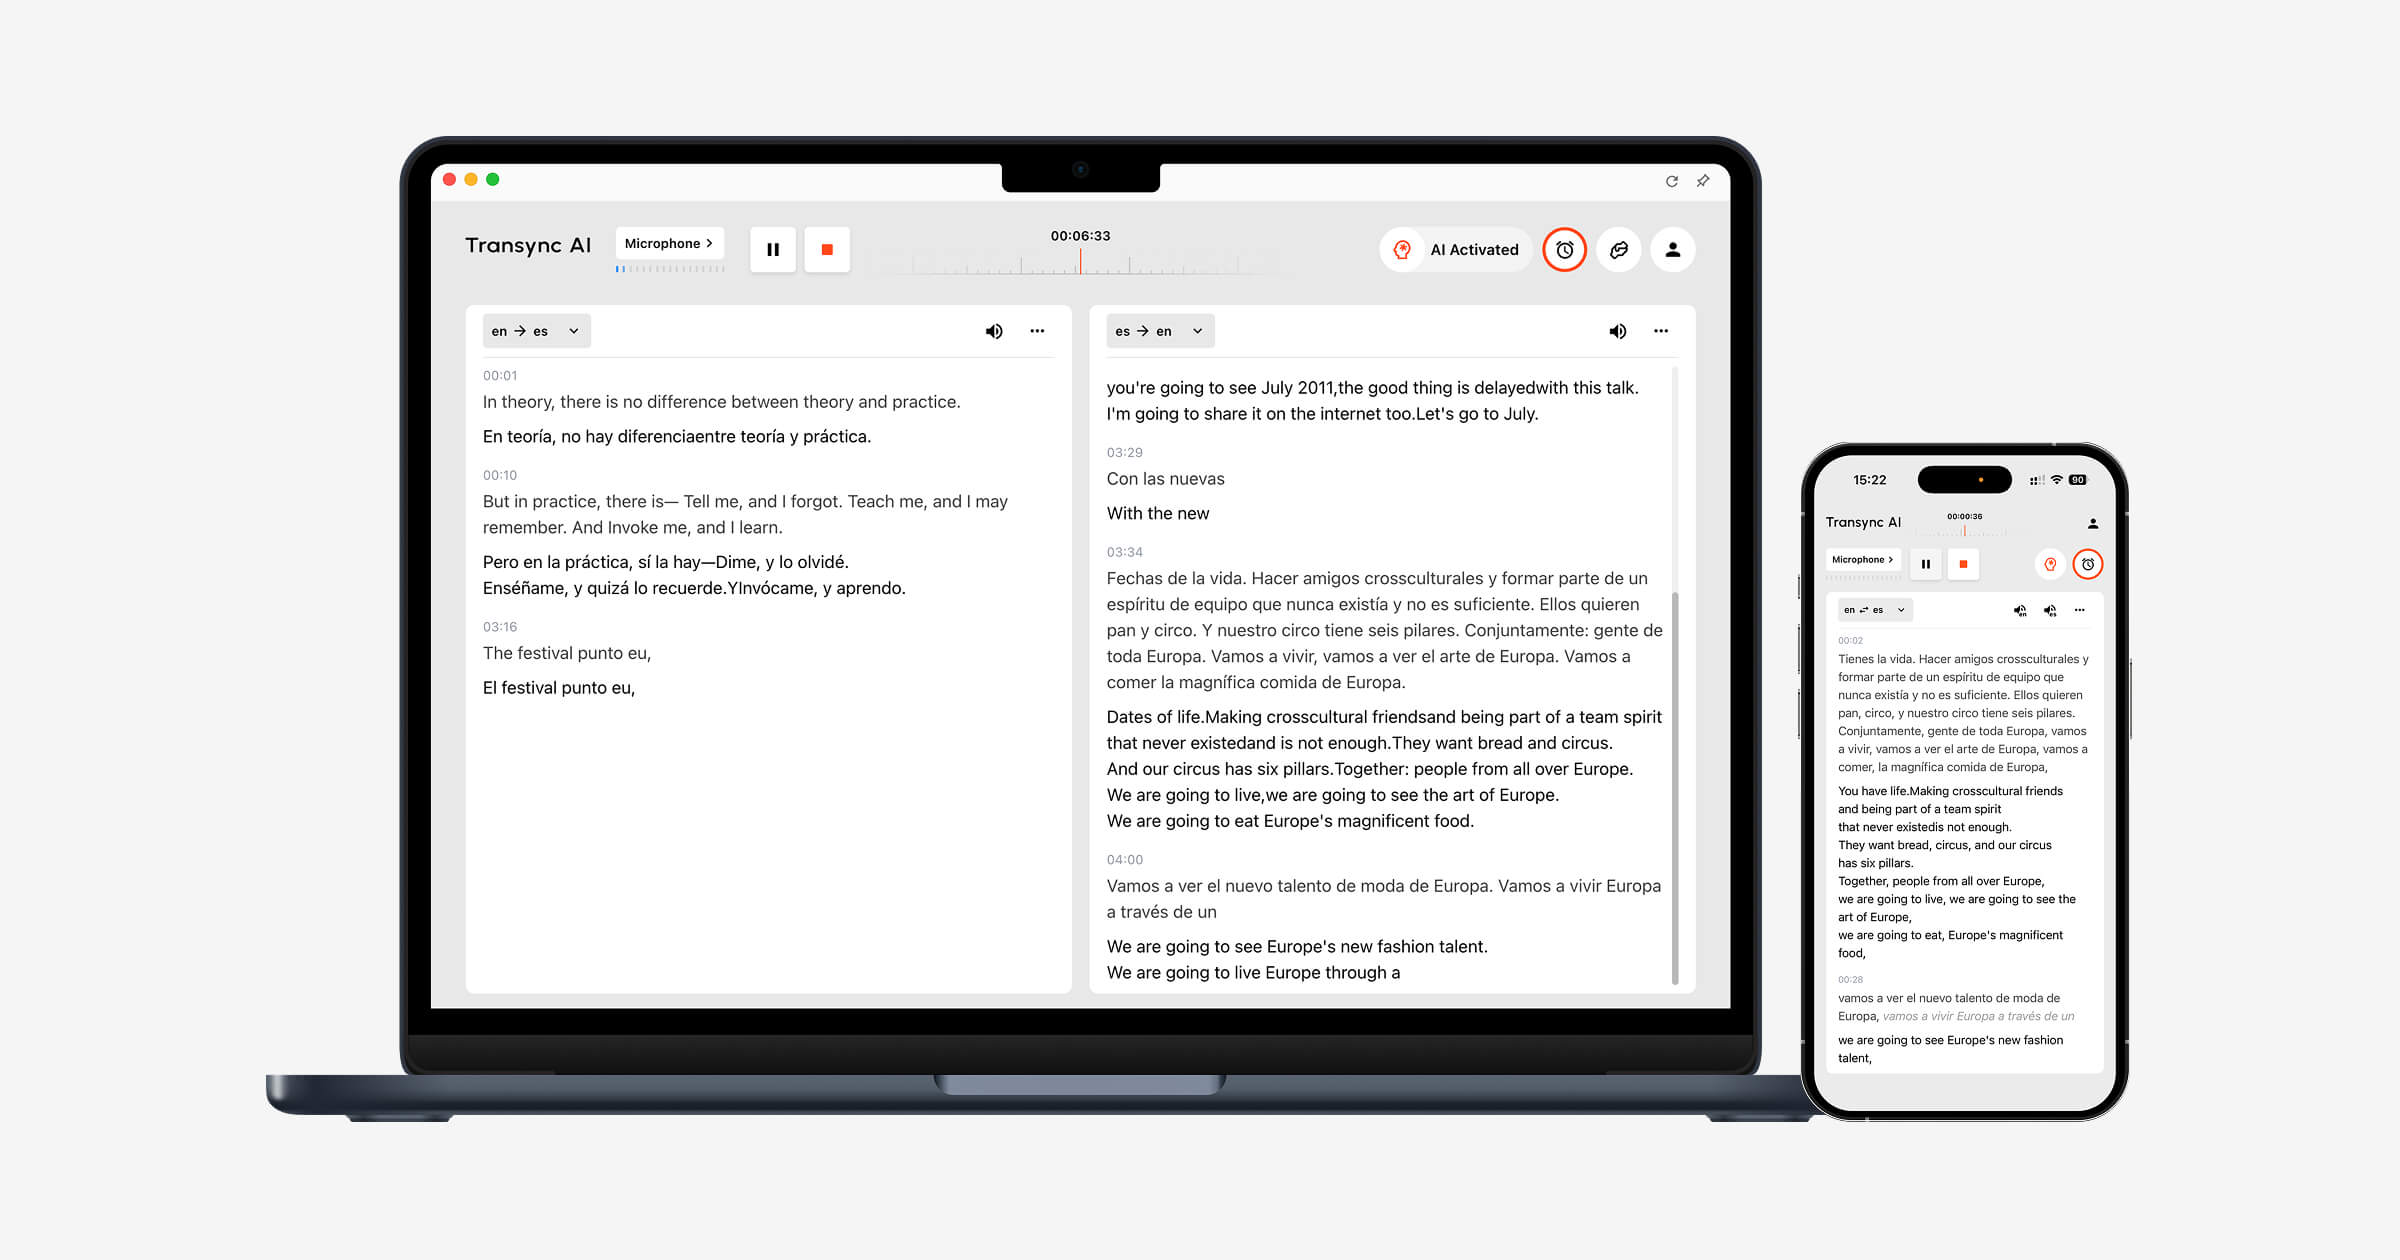
Transync AI Es wird nicht als universelle Spracherkennungs-API verkauft. Es ist ein sofort einsatzbereites Produkt für Meetings und Gespräche, das Spracherkennung mit Übersetzung kombiniert. Echtzeit-Übersetzungsworkflow Unterstützt 60 Sprachen und zeigt den Originaltext neben dem übersetzten Text an, was den Benutzern hilft, Erkennungsfehler von Übersetzungsfehlern zu unterscheiden.
Für Online-Anrufe gilt Folgendes: Live-Meeting-Übersetzung kann über den ausgewählten Mikrofon- oder Computer-Audio-Pfad mit verschiedenen Konferenzumgebungen zusammenarbeiten. Bild-in-Bild-Untertitel Der zweisprachige Text soll oberhalb der unterstützten Anwendungen sichtbar bleiben, anstatt den Benutzer zu zwingen, einen separaten Transkript-Tab anzuzeigen.
Vor einem Anruf, Schlüsselwörter und Kontext Namen, Akronyme, Produktbegriffe und Hintergrundinformationen können vorbereitet werden. Nach der Sitzung werden im Transkript sowohl der Originaltext als auch die Übersetzung gespeichert. KI-Besprechungsnotizen Es können Zusammenfassungen und Aktionspunkte erstellt werden. Laut dem aktuellen Protokollleitfaden können Besprechungszusammenfassungen in 55 Sprachen generiert werden.
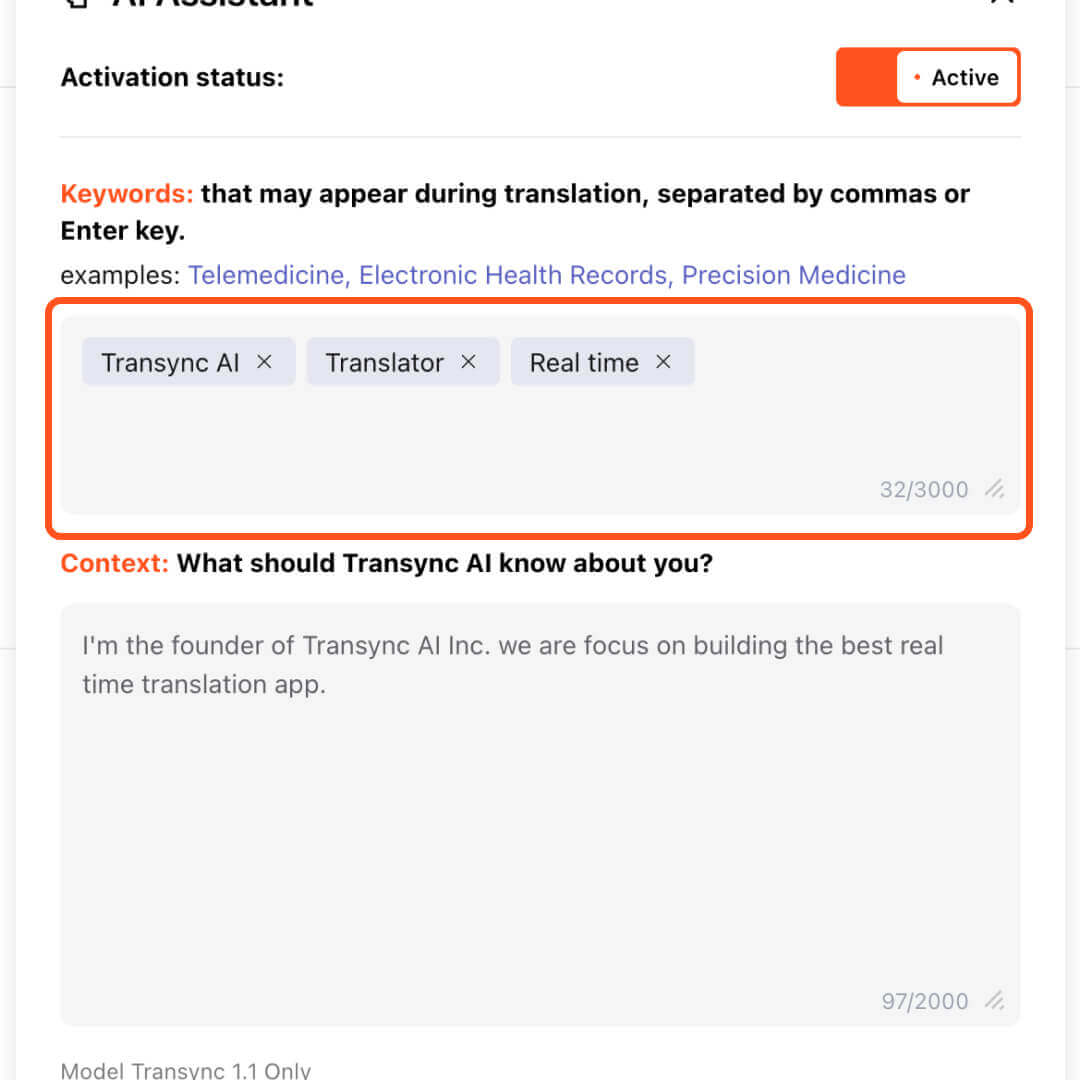
Die Transync AI-Benutzeroberfläche hebt das Aktivierungsfeld des KI-Assistenten mit den Schlüsselwörtern ‘Transync AI’, ‘Übersetzer’ und ‘Echtzeit’ hervor und zeigt, wie man benutzerdefinierte Schlüsselwörter für genaue Übersetzungen eingibt.
Testen Sie Transync AI kostenlos
Wählen Transync AI Wenn das Geschäftsziel darin besteht, sprachübergreifend zu verstehen und zu reagieren, ist eine Streaming-API die richtige Wahl. Entscheiden Sie sich stattdessen für eine Streaming-API, wenn das Team einen eigenen Sprachagenten, eine Anrufanalyseplattform, ein Produkt für Barrierefreiheit oder eine eingebettete Transkriptionsschnittstelle entwickelt.
Die Einschränkung ist wichtig: Transync AI Es handelt sich nicht um eine generische Offline-Diktier-Engine oder einen Entwickler-STT-Endpunkt. Audio-Routing, Netzwerkqualität, Sprachpaare, Mikrofone und die Fernübertragung sollten vor einem wichtigen Meeting getestet werden.
Route 2: Deepgram verwenden, wenn die Abbiegezeit Teil des Produkts ist
Deepgram Die Dokumentation ist für Entwickler besonders aufschlussreich, da sie Zwischenergebnisse, finalisierte Segmente, erkannte Sprachendpunkte und Äußerungsendeereignisse trennt. Diese Trennung ermöglicht es einer Anwendung, zu entscheiden, wann Text angezeigt, stabiler Text angehängt oder eine Reaktion ausgelöst werden soll.
Verwenden Deepgram Wenn das Produktteam das Gesprächsverhalten anpassen muss, anstatt eine feste Untertitelschnittstelle zu akzeptieren, bleibt es weiterhin für Audioübertragung, Zustandsverwaltung, Teiltextdarstellung, Speicherung, Authentifizierung, Berechtigungen, Korrekturen und die finale Benutzererfahrung verantwortlich.
Ein häufiger Implementierungsfehler besteht darin, nur die letzte Antwort zu speichern oder lediglich auf das Ende der Sprachausgabe zu warten. Offizielle Richtlinien erklären, dass eine längere Äußerung mehrere finalisierte Transkriptsegmente vor dem erkannten Ende der Sprachausgabe enthalten kann. Die Anwendung muss die letzten Segmente korrekt zusammenfügen.
Route 3: AssemblyAI verwenden, wenn Sprecherkennzeichnungen beim Streaming wichtig sind
AssemblyAI Das Modell bietet Streaming-Modelle mit Teil- und Endtranskripten, Endpunktinformationen, Schlüsselbegriffsvorschlägen, Wortzeitstempeln und unterstützten Sprecherdiarisierungsmodi. Die Dokumentation beschreibt außerdem Sprecherkorrekturen: Das Modell kann frühere Sprecherzuordnungen korrigieren, sobald es weitere Informationen sammelt.
Entdecken Sie AssemblyAI Streaming
Dieses Änderungsverhalten ist in Live-Oberflächen von Bedeutung. Wenn eine Anwendung “Sprecher A” zu früh als permanent festlegt, erreichen spätere Korrekturen möglicherweise nie den gespeicherten Datensatz. Die Benutzeroberfläche benötigt daher eine durchdachte Strategie für ausstehende Kennzeichnungen und Änderungen.
Wählen AssemblyAI Wenn sprecherorientiertes Streaming und Steuerung auf Anwendungsebene wichtig sind, sollten Sie das genaue Modell, die Sprachunterstützung, das Dialerisierungsverhalten, die medizinischen Optionen und die Datenanforderungen für die geplante Bereitstellung bestätigen; die Funktionen variieren je nach Streaming-Modell.
Route 4: Soniox für mehrsprachige Streaming-APIs nutzen
Soniox Es kombiniert Echtzeit-Transkription und -Übersetzung über seine WebSocket-API. Die aktuelle Schnittstelle unterstützt Sprachhinweise, Kontextanpassung, Sprecherdiarisierung, Übersetzungskonfiguration, Token-basierte Zeitstempel, Konfidenzintervalle, Finalität und Sprachinformationen.
Dies macht Soniox relevant, wenn Entwickler wollen Echtzeit-Sprache-zu-Text-Umwandlung und mehrsprachige Ausgabe innerhalb der eigenen Anwendung. Die Kontextkonfiguration kann bei Domänenbegriffen hilfreich sein, sollte aber mit einem festen Terminologieskript getestet werden, anstatt sie vom Funktionsnamen abzuleiten.
Wie bei den anderen APIs liefert der Dienst Bausteine. Der Käufer muss weiterhin Teilnehmerzugriff, Korrekturen, Aufbewahrung, Exporte, Zusammenfassungen, Administratorrechte, Überwachung, Fehlerbehebung und Support selbst implementieren.
Warum die Fehlerrate bei Wörtern nicht ausreicht
Die Fehlerrate misst Ersetzungen, Löschungen und Einfügungen im Vergleich zu einem Referenztranskript. Sie ist zwar nützlich, aber ein einzelner Durchschnittswert kann die wichtigsten Fehler verschleiern.
Vergleichen Sie diese beiden Fehler:
- “Wir können versenden Donnerstag” wird zu “Wir können versenden am Dienstag.”
- “Bitte öffnen Sie die Einstellungsfeld” wird zu “Bitte öffnen ein Einstellungsfeld.”
Beide können ähnlich gezählt werden, aber die erste ändert eine Verpflichtung. Erstellen Sie ein Fehlerprotokoll für:
- Namen und Sprecheridentität.
- Zahlen, Währungen, Daten und Einheiten.
- Verneinungen und Bedingungen.
- Produktnamen und Fachterminologie.
- Code-Switching und Sprachwechsel.
- Unterbrechungen und Selbstkorrekturen.
- Zeichensetzung, die die Bedeutung verändert.
Dann kommt der Zeitpunkt hinzu. Ein korrektes Wort, das nach der Entscheidungsfindung übermittelt wird, kann operativ falsch sein. Ein vorläufig korrigierter Fehler kann dennoch dazu geführt haben, dass ein Sprachagent oder Teilnehmer gehandelt hat.
Das Recht Echtzeit-Sprache-zu-Text-Umwandlung Die Bewertung berücksichtigt daher die Schwere des Sachfehlers, die Stabilität, das Timing der Redebeiträge und die Vortragsweise – und nicht nur die durchschnittliche Wortgenauigkeit.
Das Zwei-Minuten-Wahrheitsband
Verwenden Sie eine einzige Tonquelle, damit jeder Kandidat die gleiche Audioaufnahme erhält. Lassen Sie nicht zu, dass jeder Anbieter seine eigene Demo auswählt.
Skript
- “Hallo, ich bin Niamh O'Rourke von Aster-Q.”
- “Die Referenznummer lautet BX-417, nicht BX-471.”
- “Der Umsatz betrug 15,05 Millionen US-Dollar, ein Anstieg um 13,6 Prozent.”
- “Verlängern Sie den Vertrag nur, wenn die Servicevereinbarung unterzeichnet ist.”
- “Versenden Sie am Donnerstag fünfzehn – Entschuldigung, fünfzig – Einheiten.”
- “Die API nutzt WebSocket-Streaming und einen 300-Millisekunden-Endpunkt.”
- Führe mitten in einem Bedingungssatz eine Pause von 700 Millisekunden ein.
- Lassen Sie eine zweite Person unterbrechen und kehren Sie dann zum ersten Sprecher zurück.
- Fügen Sie einen Satz in der geforderten zweiten Sprache hinzu.
- Beende den Satz mit einem leisen Satz, während das Klappern einer Tastatur zu hören ist.
Erfassungsblatt
| Messung | Wie man es aufnimmt | Die Bedingung muss vor dem Testen definiert werden. |
|---|---|---|
| Zeit für die erste Nachricht | Audio-Start zur ersten nichtleeren Hypothese | Basierend auf dem Bedürfnis des Nutzers nach visuellem Feedback |
| Zeit bis zu stabilem Text | Letztes gesprochenes Wort zum endgültigen, unveränderlichen Text | Schnell genug, dass die Leute nicht auf Änderungen reagieren. |
| Abbiegeverzögerung | Ende der beabsichtigten Umleitung zum Endpunktereignis oder Antwortauslöser | Unterbricht keine normalen Pausen und reagiert nicht. |
| Revisionsanzahl | Anzahl der sichtbaren oder auf API-Ebene liegenden Hypothesenänderungen | Die Benutzeroberfläche bleibt lesbar und nachgelagerte Aktionen warten auf die endgültige Bestätigung. |
| Kritische Sachfehler | Namen, Zahlen, Negationen, Daten, Einheiten und Bedingungen | Keine unerkannten schwerwiegenden Fehler im Pilotprojekt |
| Wiederherstellung der Sprecherbezeichnung | Zeit und Korrektheit nach Unterbrechung | Das gespeicherte Transkript enthält die korrigierte Quellenangabe. |
| Workflow-Abschluss | Besprechungsende für durchsuchbaren/exportierbaren Datensatz oder Anwendungsaktion | Passt zum operativen Zeitplan |
Führen Sie zehn Versuche durch und berichten Sie anschließend, sofern die Stichprobe dies zulässt, über den Median, das 95. Perzentil und den schlechtesten beobachteten Wert. Ein einzelner fehlerfreier Versuch belegt keine Zuverlässigkeit.
Sieben Fehlerarten und die erste Reparatur
| Symptom | Wahrscheinliche Schicht | Erster nützlicher Check |
|---|---|---|
| Der Text erscheint verspätet ab dem ersten Wort. | Erfassung, Pufferung, Kodierung, Netzwerk oder Modell | Jeden Sprung messen; übergroße Audioblöcke reduzieren |
| Der Text erscheint schnell, wird aber häufig überarbeitet. | Verhalten der Zwischenhypothese | Warten Sie auf endgültige Ergebnisse, bevor Sie Aktionen auslösen; überarbeiten Sie die vorläufige Anzeige. |
| Das System blendet nachdenkliche Redner aus. | Endpunktschwellenwert- oder Sprachaktivitätserkennung | Testen Sie längere Pausen und optimieren Sie die Endpunktzuordnung, sofern verfügbar. |
| Das System wartet nach kurzen Befehlen zu lange. | Endpunktschwellenwert oder Anwendungsumschaltlogik | Testen Sie kürzere Schwellenwerte oder explizite Abbiegekontrollen. |
| Namen und Codes schlagen wiederholt fehl. | Akustische Mehrdeutigkeit und fehlender Domänenkontext | Fügen Sie Schlüsselbegriffe/Kontext hinzu und verbessern Sie die Mikrofonqualität. |
| Die Lautsprecherbeschriftungen ändern sich nach der Anzeige | Streaming-Diarisierung überarbeitet Cluster | Unterstützung für ausstehende Labels und Anwendung von Revisionsereignissen auf den Datensatz |
| Die Abschrift wird schnell erstellt, ist aber anschließend unbrauchbar. | Fehlender Produkt-Workflow | Fügen Sie Korrektur-, Speicher-, Such-, Berechtigungs-, Export- und Löschfunktionen hinzu – oder wählen Sie eine fertige App. |
Fehlerbehebung Echtzeit-Sprache-zu-Text-Umwandlung von links nach rechts. Das Ersetzen des Modells behebt weder einen stummgeschalteten Eingang noch eine falsche Abtastrate oder eine Benutzeroberfläche, die vorläufigen Text als endgültig speichert.
Wenn die Umwandlung von Sprache in Text nicht die endgültige Aufgabe ist
Die Transkription beantwortet die Frage: “Welche Wörter wurden erkannt?” Die Übersetzung beantwortet die Frage: “Was bedeuten diese Wörter in einer anderen Sprache?” Ein Besprechungsergebnis muss außerdem die Frage beantworten: “Kann die andere Person die Entscheidung verstehen, darauf reagieren und sie später nachvollziehen?”
Wenn alle dieselbe Sprache sprechen und barrierefreie Untertitel, Diktierfunktionen, Suchfunktionen oder Analysen benötigen, kann eine spezielle STT-API oder ein Transkriptionsprodukt ausreichend sein. Verwenden die Teilnehmer unterschiedliche Sprachen, benötigt der Workflow zusätzliche Steuerungsmöglichkeiten.
- Der Quelltext ist neben der Übersetzung sichtbar.
- Sprachauswahl oder automatische Sprachverarbeitung.
- Vorbereitung von Terminologie und Kontext.
- Der während des Gesprächs übermittelte Text in der Zielsprache.
- Eine optionale Sprachausgabe ist verfügbar, wenn das Vorlesen unpraktisch ist.
- Aufzeichnungen und Notizen, die die mehrsprachige Diskussion bewahren.
Dies ist der Punkt, an dem Echtzeit-Sprache-zu-Text-Umwandlung wird zu einem Bestandteil des größeren Transync AI eher der Arbeitsablauf als das Endprodukt.
FAQ zur Echtzeit-Sprache-zu-Text-Umwandlung
Was ist Echtzeit-Spracherkennung?
Echtzeit-Sprache-zu-Text-Umwandlung Das System wandelt Audiostreams während der Sprachausgabe in vorläufigen und endgültigen Text um. Es kann anfängliche Annahmen anpassen, sobald es mehr Kontext erhält, das Ende eines Redebeitrags erkennt, Satzzeichen einfügt oder die Sprecherzuordnung verbessert.
Ab welcher Verzögerung zählt eine Verzögerung als Echtzeit?
Es gibt keinen einheitlichen Schwellenwert. Gemessen werden die Zeit bis zum ersten Text, dem stabilen Text, dem Abschluss des Gesprächs und dem nutzbaren Workflow-Ergebnis. Ein Untertitelleser, ein Sprachagent, ein Meeting-Teilnehmer und ein Prüfer nach dem Gespräch haben unterschiedliche akzeptable Verzögerungen.
Warum ändert sich der Live-Text ständig?
Streaming-Erkennungssysteme veröffentlichen Teilhypothesen, bevor ein Satz vollständig ist. Spätere Audioaufnahmen können die wahrscheinlichste Formulierung, Zeichensetzung, Sprache oder den Sprecher verändern. Anwendungen sollten vorläufige Ergebnisse vom endgültigen Text unterscheiden.
Ist Echtzeit-Spracherkennung dasselbe wie Live-Übersetzung?
Nein. Die Spracherkennung erkennt gesprochene Wörter in der Ausgangssprache. Die Live-Übersetzung fügt eine weitere Sprachtransformation hinzu und kann auch die übersetzte Stimme ergänzen. Transync AI Kombiniert Spracherkennung und Übersetzung für mehrsprachige Konversationen.
Welche API eignet sich am besten für die Echtzeit-Spracherkennung?
Es gibt keinen eindeutigen Gewinner. Deepgram bietet detaillierte Endpunkt- und Ergebnisstatussteuerung, AssemblyAI bietet unterstütztes Streaming-Diarisierungs- und Revisionsverhalten, und Soniox Kombiniert mehrsprachige Transkriptions- und Übersetzungsoptionen. Testen Sie jede Option mit identischem Audiomaterial und den exakten Produktanforderungen.
Kann die Echtzeit-Spracherkennung Sprecher identifizieren?
Einige Modelle unterstützen Diarisierung oder Mehrkanal-Eingang, die Beschriftungen sind jedoch möglicherweise vorläufig und können sich mit zunehmendem Audiomaterial ändern. Testen Sie Unterbrechungen, ähnliche Stimmen, Gerätewechsel und Korrekturen gespeicherter Beschriftungen.
Was sollte ein Unternehmen zuerst testen?
Beginnen Sie mit der eigentlichen Audioaufnahme und einem zweiminütigen Skript, das Namen, Zahlen, Negationen, Korrekturen, Pausen, Unterbrechungen, Fachbegriffe und die benötigten Sprachen enthält. Messen Sie alle vier Uhren und überprüfen Sie die gespeicherte Aufzeichnung.
Endgültiges Urteil
Der schnellste Echtzeit-Sprache-zu-Text-Umwandlung Das System ist nicht unbedingt dasjenige, das das erste Wort als erstes anzeigt. Ein zuverlässiges System gleicht vier Uhren ab:
erster Text → stabiler Text → abgeschlossener Zug → nutzbarer Datensatz
Wählen Sie eine Streaming-API, wenn Entwickler Endpunkte, Teilergebnisse, Sprecherkorrekturen und das Anwendungsverhalten steuern müssen. Entscheiden Sie sich für ein fertiges Meeting-Produkt, wenn das Team den kompletten Prozess von Audio über Untertitel und Übersetzung bis hin zu Protokollen und Notizen benötigt, ohne die entsprechende Infrastruktur selbst aufbauen zu müssen.
Am wichtigsten ist es, die tatsächliche Eingabe und die tatsächliche Konsequenz zu testen. Messen Sie das erscheinende Wort, das sich ändernde Wort, den beendeten Handlungsverlauf und die Aufzeichnung, der man später vertrauen wird.