リアルタイム音声認識は、単なる高速字幕以上のものです。選択する前に、隠れた4つの要素、修正機能、話者対応、多言語会議への適合性を評価しましょう。.
リアルタイム音声認識はデモでは素晴らしく見えるかもしれませんが、実際の会話では失敗する可能性があります。最初の単語は300ミリ秒で表示されるかもしれませんが、文は2秒間も変化し続けるかもしれません。話者ラベルが表示された後、修正されることもあります。洗練された文字起こしがすぐに用意されても、決定を変える否定表現が省略されている可能性があります。.
だからこそ、「どれくらい速いのか?」という最初の質問は間違っているのです。有益な評価には、最初のテキスト取得までの時間、安定したテキスト取得までの時間、ターン完了までの時間、そして使用可能なレコード取得までの時間の4つの指標が必要です。それぞれの指標は、異なる運用上のニーズに応えるものです。.
この記事では リアルタイム音声テキスト変換 視覚的な効果ではなく、測定可能なパイプラインとして捉えます。専門的なストリーミングAPIとすぐに使える多言語対応の会議製品を比較し、再現可能なテストスクリプトを提供するとともに、参加者が翻訳、音声出力、またはメモを必要とする場合など、文字起こしだけでは不十分な状況を説明します。.
60秒で答える
リアルタイム音声テキスト変換 音声ストリームをリアルタイムでテキストに変換し、話者が話している最中にテキスト化します。表示されるテキストは多くの場合暫定的なものです。モデルがより多くのコンテキストを取得したり、ポーズを検出したり、話者を特定したり、句読点を適用したり、発話を完了したりするにつれて、初期の単語が修正されることがあります。.
4つの時計は以下の通りです。
- 最初のテキストの遅延: 仮説が現れるまでどれくらいかかるだろうか?
- 安定性遅延: 言葉が変わらなくなるまで、あとどれくらいかかるだろうか?
- ターン終了遅延: システムが発話ターンまたは発話が終了したと判断するまで、どれくらいの時間がかかりますか?
- ワークフローの遅延: 文字起こしデータが検索、メモ、操作、翻訳、または申請への回答に利用できるようになるまで、どれくらい時間がかかりますか?
音声エージェントは、応答するタイミングを決定する必要があるため、発話の完了を優先する場合があります。アクセシビリティ字幕は、高速で読みやすい部分的なテキストを優先する場合があります。会議記録は、名前、番号、発言者の識別がより確実になれば、表示速度が多少遅くても許容される場合があります。多言語会議では、認識後にもう1つの段階が加わります。誰かが応答できるように、翻訳が十分早く提供される必要があります。.
リアルタイム音声認識は、常に変化する仮説である。
ライブ文字起こしは、1つのステップで作成されるものではありません。
マイクまたはシステムオーディオ → エンコードと伝送 → 音声検出 → 暫定認識 → 修正 → 最終化 → 話者ラベル付けとフォーマット → アプリケーションアクション
画面には通常、中央部分しか表示されません。そのため、よくある錯覚が生じます。テキストがすぐに表示されるため、ユーザーは結果が完成したと思い込んでしまうのです。しかし実際には、エンジンは単語の境界、句読点、言語、話者の特定などをまだ再検討している可能性があります。.
専門的なAPIは、この区別を明確にしている。. ディープグラム 中間結果と最終結果を別々に返します。ドキュメントには、暫定的なテキストは変更される可能性がある一方、最終化されたセグメントを追加して完全な発話を再構築する必要があると説明されています。別の音声終了信号は、システムがポーズなどの終了点を検出したことを示します。.
ソニオックス 永続的なストリーミング接続を介して、最終トークンと非最終トークン、タイムスタンプ、信頼度、言語情報、オプションの話し手ラベル、および処理の進捗状況を公開します。. アセンブリAI 同様に、サポートされているモデルでは、部分的な文字起こしと最終的な文字起こし、エンドポイントの設定、単語レベルのタイムスタンプ、キーワードのプロンプト表示、ストリーミング話者ダイアリゼーションを提供します。.
これらのコントロールは開発者にとって有用です。また、エンドユーザーが判断を下すべきでない理由も明らかにしています。 リアルタイム音声テキスト変換 最初に見える線だけで判断する。.
時計1:最初のテキストメッセージ送信までの時間
最初のクロックは、音声がシステムに到達した時点で開始され、最初の空でない仮説がアプリケーションで可視化または利用可能になった時点で停止します。.
この測定には、モデル推論以上のものが含まれます。
- マイクまたは会議音声の録音。.
- バッファサイズとオーディオチャンキング。.
- リサンプリングまたはエンコード。.
- ネットワークトランスポート。.
- サーバー処理中。.
- 帰りの交通手段。.
- インターフェースのレンダリング。.
測定 リアルタイム音声テキスト変換 APIダッシュボードからではなく、実際のユーザーデバイスから取得したデータです。ベンダーのサーバー側の数値には、音声バッファリング、クライアントネットワーク、ブラウザのレンダリング、および会議プラットフォーム自体の遅延は含まれません。.
迅速な初期テキスト表示は、システムがユーザーの声を聞き取っているという安心感をユーザーに求める場合に有効です。しかし、インターフェースが不安定な単語に基づいてユーザーに何らかの行動を促すような場合には、その有用性は低下します。優れたキャプションデザインは、仮のテキストを視覚的に区別しつつ、読みにくくすることはありません。.
最初の時計をテストする方法
同じ音声と画面を毎秒60フレームで録画します。一度拍手をしてから、「更新は承認されませんでした」と発言します。波形または拍手が入力に到達したフレームと、最初のテキストが表示されたフレームをマークします。これを10回繰り返し、最速の結果ではなく、中央値と最遅の結果を報告します。.
テスト リアルタイム音声テキスト変換 通常のWi-Fi環境、混雑したネットワーク、ノイズ抑制機能を搭載したノートパソコン、実際のヘッドセットや室内マイクなど、様々な条件下での性能が異なります。通常の負荷がかかると最初のテキスト入力速度が失われる場合、それは信頼できる製品機能とは言えません。.
時計2:安定したテキストの時間
2つ目の時計は、テキストの範囲が変化しなくなった時点で止まります。これは、多くのマーケティングデモで隠されている時計です。.
次のフレーズを考えてみましょう。
“「木曜日に15機――いや、50機を出荷してください。」”
表示は「出荷15」、次に「出荷50」と進み、その後、句読点付きの修正が表示される場合があります。最初のバージョンはすぐに届きましたが、注文にコピーしても安全なのは最終バージョンのみです。.
下流システムが早すぎる反応を起こす可能性があるため、安定性が重要です。ライブサマリー、セールスアシスタント、コンプライアンストリガー、翻訳レイヤー、または音声エージェントは、暫定エラーを継承する可能性があります。 リアルタイム音声テキスト変換 ワークフローにおいては、開発者は部分的な更新をすべて完了したステートメントとして扱うのではなく、エンジンの最終性シグナルを処理する必要がある。.
修正距離を測定する。遅延だけでなく
テスト文ごとに、以下をログに記録します。
- 暫定版の数。.
- 置換または削除された単語数。.
- 最後に発話された言葉と、安定したテキストが表示されるまでの時間。.
- 最終的に保存されたトランスクリプトが、安定した表示と一致するかどうか。.
- 下流のアクションが安定する前にトリガーされたかどうか。.
少し遅い リアルタイム音声テキスト変換 システムの改訂頻度を低くすれば、より安全性が高まる可能性がある。適切なバランスは、ユーザーが閲覧、音声入力、ソフトウェアの制御、交渉のいずれを行っているかによって異なる。.
時計3:ターン完了までの時間
言葉は最終的なものであっても、発話権は必ずしも最終決定ではありません。人は考えたり、息を整えたり、人物を探したり、割り込みを待ったりするために、一時的に言葉を止めます。システムが発話権の終了を早すぎるタイミングで判断すると、音声エージェントがユーザーの発言を遮ってしまう可能性があります。逆に、判断が遅すぎると、会話が応答性に欠けるように感じられます。.
エンドポイント方式では、通常、無音状態または音声活動を利用して、発話が終了したことを推測します。. ディープグラム ドキュメント構成可能なエンドポイントと個別の 最終版 そして スピーチ_最終 同州のガイドラインでは、短いしきい値は短いチャットボットの応答に適している一方、会話の間隔が長い場合は、応答が完了したとみなされるまでに数百ミリ秒かかる場合があると指摘している。.
すべての話し手に通用する普遍的な設定はありません。コールセンターの早口なスクリプト、ためらいがちな病歴、教室での講義、バイリンガルでの交渉などでは、それぞれ異なるポーズのパターンがあります。したがって、発話の終了は重要な要素となります。 リアルタイム音声テキスト変換 単なるAPI設定ではなく、測定基準です。.
躊躇テストを実行する
以下の4行を使用してください。
- “「私の口座番号は…4172です。」”
- “「もし配達日が金曜日のままなら、私も賛成です。」”
- “「服用量は15ミリグラム、いや、50ミリグラムだ。」”
- “「アナ、君は――」と言いかけたところで、別の話し手が口を挟んだ。.
誤ったターン終了、遅延エンドポイント、割り込み、および切り捨てられた単語をカウントします。アプリケーションがエンドポイントのしきい値を公開している場合にのみ、そのしきい値を調整します。製品が完成したアプリケーションの場合は、動作を観察し、タスクに適合しているかどうかを判断します。.
この時計は リアルタイム音声テキスト変換 単なる文字起こしではなく、会話工学へと発展する。.
時計4:使用可能な記録までの時間
4つ目の時計はチームにとって最も重要です。それは、次の行動を支えられる成果が得られた時点で終了します。.
“「使用可能」とは、次のような意味を持つ場合があります。
- 字幕はセッション中も読みやすい状態を維持します。.
- 話者は特定可能である。.
- 名前、数字、用語などは訂正可能です。.
- 完全な文字起こしをコピーまたはエクスポートできます。.
- この記録は検索可能で、利用許可が必要です。.
- 概要と対応項目が生成されます。.
- 原文と翻訳文はペアで表示されます。.
- 保持と削除は理解されている。.
システムは最初の3回の時計に勝っても、4回目に負けることがあります。生のストリーミングJSONは会議記録ではありません。消えてしまう高速な字幕は証拠になりません。追跡可能な文字起こしのない美しい要約は、認識エラーを隠蔽する可能性があります。これが理由です。 リアルタイム音声テキスト変換 調達部門は、完成したワークフローとストリーミングモデルの両方を測定する必要がある。.
リアルタイム音声テキスト変換 したがって、評価は生成時点ではなく、使用時点で行うべきである。参加者、レビュー担当者、開発者、管理者に、それぞれの視点から同じセッションをテストしてもらうよう依頼する。.
4つの時計で比較した4つのルート
| ツール | 製品タイプ | 最初のテキスト | 安定性および最終性制御 | スピーカーの操作 | 多言語対応 | 使用可能なレコードのワークフロー | 最適なフィット感 |
|---|---|---|---|---|---|---|---|
| Transync AI | すぐに使える会議翻訳アプリ | ライブバイリンガルディスプレイ | APIパラメータとして公開されるのではなく、製品によって管理される。 | 選択した言語ペアを自動的に識別し、原文と翻訳文の両方でレビューします。 | 60言語、バイリンガル字幕、翻訳音声 | 翻訳記録、議事録、およびAI会議の要約 | アプリを開発せずにリアルタイムの多言語コミュニケーションを必要とする個人やチーム |
| ディープグラム | ストリーミング音声テキスト変換API | 中間結果を有効にすることができます | 中間結果/最終結果、エンドポイント、音声終了イベント、発話終了制御、および手動による最終処理を公開します。 | ダイアリゼーションとマルチチャネルオプションは、構成/モデルによって異なります。 | ストリーミング言語とモデルのオプション。翻訳は別のワークフロー決定事項です。 | 顧客はストレージ、編集、権限、概要、およびUIを構築する必要があります | 音声エージェント、字幕、通話インテリジェンス、またはカスタム文字起こし製品を開発する開発者 |
| アセンブリAI | ストリーミング音声テキスト変換API | ストリーミング接続を通じて返された部分的な文字起こし | インテリジェントなエンドポイント設定と変更不可能な最終化されたトランスクリプト。モデル固有の動作が適用されます。 | ストリーミングダイアリゼーションと話者修正イベントは、サポートされているモデルで利用可能です。 | 多言語ストリーミングモデルは、公開された言語セットをサポートします。 | 顧客が完成したアプリケーションとレコードのライフサイクルを構築する | ストリーミング認識とダイアライゼーション、およびダウンストリームインテリジェンスを必要とする製品チーム |
| ソニオックス | リアルタイム音声AI API | 最終トークン以外のトークンは低遅延でストリーム配信されます | 最終トークンフラグ、手動ファイナライゼーション、トークンタイムスタンプ、および処理進捗状況 | オプションのスピーカーダイアライゼーション | API設定によるリアルタイム多言語文字起こしと翻訳 | 顧客はインターフェース、永続性、レビュー、ガバナンスを構築する | 多言語対応の会議、放送、アシスタント、音声インターフェースを開発する開発者 |
機能は2026年10月3日に公式製品ドキュメントに基づいて確認されました。モデル、言語、制限事項、価格は変更される場合があります。.
この表は、万能の勝者を一つだけランク付けするものではありません。ストリーミングAPIを中心に製品を構築するか、完成済みのワークフローを使用するかという、2つの購入決定を分けています。 リアルタイム音声テキスト変換 ルートは、音声キャプチャ、インターフェース設計、補正、ストレージ、およびサポートの所有者によって異なります。.
ルート1:音声が複数の言語にまたがる必要がある場合は、Transync AIを使用する
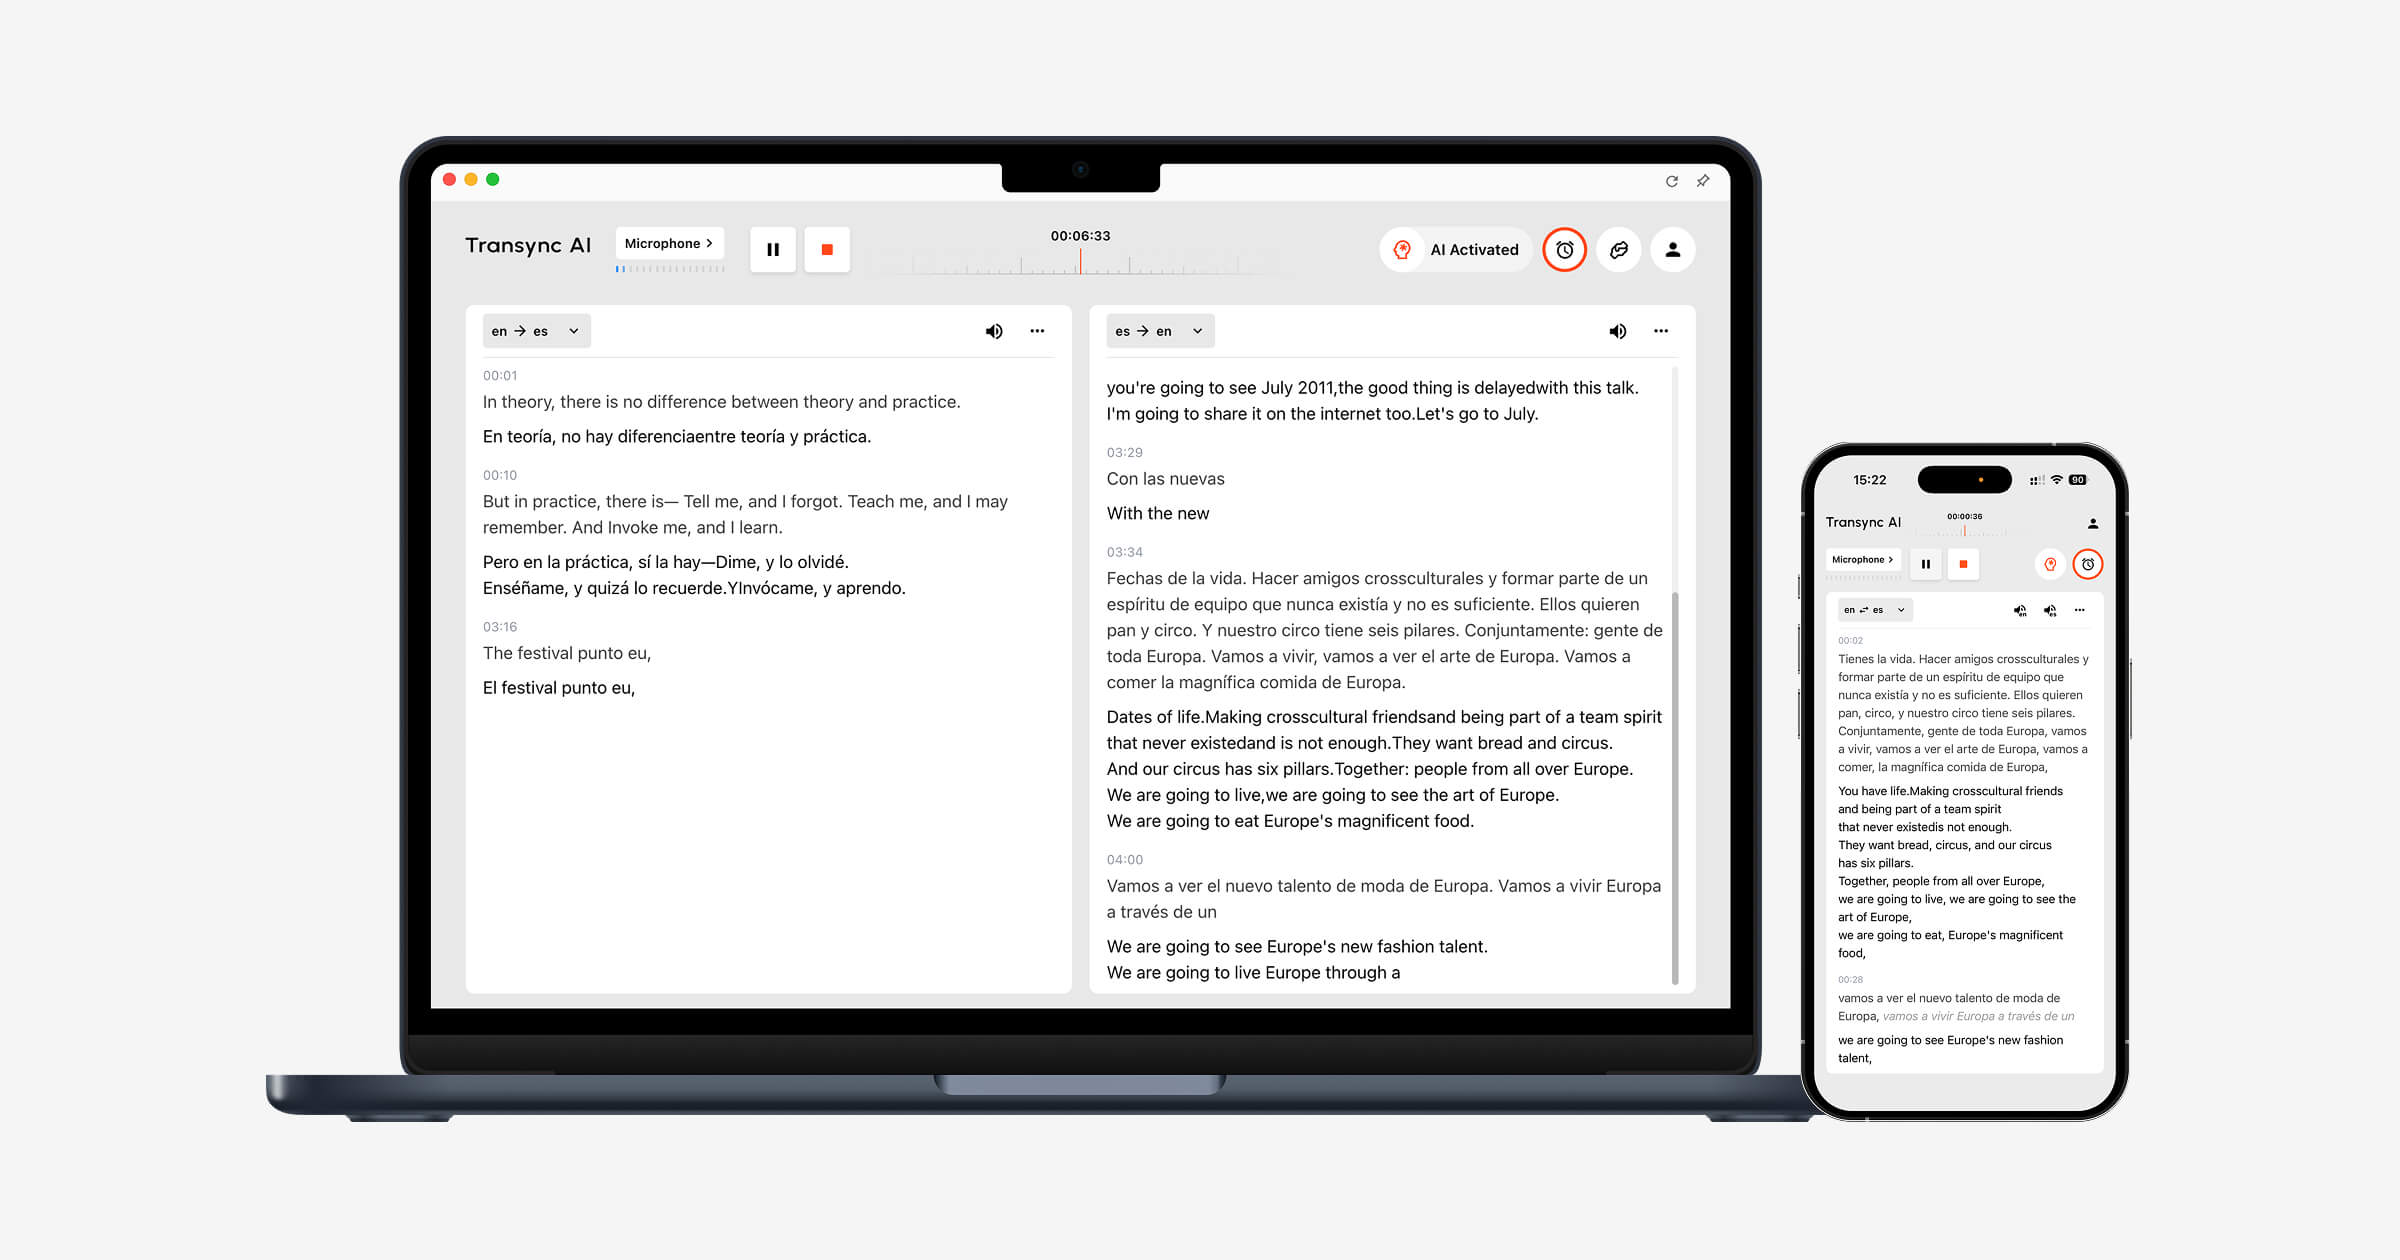
Transync AI 汎用音声テキスト変換APIとして販売されているものではありません。音声認識と翻訳を組み合わせた、すぐに使える会議・会話用製品です。 リアルタイム翻訳ワークフロー 60言語に対応し、翻訳されたテキストの横に元の音声を表示するため、ユーザーは認識エラーと翻訳エラーを区別しやすくなります。.
オンライン通話の場合、 ライブ会議翻訳 選択したマイクまたはコンピューターオーディオ経路を介して、さまざまな会議環境と連携して動作できます。. ピクチャーインピクチャー字幕 対応アプリケーションの上にバイリンガルテキストを表示したままにして、ユーザーに別のトランスクリプトタブを見させる必要がないようにします。.
電話の前に、, キーワードと背景 名前、頭字語、製品用語、背景などを準備できます。セッション後、トランスクリプトには元のテキストと翻訳されたテキストが保存されます。 AI会議メモ 要約とアクションアイテムを生成できます。現在の議事録ガイドによると、会議の要約は55言語で生成可能です。.
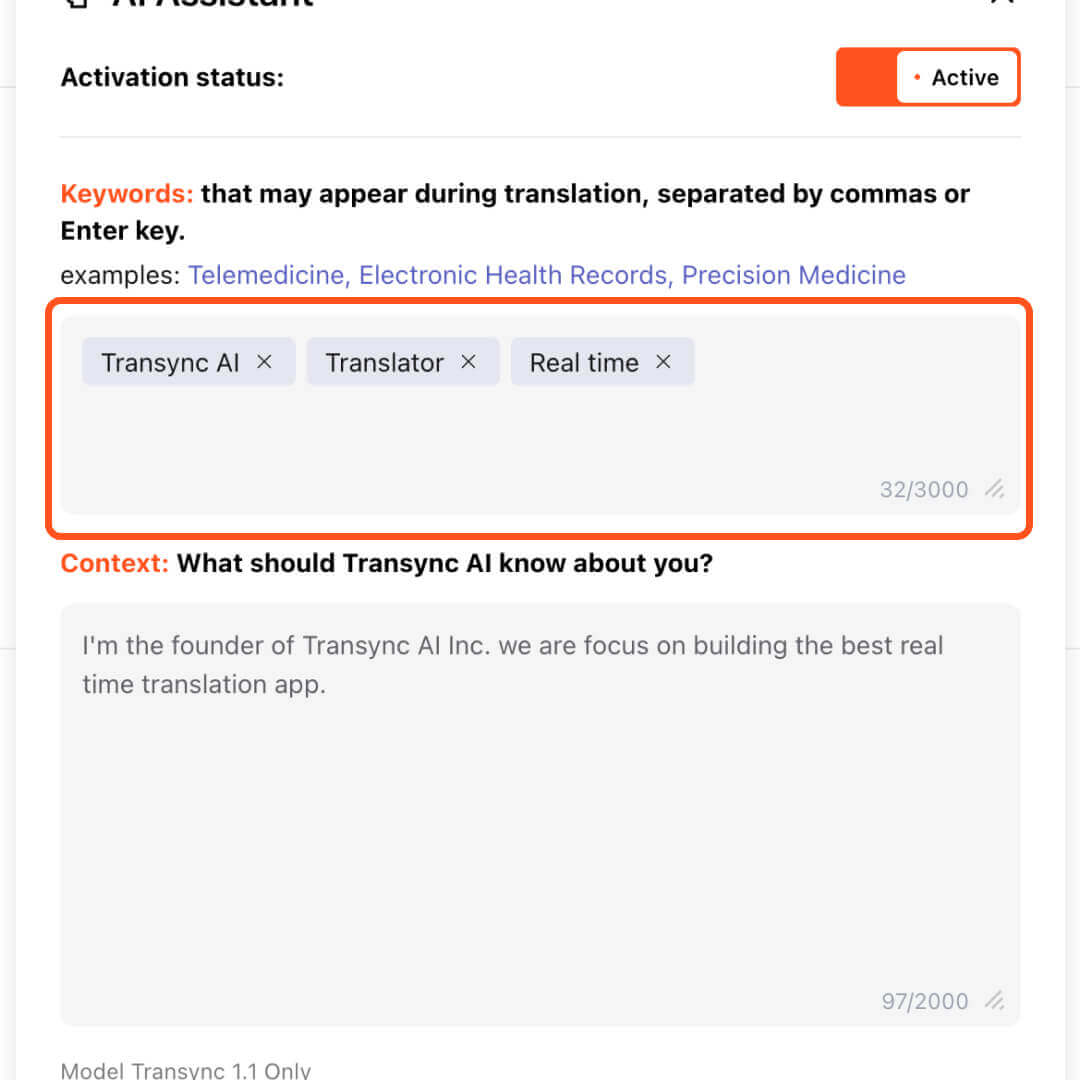
Transync AIのインターフェースでは、「Transync AI」、「翻訳者」、「リアルタイム」といったキーワードでAIアシスタントの起動パネルが強調表示され、正確な翻訳のためにカスタムキーワードを入力する方法が示されています。.
選ぶ Transync AI ビジネス上の成果が、言語を超えた理解と対応である場合は、ストリーミングAPIを選択してください。チームが独自の音声エージェント、通話分析プラットフォーム、アクセシビリティ製品、または組み込みの文字起こしインターフェースを構築している場合は、ストリーミングAPIを選択してください。.
この制約は重要です。 Transync AI これは汎用的なオフライン音声認識エンジンや開発者向け音声認識エンドポイントではありません。重要な会議の前に、音声ルーティング、ネットワーク品質、言語ペア、マイク、リモート配信などをテストする必要があります。.
ルート2:ターンタイミングが製品の一部である場合は、Deepgramを使用する
ディープグラム このドキュメントは、中間結果、確定したセグメント、検出された音声エンドポイント、発話終了イベントを区別して記述しているため、開発者にとって特に参考になります。この区別により、アプリケーションはテキストを表示するタイミング、確定したテキストを追加するタイミング、または応答をトリガーするタイミングを決定できます。.
使用 ディープグラム 製品チームが固定の字幕インターフェースを受け入れるのではなく、会話の動作を調整する必要がある場合。音声伝送、状態管理、部分テキストレンダリング、ストレージ、認証、権限、修正、および最終的なユーザーエクスペリエンスは、引き続きチームが担当します。.
よくある実装ミスとして、最新の応答のみを保存したり、音声終了イベントのみを待ったりすることが挙げられます。公式ガイドラインでは、長い発話には、音声終了が検出される前に複数の終了済み文字起こしセグメントが含まれる可能性があると説明されています。アプリケーションは、これらの終了セグメントを正しく連結する必要があります。.
ルート3:ストリーミングにおける話者ラベルが重要な場合はAssemblyAIを使用する
アセンブリAI ストリーミングモデルには、部分的な文字起こしと最終的な文字起こし、エンドポイント設定、キーワードプロンプト、単語タイムスタンプ、およびサポートされている話者ダイアライゼーションモードが提供されます。ドキュメントには、話者修正イベントについても説明されています。モデルは、より多くの証拠を収集するにつれて、以前の話者ラベルを修正することができます。.
ライブインターフェースにおいては、こうした修正動作が重要となる。アプリケーションが「話者A」を早々に確定してしまうと、後から修正した内容が保存されたレコードに反映されない可能性がある。ユーザーインターフェースには、保留中のラベルや修正に関する明確な戦略が必要である。.
選ぶ アセンブリAI 話者認識ストリーミングとアプリケーションレベルの制御が重要な場合。計画している展開について、正確なモデル、言語サポート、ダイアリゼーション動作、医療オプション、およびデータ要件を確認してください。機能はストリーミングモデルによって異なります。.
ルート4:多言語ストリーミングAPIにSonioxを使用する
ソニオックス WebSocket APIを介してリアルタイムの文字起こしと翻訳を統合します。現在のインターフェースは、言語ヒント、コンテキストのカスタマイズ、話者ダイアライゼーション、翻訳設定、トークンレベルのタイムスタンプ、信頼度、完了性、および言語情報をサポートしています。.
これにより ソニオックス 開発者が望むときに関連します リアルタイム音声テキスト変換 また、アプリケーション内での多言語出力にも対応しています。コンテキスト設定はドメイン用語の理解に役立ちますが、機能名から推測するのではなく、固定の用語スクリプトを使用してテストする必要があります。.
他のAPIと同様に、このサービスも構成要素を返します。購入者は、参加者アクセス、修正、データ保持、エクスポート、概要、管理者コントロール、モニタリング、エラー回復、およびサポートを別途作成する必要があります。.
単語誤り率だけでは不十分な理由
単語誤り率は、参照となる書き起こしと比較して、置換、削除、挿入の割合を測定する指標です。有用な指標ではありますが、単一の平均値では最も重要な誤りが見落とされてしまう可能性があります。.
この2つのエラーを比較してみましょう。
- “「 木曜日”「」は「私たちは出荷できます」になります 火曜日.”
- “「 設定パネル”」は「開いてください」になります 設定パネル.”
どちらも同様にカウントされる可能性がありますが、最初の変更はコミットメントです。以下のエラー台帳を作成します。
- 氏名および発言者の身元。.
- 数値、通貨、日付、単位。.
- 否定と条件。.
- 製品名および専門用語。.
- コードスイッチングと言語変更。.
- 中断と自己修正。.
- 意味を変える句読点。.
次に、タイミングを考慮します。決定後に正しい言葉が発せられたとしても、運用上は誤りである可能性があります。暫定的な誤りが後で修正されたとしても、音声エージェントや参加者が何らかの行動を起こしてしまう可能性があります。.
右 リアルタイム音声テキスト変換 したがって、このスコアは、単なる平均的な単語の正確さではなく、事実誤認の深刻度、安定性、発話タイミング、および表現方法を総合的に考慮したものである。.
2分間の真実テープ
録音ソースは1つだけ使用し、すべての候補者が同じ音声を受け取れるようにしてください。各ベンダーが独自のデモを選択できないようにしてください。.
スクリプト
- “「こんにちは、アスターQのニアム・オロークです。」”
- “「参照番号はBX-417であり、BX-471ではありません。」”
- “「売上高は1505万ドルで、13.6%増加しました。」”
- “サービスレベル契約書に署名しない限り、更新しないでください。”
- “「木曜日に15機――いや、50機を出荷してください。」”
- “「このAPIはWebSocketストリーミングと300ミリ秒のエンドポイントを使用しています。」”
- 条件文の途中で700ミリ秒間間を置く。.
- 二人目の人が発言を遮ったら、最初の発言者に戻る。.
- 指定された第二言語で一文を追加してください。.
- キーボードの音が聞こえる程度に、静かな一文で締めくくってください。.
キャプチャシート
| 測定 | 録音方法 | テスト前に定義する条件を渡します |
|---|---|---|
| 最初のテキストメッセージ送信時間 | 最初の空でない仮説の音声開始 | ユーザーの視覚的フィードバックへのニーズに基づいて |
| テキストが安定するまでの時間 | 最後に話された言葉から、変更されない最終テキストへ | 人々が改訂に対応できないほど速い |
| ターン終了遅延 | エンドポイントイベントまたは応答トリガーへの意図したターン終了 | 通常の休止を妨げたり、反応が鈍く感じたりすることはありません。 |
| 改訂回数 | 目に見える、またはAPIレベルの仮説変更の数 | インターフェースは読みやすく、後続の処理は最終結果を待つ。 |
| 重大な事実誤認 | 名前、数字、否定、日付、単位、条件 | パイロットテストでフラグ付けされていない重大なエラーはゼロ |
| 話者ラベルの復元 | 中断後の時間と正確性 | 保存された転写記録には、修正された帰属情報が反映されています。 |
| ワークフローの完了 | 検索/エクスポート可能なレコードまたはアプリケーションアクションの終了を会議する | 運用期限に適合する |
10回の試行を行い、サンプルが許す限り、中央値、95パーセンタイル値、および観測された最悪の結果を報告してください。1回の完璧な実行では信頼性は確立されません。.
7つの故障モードと最初の対処法
| 症状 | ありそうな層 | 最初の便利なチェック |
|---|---|---|
| テキストは最初の単語から遅れて表示されます | キャプチャ、バッファリング、エンコード、ネットワーク、またはモデル | 各ホップを測定し、大きすぎるオーディオチャンクを削減する |
| テキストはすぐに表示されるが、大幅に書き換えられる | 中間仮説の挙動 | 最終的な結果が出るまでアクションをトリガーしない。暫定表示を再設計する。 |
| システムが思慮深い発言者を遮断する | エンドポイントしきい値または音声アクティビティ検出 | より長い一時停止をテストし、可能な場合はエンドポイントを調整します。 |
| システムが短いコマンドの後に待機時間が長すぎる | エンドポイントしきい値またはアプリケーションターンロジック | より短いしきい値または明示的なターン終了制御をテストする |
| 名前とコードが繰り返し失敗します | 音響的曖昧性と欠落したドメインコンテキスト | キーワードや文脈を追加し、マイクの音質を改善します。 |
| スピーカーのラベルは表示後に変更されます | ストリーミングダイアリゼーションはクラスターを再編している | 保留中のラベルをサポートし、レコードに改訂イベントを適用します。 |
| 文字起こしは速いが、その後は使えない | 製品のワークフローが欠落しています | 修正、保存、検索、権限、エクスポート、削除を追加するか、完成済みのアプリを選択してください。 |
トラブルシューティング リアルタイム音声テキスト変換 左から右へ。モデルを交換しても、ミュートされた入力、不正確なサンプリングレート、または暫定的なテキストを最終版として保存するユーザーインターフェースの問題は解決されません。.
音声認識が最終作業ではない場合
文字起こしは「どの単語が認識されたか?」という問いに答え、翻訳は「それらの単語は別の言語でどのような意味を持つか?」という問いに答える。会議の成果物は、さらに「相手は後で決定内容を理解し、応答し、確認できるか?」という問いにも答えなければならない。“
参加者全員が同じ言語を話し、アクセシビリティ字幕、音声入力、検索、分析機能が必要な場合は、専用の音声認識APIまたは文字起こし製品で十分でしょう。参加者が異なる言語を使用する場合は、ワークフローに追加の制御が必要になります。
- 翻訳文の横に原文が表示されます。.
- 言語選択または自動処理。.
- 用語と背景情報の準備。.
- 会話中に提示される目標言語のテキスト。.
- 読み上げが難しい場合、翻訳音声がオプションで利用できます。.
- 多言語での議論を記録した文書やメモ。.
これは リアルタイム音声テキスト変換 より大きな Transync AI 最終成果物よりも、ワークフローを重視する。.
リアルタイム音声認識に関するよくある質問
リアルタイム音声認識とは何ですか?
リアルタイム音声テキスト変換 音声ストリーミングを、発話中に暫定テキストと最終テキストに変換します。システムは、より多くのコンテキストを取得したり、発話の終了を検出したり、句読点を適用したり、話者の特定精度を向上させたりするにつれて、初期の仮説を修正する場合があります。.
どの程度の遅延がリアルタイムとみなされるのか?
単一の閾値はありません。最初のテキストが表示されるまでの時間、テキストが安定するまでの時間、ターンが完了するまでの時間、およびワークフローの出力が利用可能になるまでの時間を測定します。字幕リーダー、音声エージェント、会議参加者、通話後のレビュー担当者によって、許容できる遅延時間は異なります。.
ライブテキストが頻繁に変更されるのはなぜですか?
ストリーミング音声認識システムは、文が完成する前に部分的な仮説を公開します。後から送られてくる音声によって、最も可能性の高い語句、句読点、言語、話者などが変更される可能性があります。アプリケーションは、暫定的な結果と最終的なテキストを区別する必要があります。.
リアルタイム音声認識は、ライブ翻訳と同じですか?
いいえ。音声認識は、元の言語で話された単語を認識します。ライブ翻訳は、さらに別の言語変換を行い、翻訳された音声を追加する場合もあります。. Transync AI 多言語会話のための認識機能と翻訳機能を組み合わせたシステムです。.
リアルタイム音声認識に最適なAPIはどれですか?
絶対的な勝者は存在しない。. ディープグラム 詳細なエンドポイントと結果状態の制御を提供し、, アセンブリAI ストリーミングダイアリゼーションとリビジョン動作をサポートし、 ソニオックス 多言語の文字起こしと翻訳オプションを組み合わせています。同一の音声と製品要件を用いて、それぞれをテストしてください。.
リアルタイムの音声認識技術は話者を識別できますか?
一部の機種はダイアライゼーションまたはマルチチャンネル入力に対応していますが、ラベルは暫定的なものであり、音声データが増えるにつれて変更される可能性があります。テストでは、割り込み、類似した音声、デバイスの変更、および保存されたラベルの修正などを確認してください。.
企業はまず何をテストすべきでしょうか?
まず、実際の音声ルートと、名前、数字、否定、訂正、間、中断、専門用語、必要な言語を含む2分間のスクリプトを用意します。4つの時計すべてを測定し、保存した記録を確認します。.
最終評決
最速 リアルタイム音声テキスト変換 必ずしも最初の単語を一番早く表示するシステムが正解とは限りません。信頼できるシステムは、4つの時計のバランスを取ります。
最初のテキスト → 安定したテキスト → 完了したターン → 使用可能なレコード
開発者がエンドポイント、部分的な結果、話者の修正、およびアプリケーションの動作を制御する必要がある場合は、ストリーミングAPIを選択してください。チームがインフラストラクチャを構築することなく、音声から字幕、翻訳、記録、メモまでの完全なパスを必要とする場合は、完成済みの会議製品を選択してください。.
最も重要なのは、実際の入力と実際の結果をテストすることです。表示される単語、変化する単語、終了するターン、そして後で誰かが信頼する記録を測定してください。.