A conversão de fala em texto em tempo real vai além de legendas rápidas. Avalie 4 recursos, como relógios ocultos, revisões, gerenciamento de falantes e adequação a reuniões multilíngues antes de escolher.
A transcrição de fala em tempo real pode parecer excelente em uma demonstração, mas falhar em uma conversa. As primeiras palavras podem aparecer em 300 milissegundos, mas a frase pode continuar mudando por dois segundos. A identificação do falante pode surgir e, em seguida, ser revisada. Uma transcrição finalizada pode ficar pronta rapidamente, mas omitir a negação que alterou a decisão.
Por isso, “Qual a velocidade?” é a primeira pergunta errada. Uma avaliação útil precisa de quatro indicadores: tempo até o primeiro texto, tempo até um texto estável, tempo até a conclusão de uma interação e tempo até um registro utilizável. Cada indicador atende a uma necessidade operacional diferente.
Este artigo trata de conversão de fala em texto em tempo real como um fluxo de trabalho mensurável, em vez de um mero efeito visual. Ele compara APIs de streaming especializadas com um produto de reunião multilíngue pronto para uso, fornece um roteiro de teste repetível e explica quando a transcrição sozinha é insuficiente porque os participantes precisam de tradução, saída de voz ou anotações.
A resposta de 60 segundos
Fala para texto em tempo real Converte um fluxo de áudio ao vivo em texto enquanto o falante ainda está falando. O texto exibido geralmente é provisório. As primeiras palavras podem ser revisadas à medida que o modelo recebe mais contexto, detecta uma pausa, identifica o falante, aplica pontuação ou finaliza uma frase.
Os quatro relógios são:
- Latência do primeiro texto: Quanto tempo até que surja alguma hipótese?
- Latência de estabilidade: Quanto tempo até que as palavras parem de mudar?
- Latência de finalização de turno: Quanto tempo leva para o sistema considerar que uma fala ou enunciado terminou?
- Latência do fluxo de trabalho: Quanto tempo leva para que a transcrição esteja disponível para pesquisa, anotações, ações, tradução ou resposta a uma solicitação?
Um assistente de voz pode priorizar a confirmação da fala, pois precisa decidir quando responder. Legendas de acessibilidade podem priorizar textos parciais rápidos e legíveis. A gravação de uma reunião pode tolerar uma exibição um pouco mais lenta se nomes, números e identificação do orador se tornarem mais confiáveis. Uma reunião multilíngue adiciona mais uma etapa após o reconhecimento: a tradução precisa chegar a tempo para que alguém possa responder.
A conversão de fala em texto em tempo real é uma hipótese em constante evolução.
Uma transcrição ao vivo não é produzida em uma única etapa:
áudio do microfone ou do sistema → codificação e transporte → detecção de fala → reconhecimento provisório → revisão → finalização → identificação e formatação do locutor → ação do aplicativo
A tela geralmente exibe apenas o meio. Isso cria uma ilusão comum: como o texto aparece imediatamente, os usuários presumem que o resultado está finalizado. Na realidade, o mecanismo pode ainda estar reconsiderando limites de palavras, pontuação, idioma ou identidade do falante.
APIs especializadas tornam essa distinção explícita. Deepgram Retorna resultados provisórios e finais separadamente. Sua documentação explica que o texto preliminar pode ser alterado, enquanto os segmentos finalizados devem ser anexados para reconstruir uma fala completa. Um sinal separado de "fala finalizada" indica que o sistema detectou um ponto final, como uma pausa.
Soniox Expõe tokens finais e não finais, carimbos de data/hora, níveis de confiança, informações de idioma, rótulos de locutor opcionais e progresso do processamento por meio de uma conexão de streaming persistente. AssemblyAI Da mesma forma, oferece transcrições parciais e finais, marcação de pontos finais, registros de tempo em nível de palavra, sugestões de palavras-chave e diarização de falantes em tempo real nos modelos suportados.
Esses controles são úteis para desenvolvedores. Eles também revelam por que um usuário final não deve julgá-los. conversão de fala em texto em tempo real pela primeira linha visível.
Relógio 1: Tempo até o primeiro texto
O primeiro cronômetro inicia quando a fala chega ao sistema e para quando a primeira hipótese não vazia se torna visível ou disponível para o aplicativo.
Essa métrica inclui mais do que apenas inferência de modelos:
- Captura de áudio por microfone ou em reuniões.
- Tamanho do buffer e fragmentação de áudio.
- Reamostragem ou codificação.
- Transporte de rede.
- Processamento do servidor.
- Transporte de retorno.
- Renderização da interface.
Medir conversão de fala em texto em tempo real a partir do dispositivo real do usuário, não de um painel de controle de API. O número do lado do servidor de um fornecedor pode excluir o buffer de áudio, a rede do cliente, a renderização do navegador e o próprio atraso da plataforma de reunião.
A exibição rápida do primeiro texto é valiosa quando os usuários precisam ter certeza de que o sistema está ouvindo. Ela é menos útil quando a interface os incentiva a agir com base em palavras instáveis. Um bom design de legenda distingue visualmente o texto provisório sem torná-lo ilegível.
Como testar o primeiro relógio
Grave o mesmo áudio e a mesma imagem da tela a 60 quadros por segundo. Bata palmas uma vez e diga: “A renovação não foi aprovada”. Marque o quadro em que a forma de onda ou a palma atinge a entrada e o quadro em que o primeiro texto aparece. Repita dez vezes e relate o resultado mediano e o mais lento, não a melhor execução.
Teste conversão de fala em texto em tempo real Em condições normais de Wi-Fi, rede congestionada, laptop com cancelamento de ruído ativado e o próprio fone de ouvido ou microfone do ambiente, a velocidade de resposta do primeiro texto, que desaparece sob carga normal, não é uma característica confiável do produto.
Relógio 2: Hora de estabilizar o texto
O segundo cronômetro para quando um trecho de texto não muda mais. Esse é o cronômetro que a maioria das demonstrações de marketing esconde.
Considere a frase falada:
“Enviar quinze — desculpe, cinquenta — unidades na quinta-feira.”
A exibição pode mostrar “envio 15”, depois “envio 50” e, em seguida, uma correção pontuada. A primeira versão chegou rapidamente, mas somente a versão final pode ser copiada com segurança para um pedido.
A estabilidade é importante porque os sistemas subsequentes podem reagir prematuramente. Um resumo em tempo real, um assistente de vendas, um gatilho de conformidade, uma camada de tradução ou um agente de voz podem herdar um erro provisório. Em um conversão de fala em texto em tempo real No fluxo de trabalho, os desenvolvedores devem processar os sinais de finalização do mecanismo em vez de tratar cada atualização parcial como uma declaração concluída.
Meça a distância da revisão, não apenas o atraso.
Para cada frase de teste, registre:
- Número de versões provisórias.
- Número de palavras substituídas ou removidas.
- Tempo decorrido entre a última palavra falada e o texto estável.
- Verificar se a transcrição final armazenada corresponde à exibição estável.
- Se uma ação subsequente foi desencadeada antes da estabilidade.
Um pouco mais lento conversão de fala em texto em tempo real Um sistema pode ser mais seguro se realizar revisões com menos frequência. O equilíbrio ideal depende de os usuários estarem lendo, ditando, controlando o software ou conduzindo uma negociação.
Relógio 3: Tempo para uma Volta Completa
As palavras podem ser definitivas, mas a vez de falar não. Uma pessoa pode fazer uma pausa para pensar, respirar, procurar um número ou esperar que uma interrupção seja atendida. Se o sistema declarar que a vez terminou muito cedo, um assistente de voz pode interromper o usuário. Se demorar muito, a conversa parecerá improdutiva.
A determinação do ponto final geralmente utiliza o silêncio ou a atividade vocal para inferir que a fala terminou. Deepgram documentos com endpoints configuráveis e separados é_final e discurso_final estados. Suas diretrizes observam que limites curtos podem ser adequados para respostas breves de chatbots, enquanto pausas conversacionais mais longas podem exigir centenas de milissegundos antes que uma interação seja considerada completa.
Não existe um cenário universal que funcione para todos os falantes. Um roteiro rápido de call center, uma anamnese hesitante, uma aula expositiva e uma negociação bilíngue exigem padrões de pausa diferentes. Portanto, a finalização da fala é fundamental. conversão de fala em texto em tempo real medição, não apenas uma configuração de API.
Execute o teste de hesitação
Use estas quatro linhas:
- “O número da minha conta é… 4172.”
- “Concordo… se a data de entrega continuar sendo sexta-feira.”
- “A dosagem é de quinze—não, cinquenta—miligramas.”
- “Ana, você pode—” seguida por uma segunda pessoa que a interrompeu.
Contabilize finais de turno falsos, finais tardios, interrupções e palavras truncadas. Em seguida, ajuste o limite de finalização apenas se o aplicativo o disponibilizar. Se o produto for um aplicativo finalizado, observe o comportamento e decida se ele se adequa à tarefa.
Este relógio é onde conversão de fala em texto em tempo real Torna-se engenharia de conversação em vez de transcrição comum.
Relógio 4: Hora de um Registro Utilizável
O quarto cronômetro é o mais importante para as equipes. Ele termina quando o resultado permite a próxima ação.
“Utilizável” pode significar:
- As legendas permanecem legíveis durante a sessão.
- Os oradores são identificáveis.
- Nomes, números e terminologia podem ser corrigidos.
- É possível copiar ou exportar a transcrição completa.
- O registro permite buscas e possui permissões específicas.
- Um resumo e itens de ação são gerados.
- O texto original e o texto traduzido permanecem emparelhados.
- Os conceitos de retenção e exclusão são compreendidos.
Um sistema pode ganhar os três primeiros relógios e perder o quarto. JSON bruto de streaming não é um registro de reunião. Legendas rápidas que desaparecem não são evidência. Um resumo bonito sem uma transcrição rastreável pode ocultar erros de reconhecimento. É por isso que conversão de fala em texto em tempo real O setor de compras deve mensurar tanto o fluxo de trabalho finalizado quanto o modelo de streaming.
Fala para texto em tempo real Portanto, a avaliação deve ser feita no momento do uso, e não no momento da geração. Peça ao participante, ao revisor, ao desenvolvedor e ao administrador que testem a mesma sessão a partir de sua própria perspectiva.
Quatro rotas comparadas pelos quatro relógios
| Produto | Tipo de produto | Primeiro texto | Controles de estabilidade e finalidade | Manuseio do alto-falante | Função multilíngue | fluxo de trabalho de registro utilizável | Melhor ajuste |
|---|---|---|---|---|---|---|---|
| Transync AI | Aplicativo de tradução de reuniões pronto para uso | Exibição bilíngue ao vivo | Gerenciado pelo produto em vez de exposto como parâmetros de API. | Distingue automaticamente o par de idiomas selecionado; revisão no texto original e traduzido. | 60 idiomas, legendas bilíngues, dublagem. | Registro de tradução, transcrição e resumo da reunião de IA | Indivíduos e equipes que precisam de comunicação multilíngue em tempo real sem precisar criar um aplicativo. |
| Deepgram | API de streaming de fala para texto | Os resultados provisórios podem ser ativados. | Expõe resultados provisórios/finais, pontos finais, eventos de finalização de fala, controles de finalização de enunciado e finalização manual. | A diarização e as opções multicanal dependem da configuração/modelo. | Opções de idioma e modelo para streaming; a tradução é uma decisão de fluxo de trabalho separada. | O cliente deve desenvolver os recursos de armazenamento, edição, permissões, resumos e interface do usuário. | Desenvolvedores que criam agentes de voz, legendas, inteligência de chamadas ou produtos de transcrição personalizados. |
| AssemblyAI | API de streaming de fala para texto | Transcrições parciais foram retornadas por meio de conexão de streaming. | Encaminhamento inteligente de pontos finais e transcrições finalizadas imutáveis; aplica-se comportamento específico do modelo. | A transmissão de informações em formato de diar e os eventos de revisão por locutor estão disponíveis nos modelos compatíveis. | O modelo de streaming multilíngue suporta um conjunto de idiomas publicado. | O cliente desenvolve a aplicação final e registra o ciclo de vida do produto. | Equipes de produto que precisam de reconhecimento de streaming com diarização e inteligência downstream |
| Soniox | API de IA de fala em tempo real | Fluxo de tokens não finais com baixa latência | Indicadores de token final, finalização manual, carimbos de data/hora do token e progresso do processamento. | Diarização opcional de alto-falantes | Transcrição e tradução multilíngue em tempo real por meio de configuração de API. | O cliente cria a interface, a persistência, a revisão e a governança. | Desenvolvedores que criam reuniões multilíngues, transmissões, assistentes ou interfaces de voz. |
As funcionalidades foram verificadas em relação à documentação oficial do produto em 3 de outubro de 2026. Modelos, idiomas, limitações e preços estão sujeitos a alterações.
A tabela não classifica um vencedor universal. Ela separa duas decisões de compra: construir um produto em torno de uma API de streaming ou usar um fluxo de trabalho pronto. O melhor conversão de fala em texto em tempo real O caminho a seguir depende de quem é responsável pela captura de áudio, design da interface, correções, armazenamento e suporte.
Rota 1: Usar IA Transync quando a fala precisar cruzar idiomas
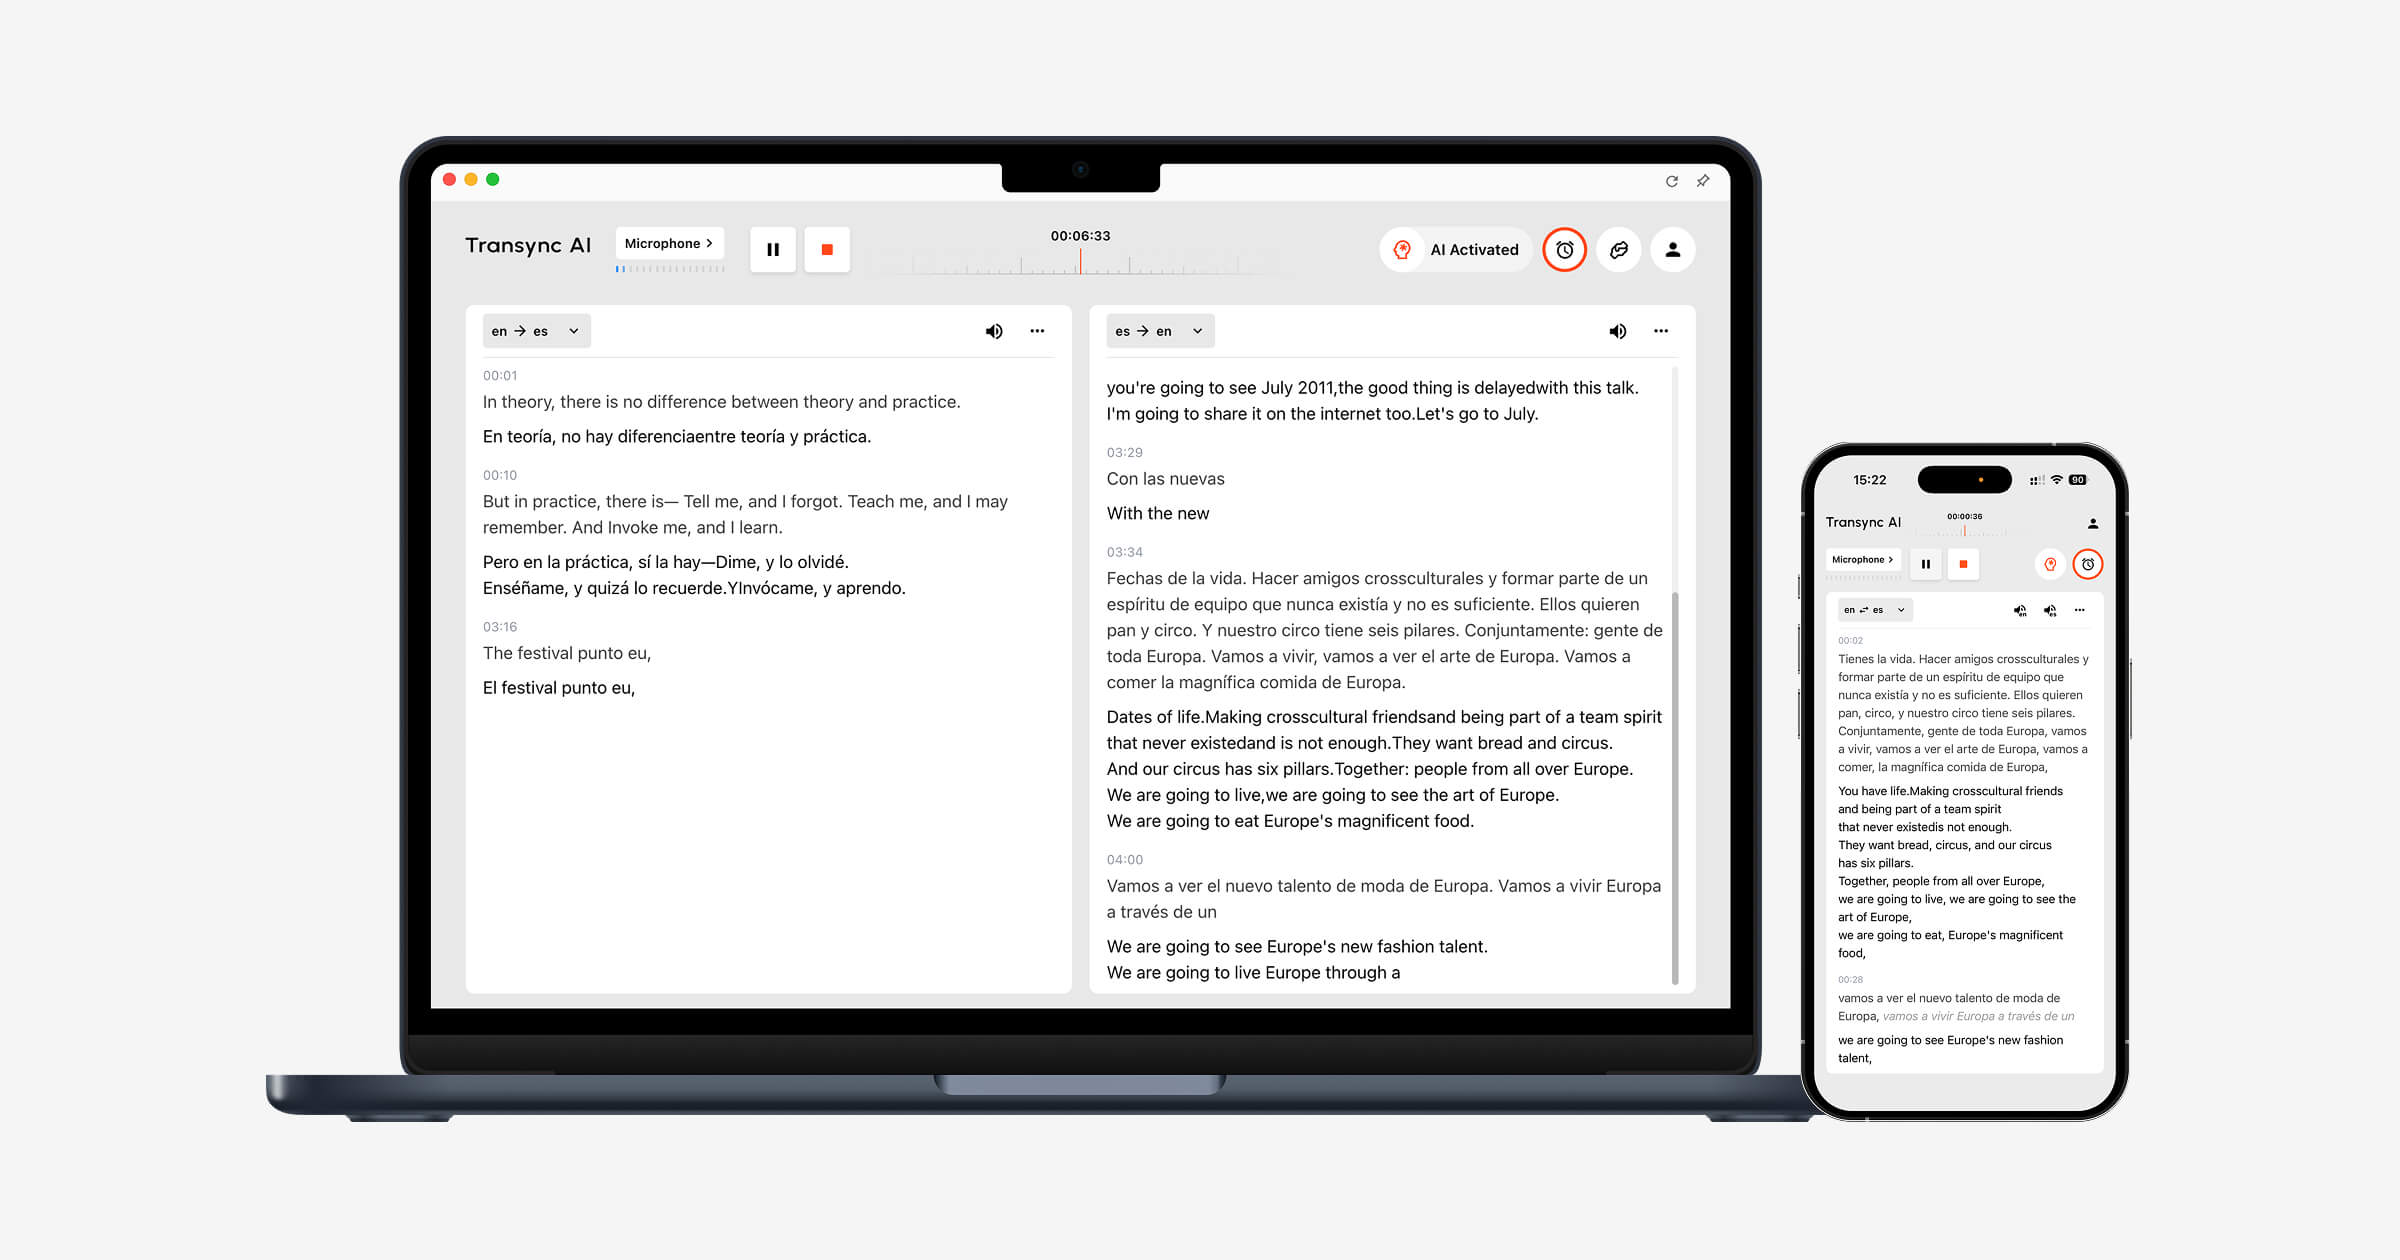
Transync AI Não é comercializado como uma API de conversão de fala em texto de uso geral. É um produto pronto para uso em reuniões e conversas que combina reconhecimento com tradução. fluxo de trabalho de tradução em tempo real Suporta 60 idiomas e mantém a fala original ao lado do texto traduzido, o que ajuda os usuários a diferenciar erros de reconhecimento de erros de tradução.
Para chamadas online, é tradução de reunião ao vivo Pode funcionar em diferentes ambientes de videoconferência através do microfone selecionado ou da rota de áudio do computador. Legendas Picture-in-Picture Mantenha o texto bilíngue visível acima dos aplicativos compatíveis, em vez de obrigar o usuário a visualizar uma guia de transcrição separada.
Antes de uma chamada, Palavras-chave e contexto É possível preparar nomes, siglas, termos de produtos e informações gerais. Após a sessão, a transcrição preserva o texto original e o traduzido, enquanto Notas da Reunião de IA É possível gerar resumos e listas de ações. O guia de transcrição atual afirma que os resumos de reuniões podem ser gerados em 55 idiomas.
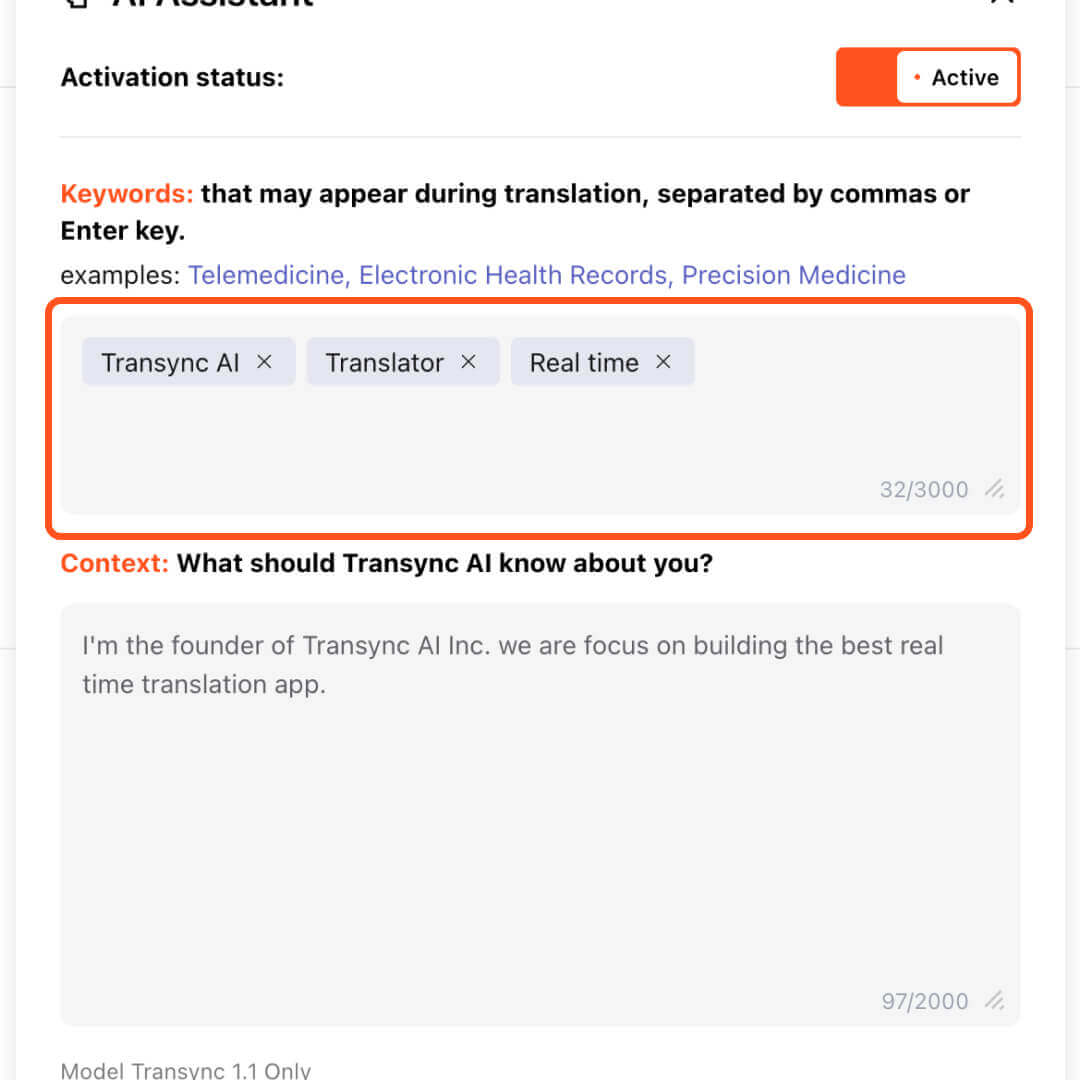
A interface de IA da Transync destaca o painel de ativação do assistente de IA com as palavras-chave 'Transync AI', 'Tradutor' e 'Tempo real', mostrando como inserir palavras-chave personalizadas para traduções precisas.
Experimente o Transync AI gratuitamente
Escolher Transync AI Quando o objetivo comercial é a compreensão e a resposta em vários idiomas, opte por uma API de streaming quando a equipe estiver desenvolvendo seu próprio agente de voz, plataforma de análise de chamadas, produto de acessibilidade ou interface de transcrição integrada.
Essa limitação é importante: Transync AI Não se trata de um mecanismo genérico de ditado offline nem de um endpoint STT para desenvolvedores. O roteamento de áudio, a qualidade da rede, os pares de idiomas, os microfones e a transmissão remota devem ser testados antes de uma reunião importante.
Rota 2: Use o Deepgram quando o sincronismo da curva fizer parte do produto.
Deepgram É particularmente instrutivo para desenvolvedores porque sua documentação separa resultados intermediários, segmentos finalizados, pontos finais de fala detectados e eventos de fim de enunciado. Essa separação permite que um aplicativo decida quando exibir texto, adicionar texto estável ou acionar uma resposta.
Explore o streaming da Deepgram
Usar Deepgram Quando a equipe de produto precisa ajustar o comportamento conversacional em vez de aceitar uma interface de legendas fixa, ela ainda é responsável pelo transporte de áudio, gerenciamento de estado, renderização parcial de texto, armazenamento, autenticação, permissões, correções e pela experiência final do usuário.
Um erro comum de implementação é salvar apenas a resposta mais recente ou esperar somente por um evento de fim de fala. As diretrizes oficiais explicam que uma longa emissão de texto pode conter vários segmentos de transcrição finalizados antes do fim da fala detectado. O aplicativo deve concatenar os segmentos finais corretamente.
Rota 3: Use o AssemblyAI quando os rótulos dos falantes em streaming forem importantes.
AssemblyAI O modelo fornece modelos de streaming com transcrições parciais e finais, indicação de pontos finais, sugestões de palavras-chave, registros de tempo das palavras e modos de diarização de falantes. Sua documentação também descreve eventos de revisão de falantes: o modelo pode corrigir rótulos de falantes anteriores à medida que coleta mais evidências.
Explore o AssemblyAI Streaming
Esse comportamento de revisão é importante em interfaces em tempo real. Se um aplicativo definir "Palestrante A" como permanente muito cedo, correções posteriores podem nunca ser refletidas no registro armazenado. A interface do usuário precisa de uma estratégia bem definida para rótulos e revisões pendentes.
Escolher AssemblyAI Quando o streaming com reconhecimento de locutor e o controle em nível de aplicativo são importantes, confirme o modelo exato, o suporte a idiomas, o comportamento de diarização, as opções médicas e os requisitos de dados para a implementação planejada; os recursos variam de acordo com o modelo de streaming.
Rota 4: Use o Soniox para APIs de streaming multilíngues
Soniox Combina transcrição e tradução em tempo real através de sua API WebSocket. A interface atual suporta dicas de idioma, personalização de contexto, diarização de falantes, configuração de tradução, registros de data e hora em nível de token, confiança, finalidade e informações de idioma.
Explore o serviço de streaming Soniox
Isso faz Soniox relevante quando os desenvolvedores querem conversão de fala em texto em tempo real e saída multilíngue dentro de sua própria aplicação. A configuração de contexto pode ajudar com termos de domínio, mas deve ser testada com um script de terminologia fixo em vez de presumir a partir do nome do recurso.
Assim como nas outras APIs, o serviço retorna blocos de construção. O comprador ainda precisa criar acesso para participantes, correções, retenção, exportações, resumos, controles administrativos, monitoramento, recuperação de erros e suporte.
Por que a taxa de erros de palavras não é suficiente
A taxa de erro de palavras mede substituições, supressões e inserções em relação a uma transcrição de referência. É útil, mas uma única média pode ocultar os erros mais relevantes.
Compare estes dois erros:
- “Podemos enviar em Quinta-feira”Podemos enviar em“ Terça-feira.”
- “Por favor, abra o painel de configurações”Por favor, abra“ um painel de configurações.”
Ambas podem ter a mesma importância, mas a primeira altera um compromisso. Crie um livro-razão de erros para:
- Nomes e identificação do orador.
- Números, moedas, datas e unidades.
- Negações e condições.
- Nomes de produtos e terminologia especializada.
- Alternância de códigos e mudanças de idioma.
- Interrupções e autocorreções.
- Pontuação que altera o significado.
Em seguida, considere o fator tempo. Uma palavra correta transmitida após a decisão ser tomada pode estar operacionalmente incorreta. Um erro provisório corrigido posteriormente ainda pode ter levado um agente de voz ou participante a agir.
A direita conversão de fala em texto em tempo real A pontuação, portanto, combina a gravidade do erro factual, a estabilidade, o momento da fala e a entonação — e não apenas a precisão média das palavras.
A Fita da Verdade de Dois Minutos
Use uma única fonte de gravação para que todos os candidatos recebam o mesmo áudio. Não permita que cada fornecedor escolha sua própria demonstração.
Roteiro
- “Olá, eu sou Niamh O'Rourke da Aster-Q.”
- “A referência é BX-417, não BX-471.”
- “A receita foi de 15,05 milhões de rupias, um aumento de 13,6%.”
- “Não renove a menos que o acordo de nível de serviço seja assinado.”
- “Enviar quinze — desculpe, cinquenta — unidades na quinta-feira.”
- “A API utiliza streaming WebSocket e um endpoint de 300 milissegundos.”
- Faça uma pausa de 700 milissegundos no meio de uma frase condicional.
- Permita que uma segunda pessoa interrompa e, em seguida, retorne à fala do primeiro participante.
- Adicione uma frase no segundo idioma solicitado.
- Termine com uma frase em tom baixo, enquanto o som de um teclado ainda estiver audível.
Folha de captura
| Medição | Como gravar isso | Defina a condição antes de testar. |
|---|---|---|
| Hora da primeira mensagem | Início do áudio da primeira hipótese não vazia | Com base na necessidade do usuário por feedback visual. |
| Tempo para texto estável | Última palavra dita até o texto final imutável | Rápido o suficiente para que as pessoas não ajam com base nas revisões. |
| atraso na finalização da virada | Fim da conversão pretendida para o evento de ponto final ou gatilho de resposta | Não interrompe as pausas normais nem parece não responder. |
| Contagem de revisões | Número de alterações de hipóteses visíveis ou ao nível da API | A interface permanece legível e as ações subsequentes aguardam a sua conclusão. |
| erros factuais críticos | Nomes, figuras, negações, datas, unidades e condições. | Nenhum erro grave não sinalizado no piloto. |
| Recuperação de rótulo do locutor | Tempo e exatidão após interrupção | A transcrição armazenada reflete a atribuição corrigida. |
| Conclusão do fluxo de trabalho | Encontro com o fim da ação de registro ou aplicativo pesquisável/exportável | Cumpre o prazo operacional |
Realize dez tentativas e, em seguida, relate a mediana, o percentil 95 e os piores resultados observados, quando a amostra permitir. Uma única execução perfeita não estabelece confiabilidade.
Sete modos de falha e a primeira solução
| Sintoma | Camada provável | Primeiro teste útil |
|---|---|---|
| O texto aparece atrasado em relação à primeira palavra. | Captura, armazenamento em buffer, codificação, rede ou modelo | Meça cada salto; reduza os trechos de áudio muito grandes. |
| O texto aparece rapidamente, mas é reescrito com frequência. | Comportamento da hipótese interina | Aguarde a conclusão antes de acionar as ações; redesenhe a exibição provisória. |
| Sistema interrompe palestrantes ponderados | detecção de limiar de ponto final ou atividade de voz | Teste pausas mais longas e ajuste o ponto final onde estiver disponível. |
| O sistema demora muito tempo para responder a comandos curtos. | Lógica de limite de ponto final ou de ativação de aplicativo | Teste limiares mais curtos ou controles explícitos de fim de turno. |
| Nomes e códigos falham repetidamente | Ambiguidade acústica e contexto de domínio ausente | Adicione termos-chave/contexto e melhore a qualidade do microfone. |
| As etiquetas dos alto-falantes mudam após a exibição. | A diarização de fluxos está revisando os agrupamentos. | Suporte para etiquetas pendentes e aplicação de eventos de revisão ao registro. |
| A transcrição é rápida, mas posteriormente inutilizável. | Fluxo de trabalho do produto ausente | Adicione correções, armazenamento, pesquisa, permissões, exportação e exclusão — ou escolha um aplicativo pronto. |
Solução de problemas conversão de fala em texto em tempo real Da esquerda para a direita. Substituir o modelo não corrigirá uma entrada silenciada, uma taxa de amostragem incorreta ou uma interface de usuário que salva texto provisório como final.
Quando a conversão de fala em texto não é o objetivo final
A transcrição responde à pergunta: "Quais palavras foram reconhecidas?". A tradução responde à pergunta: "O que essas palavras significam em outro idioma?". Um produto de reunião também deve responder à pergunta: "A outra pessoa consegue entender, responder e recuperar a decisão posteriormente?".“
Se todos falam o mesmo idioma e precisam de legendas acessíveis, ditado, pesquisa ou análises, uma API de transcrição fonética dedicada ou um produto de transcrição podem ser suficientes. Se os participantes usam idiomas diferentes, o fluxo de trabalho precisa de controles adicionais:
- O texto original está visível ao lado da tradução.
- Seleção de idioma ou processamento automático.
- Preparação da terminologia e do contexto.
- Texto no idioma alvo apresentado durante a conversa.
- A opção de voz traduzida quando a leitura é impraticável é viável.
- Registros e anotações que preservam a discussão multilíngue.
Este é o ponto onde conversão de fala em texto em tempo real torna-se um componente do maior Transync AI O foco está no fluxo de trabalho, e não no produto final.
Perguntas frequentes sobre conversão de fala em texto em tempo real
O que é a conversão de fala em texto em tempo real?
Fala para texto em tempo real O sistema converte áudio em fluxo contínuo em texto provisório e final enquanto a fala está acontecendo. Ele pode revisar hipóteses iniciais à medida que recebe mais contexto, detecta o fim de uma fala, aplica pontuação ou aprimora a atribuição do falante.
Qual o tempo de atraso considerado tempo real?
Não existe um limite único. Meça o tempo até o primeiro texto, a estabilidade do texto, a finalidade da fala e a usabilidade do fluxo de trabalho. Um leitor de legendas, um agente de voz, um participante da reunião e um revisor pós-chamada têm diferentes níveis de tolerância ao atraso.
Por que o texto ao vivo continua mudando?
Os sistemas de reconhecimento de fluxo de dados publicam hipóteses parciais antes que uma frase esteja completa. O áudio posterior pode alterar a formulação, a pontuação, o idioma ou o locutor mais prováveis. Os aplicativos devem distinguir os resultados provisórios do texto finalizado.
A transcrição de fala em texto em tempo real é a mesma coisa que a tradução simultânea?
Não. A conversão de fala em texto reconhece as palavras faladas no idioma de origem. A tradução simultânea adiciona outra transformação de idioma e também pode incluir a voz traduzida. Transync AI Combina reconhecimento e tradução para conversas multilíngues.
Qual API é a melhor para conversão de fala em texto em tempo real?
Não há um vencedor universal. Deepgram Oferece controles detalhados de endpoint e estado do resultado, AssemblyAI oferece suporte à diarização de streaming e comportamento de revisão, e Soniox Combina opções de transcrição e tradução multilíngue. Teste cada uma com áudio idêntico e os requisitos exatos do produto.
A função de transcrição de fala em texto em tempo real consegue identificar os falantes?
Alguns modelos suportam diarização ou entrada multicanal, mas os rótulos podem ser provisórios e podem mudar à medida que mais áudio chega. Teste interrupções, vozes semelhantes, mudanças de dispositivo e correções de rótulos armazenados.
O que uma empresa deve testar primeiro?
Comece com a rota de áudio real e um roteiro de dois minutos contendo nomes, números, negações, correções, pausas, interrupções, terminologia e os idiomas necessários. Meça todos os quatro relógios e inspecione a gravação salva.
Veredicto final
O mais rápido conversão de fala em texto em tempo real Um sistema confiável não é necessariamente aquele que exibe a primeira palavra primeiro. Um sistema confiável equilibra quatro relógios:
primeiro texto → texto estável → turno concluído → registro utilizável
Escolha uma API de streaming quando os desenvolvedores precisarem controlar endpoints, resultados parciais, revisões de palestrantes e o comportamento do aplicativo. Escolha um produto de reunião pronto quando a equipe precisar do caminho completo, do áudio às legendas, tradução, gravações e anotações, sem precisar construir essa infraestrutura.
Mais importante ainda, teste a entrada real e a consequência real. Meça a palavra que aparece, a palavra que muda, a interação que termina e o registro em que alguém confiará posteriormente.