La transcription vocale en temps réel ne se limite pas à la génération rapide de sous-titres. Avant de faire votre choix, évaluez quatre paramètres essentiels : temps d’attente, révisions, gestion des intervenants et compatibilité multilingue.
La transcription vocale en temps réel peut sembler excellente lors d'une démonstration, mais s'avérer inefficace en situation réelle. Les premiers mots peuvent apparaître en 300 millisecondes, mais la phrase peut continuer à évoluer pendant deux secondes. L'identification du locuteur peut être annoncée puis modifiée. Une transcription impeccable peut être rapidement disponible, mais omettre la négation qui a permis de trancher.
C’est pourquoi la question “ Quelle est la rapidité ? ” n’est pas la bonne première à se poser. Une évaluation pertinente nécessite quatre temps d’attente : le temps d’apparition du premier texte, le temps d’obtention d’un texte stable, le temps de fin de tour de parole et le temps d’obtention d’un enregistrement exploitable. Chaque temps d’attente répond à un besoin opérationnel différent.
Cet article traite de conversion vocale en texte en temps réel Il s'agit d'un processus mesurable plutôt que d'un simple effet visuel. Ce document compare des API de streaming spécialisées à une solution de réunion multilingue prête à l'emploi, fournit un scénario de test reproductible et explique dans quels cas la transcription seule est insuffisante, car les participants ont besoin de traduction, de synthèse vocale ou de notes.
La réponse en 60 secondes
Conversion vocale en texte en temps réel Ce système convertit un flux audio en direct en texte pendant que l'orateur parle encore. Le texte affiché est souvent provisoire. Les premiers mots peuvent être modifiés à mesure que le modèle reçoit plus de contexte, détecte une pause, identifie l'orateur, applique la ponctuation ou finalise l'énoncé.
Les quatre horloges sont :
- Latence du premier texte : Combien de temps faudra-t-il avant qu'une hypothèse ne soit formulée ?
- Latence de stabilité : Combien de temps faudra-t-il avant que les mots cessent de changer ?
- Latence de finalité du tour : Combien de temps faut-il au système pour décider qu'un tour de parole ou un énoncé est terminé ?
- Latence du flux de travail : Combien de temps faut-il pour que la transcription soit utilisable pour la recherche, les notes, les actions, la traduction ou la réponse à une demande ?
Un agent vocal peut privilégier la fin de la prise de parole car il doit décider du moment opportun pour répondre. Les sous-titres d'accessibilité peuvent privilégier un texte partiel rapide et lisible. Un compte rendu de réunion peut tolérer un affichage légèrement plus lent si les noms, les numéros et l'identification des intervenants sont plus fiables. Une réunion multilingue ajoute une étape supplémentaire après la reconnaissance : la traduction doit être disponible suffisamment rapidement pour permettre une réponse.
La transcription vocale en temps réel est une hypothèse en constante évolution.
La transcription en direct n'est pas produite en une seule étape :
Audio du microphone ou du système → encodage et transport → détection vocale → reconnaissance provisoire → révision → finalisation → étiquetage et formatage du locuteur → action de l'application
L'écran n'affiche généralement que la partie centrale. Cela crée une illusion courante : comme le texte apparaît immédiatement, les utilisateurs supposent que le résultat est terminé. En réalité, le moteur peut encore analyser les limites des mots, la ponctuation, la langue ou l'identité du locuteur.
Les API spécialisées rendent cette distinction explicite. Deepgram Ce module renvoie séparément les résultats intermédiaires et définitifs. Sa documentation explique que le texte préliminaire peut être modifié, tandis que les segments définitifs doivent être concaténés pour reconstituer un énoncé complet. Un signal de fin de parole distinct indique que le système a détecté un point final, tel qu'une pause.
Soniox expose les jetons finaux et non finaux, les horodatages, le niveau de confiance, les informations linguistiques, les étiquettes de locuteur facultatives et la progression du traitement via une connexion de flux persistante. Assemblage IA Il offre également des transcriptions partielles et finales, le pointage final, des horodatages au niveau des mots, des invites par mots clés et une diarisation du locuteur en continu dans les modèles pris en charge.
Ces contrôles sont utiles aux développeurs. Ils expliquent également pourquoi un utilisateur final ne devrait pas juger conversion vocale en texte en temps réel par la première ligne visible seulement.
Horloge 1 : Heure du premier SMS
Le premier chronomètre démarre lorsque la parole atteint le système et s'arrête lorsque la première hypothèse non vide devient visible ou disponible pour l'application.
Cette mesure inclut plus que l'inférence du modèle :
- Capture audio par microphone ou lors de réunions.
- Taille du tampon et découpage audio.
- Rééchantillonnage ou encodage.
- Transport en réseau.
- Traitement serveur.
- Transport retour.
- Rendu de l'interface.
Mesure conversion vocale en texte en temps réel Le délai mesuré sur l'appareil de l'utilisateur, et non via un tableau de bord API, peut exclure la mise en mémoire tampon audio, la connexion réseau du client, le rendu par le navigateur et le délai propre à la plateforme de réunion.
Un texte d'introduction rapide est précieux pour rassurer les utilisateurs quant à la prise en compte du système. Il est moins utile lorsque l'interface les incite à agir sur la base de mots instables. Une légende bien conçue distingue visuellement le texte provisoire sans le rendre illisible.
Comment tester la première horloge
Enregistrez le son et l'écran à 60 images par seconde. Frappez une fois dans vos mains, puis dites : “ Le renouvellement n'est pas approuvé. ” Marquez l'image où le signal audio ou le claquement de mains atteint l'entrée et celle où le premier texte apparaît. Répétez l'opération dix fois et indiquez le résultat médian et le plus lent, et non le meilleur résultat.
Test conversion vocale en texte en temps réel Dans des conditions de Wi-Fi standard, un réseau saturé, un ordinateur portable avec réduction de bruit et l'utilisation d'un casque ou d'un microphone ambiant, la vitesse d'affichage initiale, qui disparaît en charge normale, n'est pas un gage de fiabilité.
Horloge 2 : Temps pour un texte stable
Le deuxième chronomètre s'arrête lorsqu'une portion de texte ne change plus. C'est ce chronomètre que la plupart des démonstrations marketing dissimulent.
Considérons la phrase prononcée :
“Expédier quinze… pardon, cinquante… unités jeudi.”
L'affichage peut progresser par “ livraison 15 ”, puis “ livraison 50 ”, puis une correction ponctuelle. La première version est arrivée rapidement, mais seule la version finale peut être copiée en toute sécurité dans une commande.
La stabilité est importante car les systèmes en aval peuvent réagir trop tôt. Un résumé en direct, un assistant commercial, un déclencheur de conformité, une couche de traduction ou un agent vocal peuvent hériter d'une erreur provisoire. conversion vocale en texte en temps réel Dans ce flux de travail, les développeurs doivent traiter les signaux de finalité du moteur plutôt que de considérer chaque mise à jour partielle comme une instruction complète.
Mesurer la distance de révision, pas seulement le délai
Pour chaque phrase de test, enregistrez :
- Nombre de versions provisoires.
- Nombre de mots remplacés ou supprimés.
- Délai entre le dernier mot prononcé et le texte stable.
- Vérifier si la transcription finale enregistrée correspond à l'affichage stable.
- Si une action en aval a été déclenchée avant la stabilisation.
Un peu plus lent conversion vocale en texte en temps réel Un système peut être plus sûr s'il effectue des révisions moins fréquentes. Le compromis optimal dépend de la fonction des utilisateurs : lecture, dictée, contrôle de logiciels ou négociation.
Horloge 3 : Temps restant pour un tour complet
Les mots peuvent être définitifs même si la parole n'est pas encore donnée. Une personne peut faire une pause pour réfléchir, respirer, chercher un chiffre ou attendre qu'une interruption survienne. Si le système déclare la fin de la parole trop tôt, un assistant vocal risque de couper la parole à l'utilisateur. S'il attend trop longtemps, la conversation semblera sans réponse.
Le pointage de fin utilise généralement le silence ou l'activité vocale pour déduire que la parole est terminée. Deepgram documents configurables point de terminaison et séparés est_final et discours_final Les États indiquent dans leurs recommandations que des seuils courts peuvent convenir à des réponses brèves de chatbot, tandis que des pauses conversationnelles plus longues peuvent nécessiter des centaines de millisecondes avant qu'un tour de parole ne soit considéré comme terminé.
Il n'existe pas de modèle universel qui convienne à tous les locuteurs. Un script rapide pour un centre d'appels, un exposé médical hésitant, un cours magistral et une négociation bilingue présentent des schémas de pauses différents. La finalité de la prise de parole est donc un élément fondamental. conversion vocale en texte en temps réel une mesure, et non un simple paramètre d'API.
Effectuez le test d'hésitation
Utilisez ces quatre lignes :
- “ Mon numéro de compte est… 4172. ”
- “ Je suis d’accord… si la date de livraison reste vendredi. ”
- “ La dose est de quinze… non, cinquante… milligrammes. ”
- “ Ana, peux-tu… ” suivie d’une deuxième intervention.
Comptez les fausses fins de tour de parole, les fins de tour tardives, les interruptions et les mots tronqués. Ajustez ensuite le seuil de fin de tour uniquement si l'application le permet. S'il s'agit d'une application finalisée, observez son comportement et déterminez s'il est adapté à la tâche.
Cette horloge est là où conversion vocale en texte en temps réel Il s'agit alors d'ingénierie conversationnelle plutôt que de transcription ordinaire.
Horloge 4 : Temps nécessaire pour obtenir un enregistrement utilisable
La quatrième phase est la plus importante pour les équipes. Elle se termine lorsque les résultats permettent d'entamer l'action suivante.
“ Utilisable ” peut signifier :
- Les sous-titres restent lisibles pendant la session.
- Les intervenants sont identifiables.
- Les noms, les numéros et la terminologie sont corrigibles.
- Une transcription complète peut être copiée ou exportée.
- Le document est consultable et soumis à autorisation.
- Un résumé et une liste d'actions à entreprendre sont générés.
- Le texte source et le texte traduit restent associés.
- La conservation et la suppression sont comprises.
Un système peut gagner les trois premières sessions et perdre la quatrième. Un flux JSON brut ne constitue pas un compte rendu de réunion. Des sous-titres éphémères ne sont pas des preuves. Un résumé attrayant sans transcription traçable peut masquer des erreurs de reconnaissance. Voici pourquoi. conversion vocale en texte en temps réel Le service des achats doit mesurer le flux de travail final ainsi que le modèle de diffusion en continu.
Conversion vocale en texte en temps réel Il convient donc de l'évaluer au moment de son utilisation, et non au moment de sa génération. Demandez au participant, à l'évaluateur, au développeur et à l'administrateur de tester la même session chacun de leur point de vue.
Comparaison de quatre itinéraires selon les quatre horloges
| outils | Type de produit | Premier texte | Contrôles de stabilité et de finalité | Manipulation des haut-parleurs | Rôle multilingue | Flux de travail d'enregistrement utilisable | Meilleure adaptation |
|---|---|---|---|---|---|---|---|
| Transync AI | Application de traduction de réunions prête à l'emploi | Affichage bilingue en direct | Géré par le produit plutôt qu'exposé sous forme de paramètres d'API | Distingue automatiquement la paire de langues sélectionnée ; permet de consulter le texte original et la traduction. | 60 langues, sous-titres bilingues, voix traduite | Compte rendu de traduction, transcription et résumé de la réunion sur l'IA | Les personnes et les équipes qui ont besoin d'une communication multilingue en temps réel sans avoir à créer d'application |
| Deepgram | API de conversion vocale en texte en continu | Les résultats intermédiaires peuvent être activés | Affiche les résultats intermédiaires/finaux, le pointage final, les événements de fin de parole, les contrôles de fin d'énoncé et la finalisation manuelle. | Les options de diarisation et de multicanal dépendent de la configuration/du modèle. | Options de langue et de modèle de streaming ; la traduction est une décision de flux de travail distincte | Le client doit configurer le stockage, l'édition, les autorisations, les résumés et l'interface utilisateur. | Développeurs créant des agents vocaux, des sous-titres, des solutions d'analyse d'appels ou des produits de transcription personnalisés |
| Assemblage IA | API de conversion vocale en texte en continu | Transcriptions partielles renvoyées via la connexion de streaming | Détection intelligente des points de terminaison et transcriptions finales immuables ; un comportement spécifique au modèle s'applique | La diarisation en continu et les événements de révision par l'orateur sont disponibles dans les modèles pris en charge. | Le modèle de diffusion multilingue prend en charge un ensemble de langues publié. | Le client crée l'application finale et enregistre le cycle de vie | Les équipes produit ont besoin d'une reconnaissance en flux continu avec diarisation et analyse en aval. |
| Soniox | API d'IA vocale en temps réel | Flux de jetons non finaux à faible latence | Indicateurs de jeton final, finalisation manuelle, horodatage des jetons et progression du traitement | Diarisation optionnelle des intervenants | Transcription et traduction multilingues en temps réel via la configuration de l'API | Le client conçoit l'interface, la persistance, la révision et la gouvernance. | Développeurs créant des réunions multilingues, des diffusions, des assistants ou des interfaces vocales |
Les fonctionnalités ont été vérifiées par rapport à la documentation produit officielle le 3 octobre 2026. Les modèles, les langues, les limites et les prix peuvent changer.
Le tableau ne désigne pas un vainqueur incontestable. Il distingue deux options d'achat : développer un produit autour d'une API de streaming ou utiliser un flux de travail existant. conversion vocale en texte en temps réel Le cheminement dépend de qui possède la capture audio, la conception de l'interface, les corrections, le stockage et le support.
Voie 1 : Utiliser l’IA Transync lorsque la parole doit franchir plusieurs barrières linguistiques
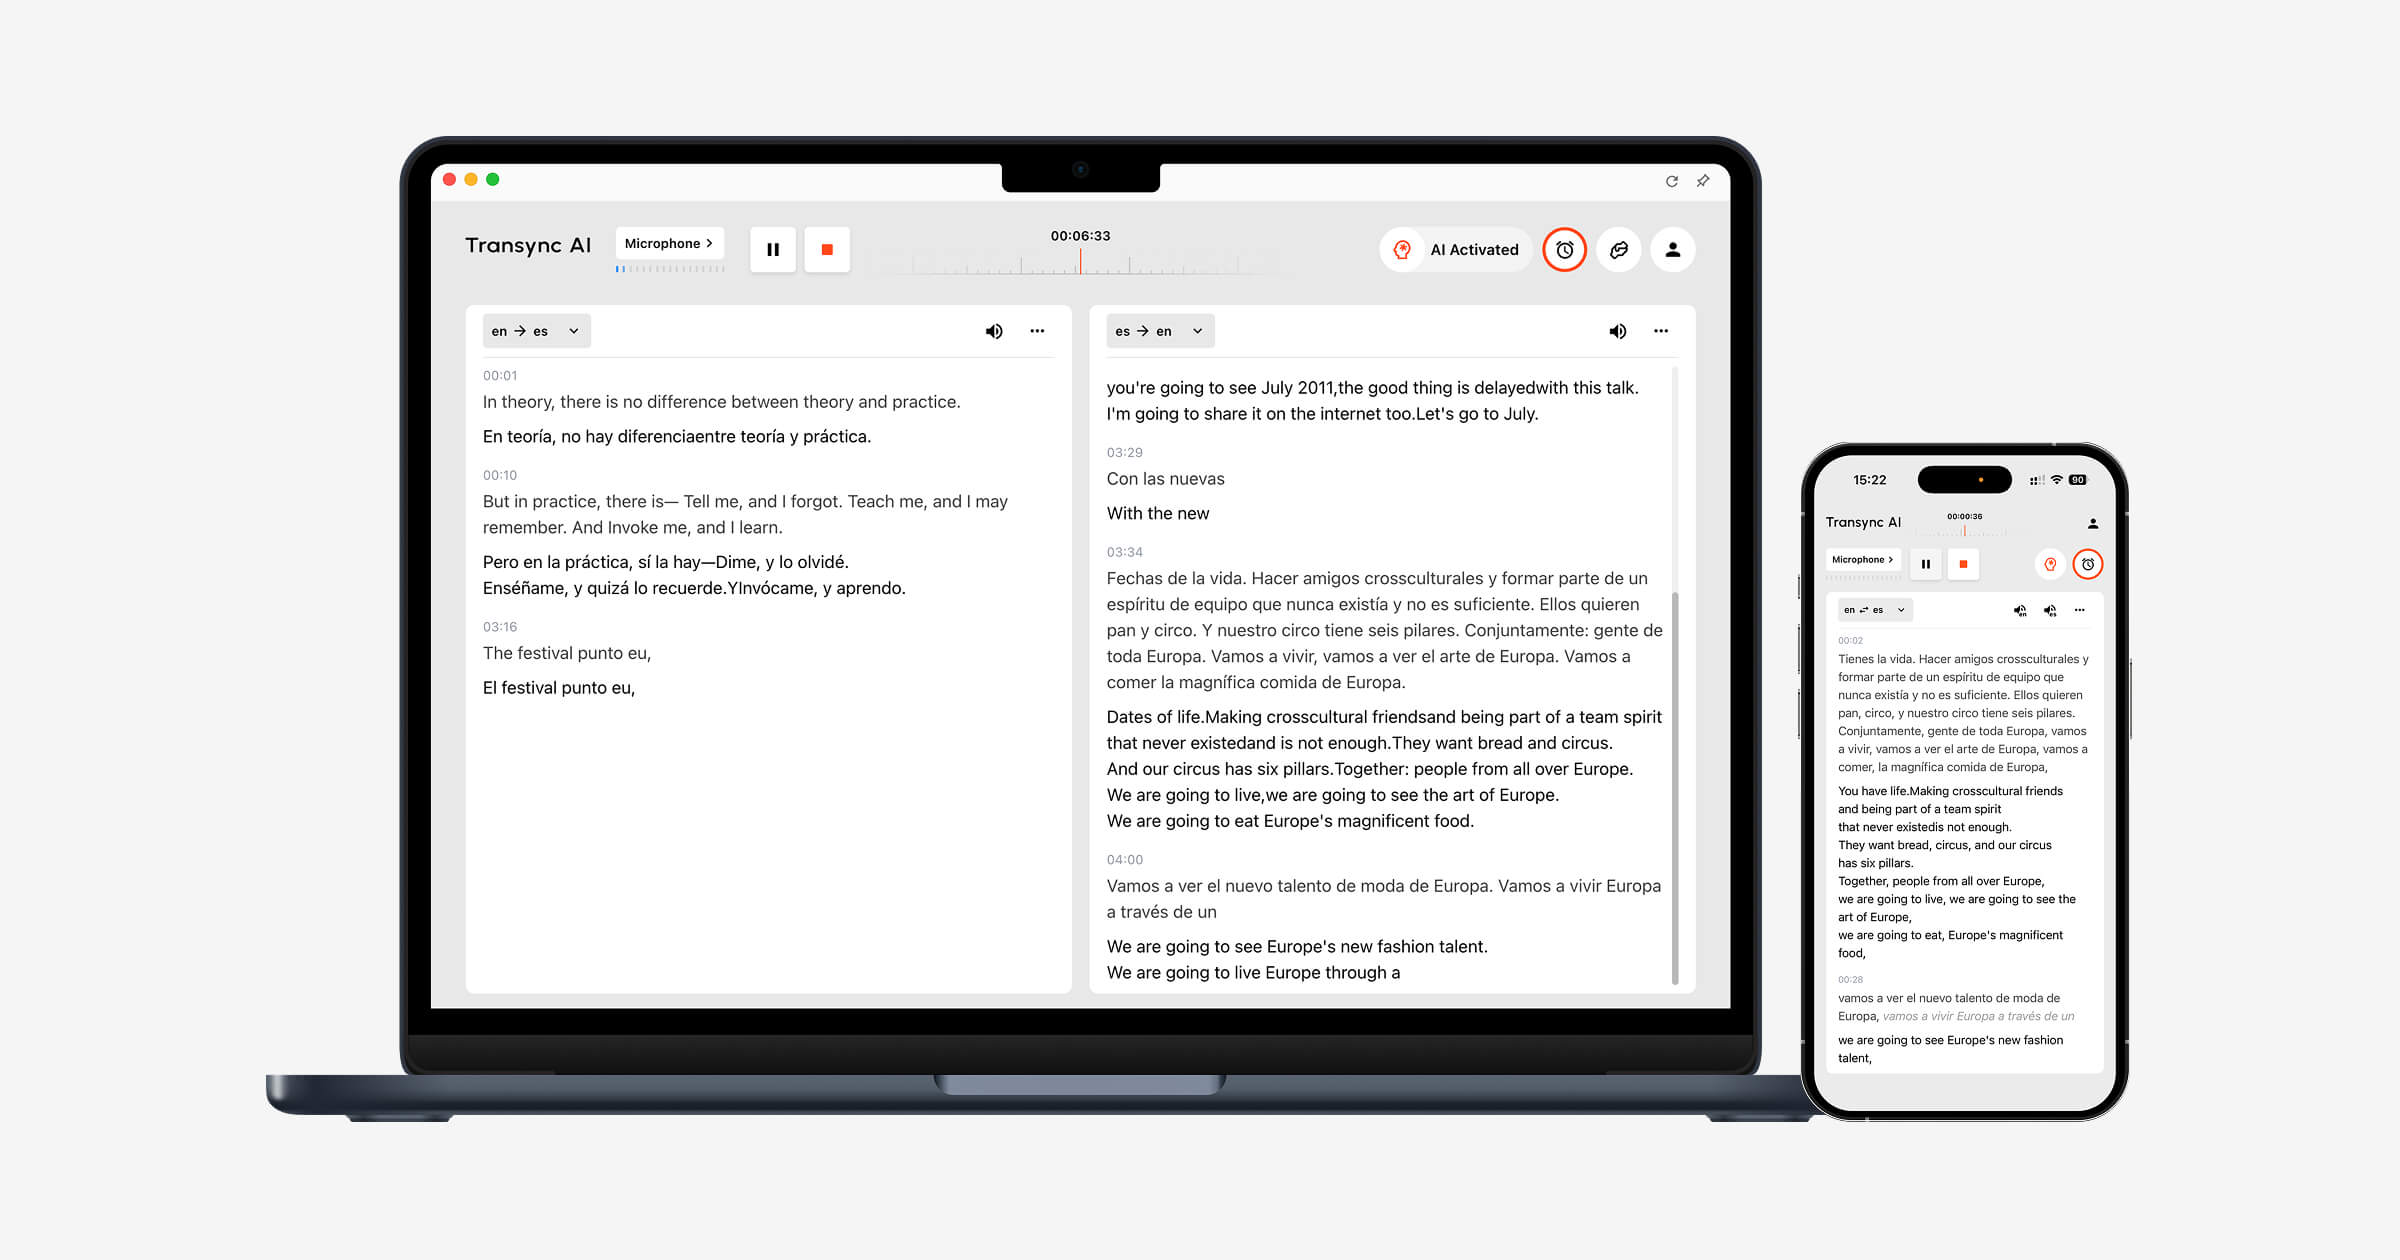
Transync AI n'est pas vendu comme une API de conversion vocale en texte à usage général. Il s'agit d'un produit de réunion et de conversation prêt à l'emploi qui combine la reconnaissance vocale et la traduction. flux de travail de traduction en temps réel Il prend en charge 60 langues et conserve le discours original à côté du texte traduit, ce qui aide les utilisateurs à distinguer les erreurs de reconnaissance des erreurs de traduction.
Pour les appels en ligne, son traduction de réunion en direct peut fonctionner avec différents environnements de conférence via le microphone sélectionné ou la sortie audio de l'ordinateur. Sous-titres en incrustation d'image Gardez le texte bilingue visible au-dessus des applications compatibles au lieu d'obliger l'utilisateur à consulter un onglet de transcription séparé.
Avant un appel, Mots-clés et contexte peut préparer les noms, les acronymes, les termes produits et le contexte. Après la session, la transcription conserve le texte original et la traduction, tandis que Notes de réunion sur l'IA Il est possible de générer des résumés et des listes d'actions. Le guide de transcription actuel indique que les résumés de réunion peuvent être générés en 55 langues.
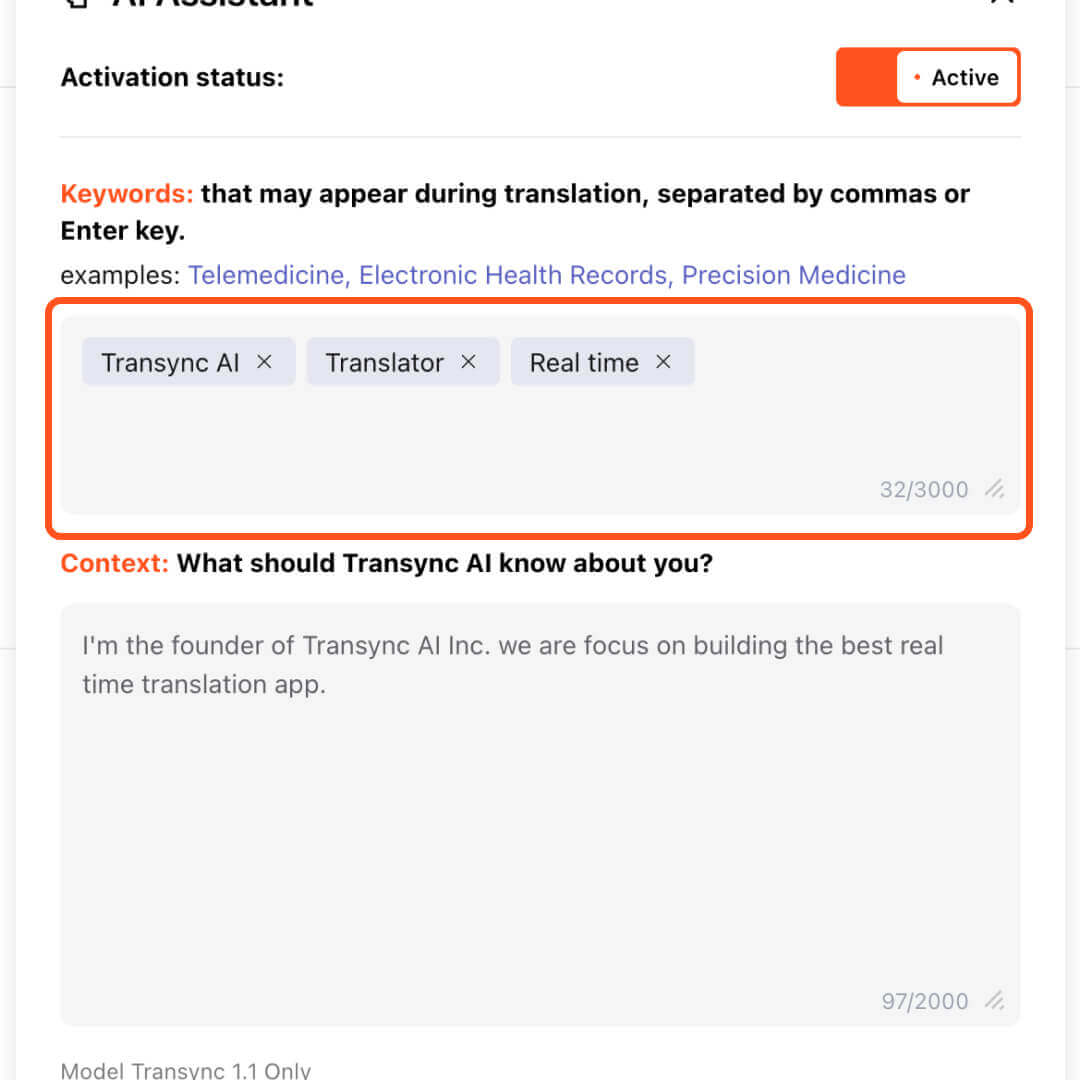
L'interface Transync AI met en évidence le panneau d'activation de l'assistant IA avec les mots clés ‘ Transync AI ’, ‘ Traducteur ’ et ‘ Temps réel ’, montrant comment saisir des mots clés personnalisés pour des traductions précises.
Essayez Transync AI gratuitement
Choisir Transync AI Lorsque l'objectif est de comprendre et de répondre dans plusieurs langues, privilégiez une API de streaming. En revanche, si votre équipe développe son propre agent vocal, une plateforme d'analyse d'appels, un produit d'accessibilité ou une interface de transcription intégrée, optez plutôt pour une API de streaming.
La limitation est importante : Transync AI Il ne s'agit pas d'un moteur de dictée hors ligne générique ni d'un terminal STT pour développeurs. Le routage audio, la qualité du réseau, les paires de langues, les microphones et la transmission à distance doivent être testés avant toute réunion importante.
Itinéraire 2 : Utiliser Deepgram lorsque le timing des virages fait partie du produit
Deepgram Ce document est particulièrement instructif pour les développeurs car il distingue clairement les résultats intermédiaires, les segments finalisés, les points de terminaison vocaux détectés et les événements de fin d'énoncé. Cette distinction permet à une application de déterminer quand afficher du texte, ajouter du texte définitif ou déclencher une réponse.
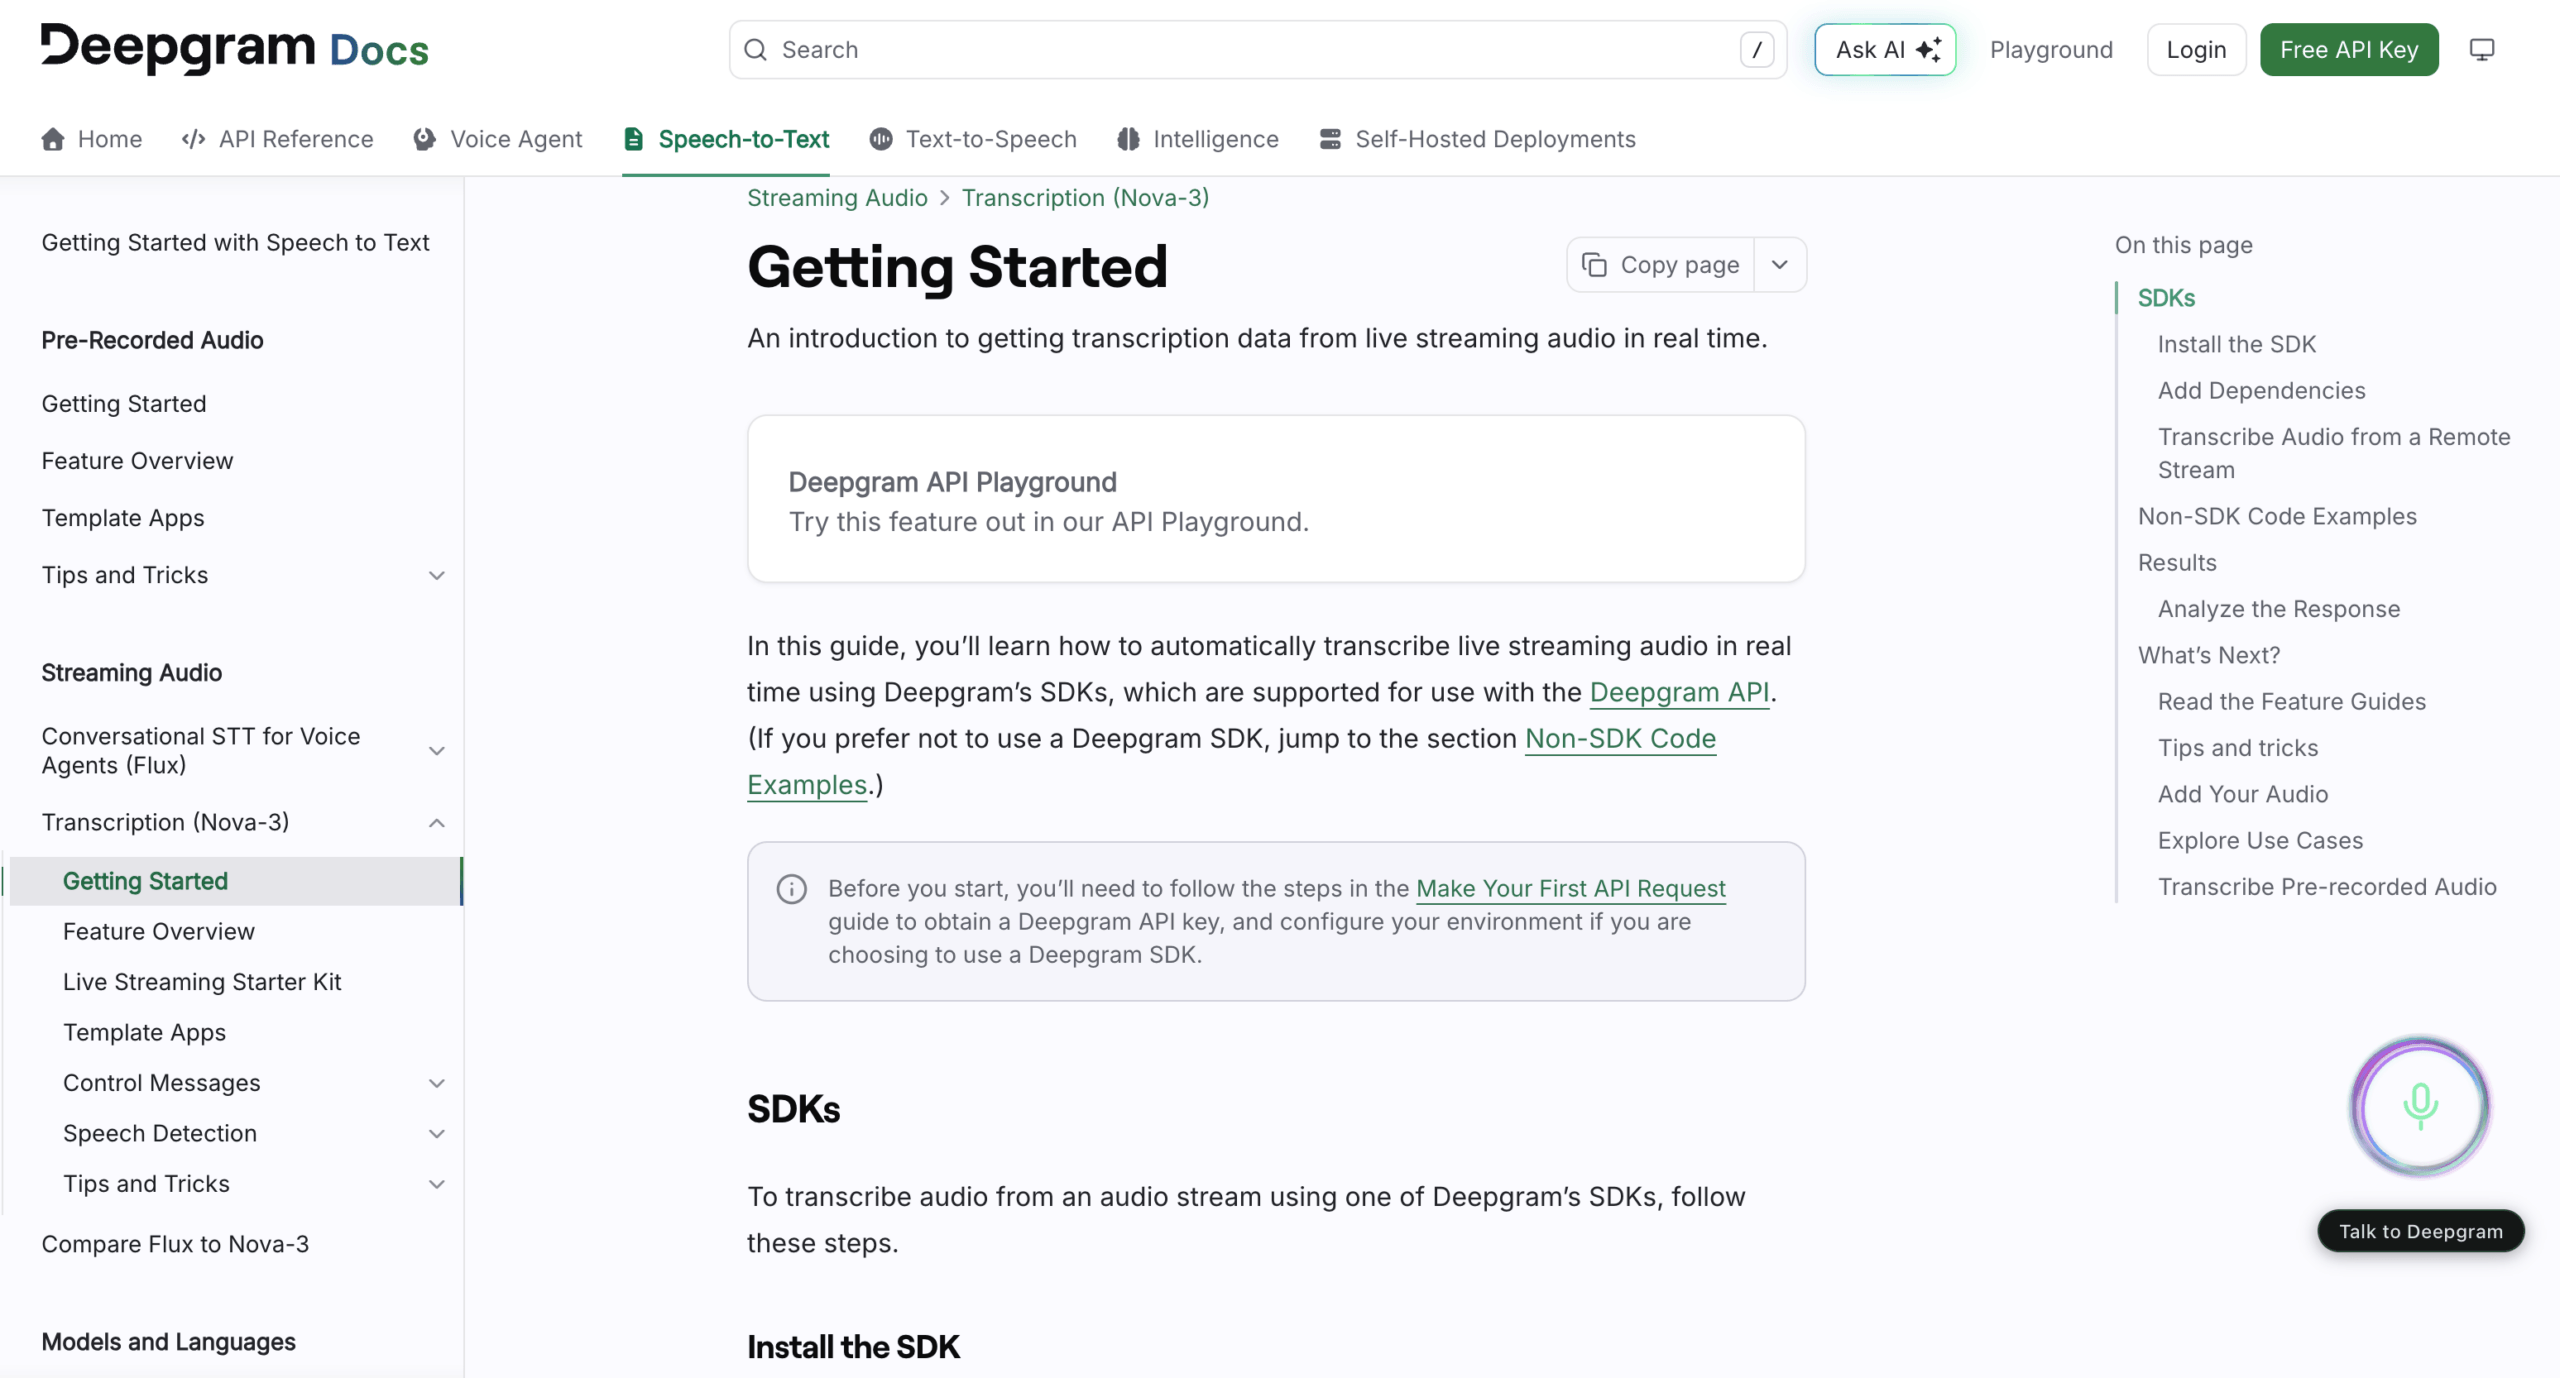
Explorez le streaming Deepgram
Utiliser Deepgram Lorsque l'équipe produit doit ajuster le comportement conversationnel plutôt que d'accepter une interface de sous-titrage fixe, elle reste responsable du transport audio, de la gestion d'état, du rendu partiel du texte, du stockage, de l'authentification, des permissions, des corrections et de l'expérience utilisateur finale.
Une erreur fréquente consiste à n'enregistrer que la dernière réponse ou à attendre uniquement la fin de la parole. Les recommandations officielles précisent qu'un énoncé long peut contenir plusieurs segments de transcription finalisés avant la fin détectée de la parole. L'application doit concaténer correctement les segments finaux.
Troisième voie : Utiliser AssemblyAI lorsque les étiquettes des locuteurs en streaming sont importantes
Assemblage IA Ce modèle de flux propose des transcriptions partielles et finales, l'identification des terminaisons, la suggestion de mots clés, l'horodatage des mots et prend en charge différents modes de diarisation des locuteurs. Sa documentation décrit également les événements de révision des locuteurs : le modèle peut corriger les étiquettes de locuteur précédentes à mesure qu'il recueille de nouvelles informations.
Ce comportement lors des révisions est crucial pour les interfaces en direct. Si une application marque “ Intervenant A ” comme permanent trop tôt, les corrections ultérieures risquent de ne jamais être prises en compte dans l'enregistrement. L'interface utilisateur doit donc impérativement définir une stratégie pour la gestion des étiquettes et des révisions en attente.
Choisir Assemblage IA Lorsque la diffusion en continu prenant en compte le locuteur et le contrôle au niveau de l'application sont importants, vérifiez le modèle exact, la prise en charge linguistique, le comportement de diarisation, les options médicales et les exigences en matière de données pour le déploiement prévu ; les fonctionnalités varient selon le modèle de diffusion.
Voie 4 : Utiliser Soniox pour les API de streaming multilingues
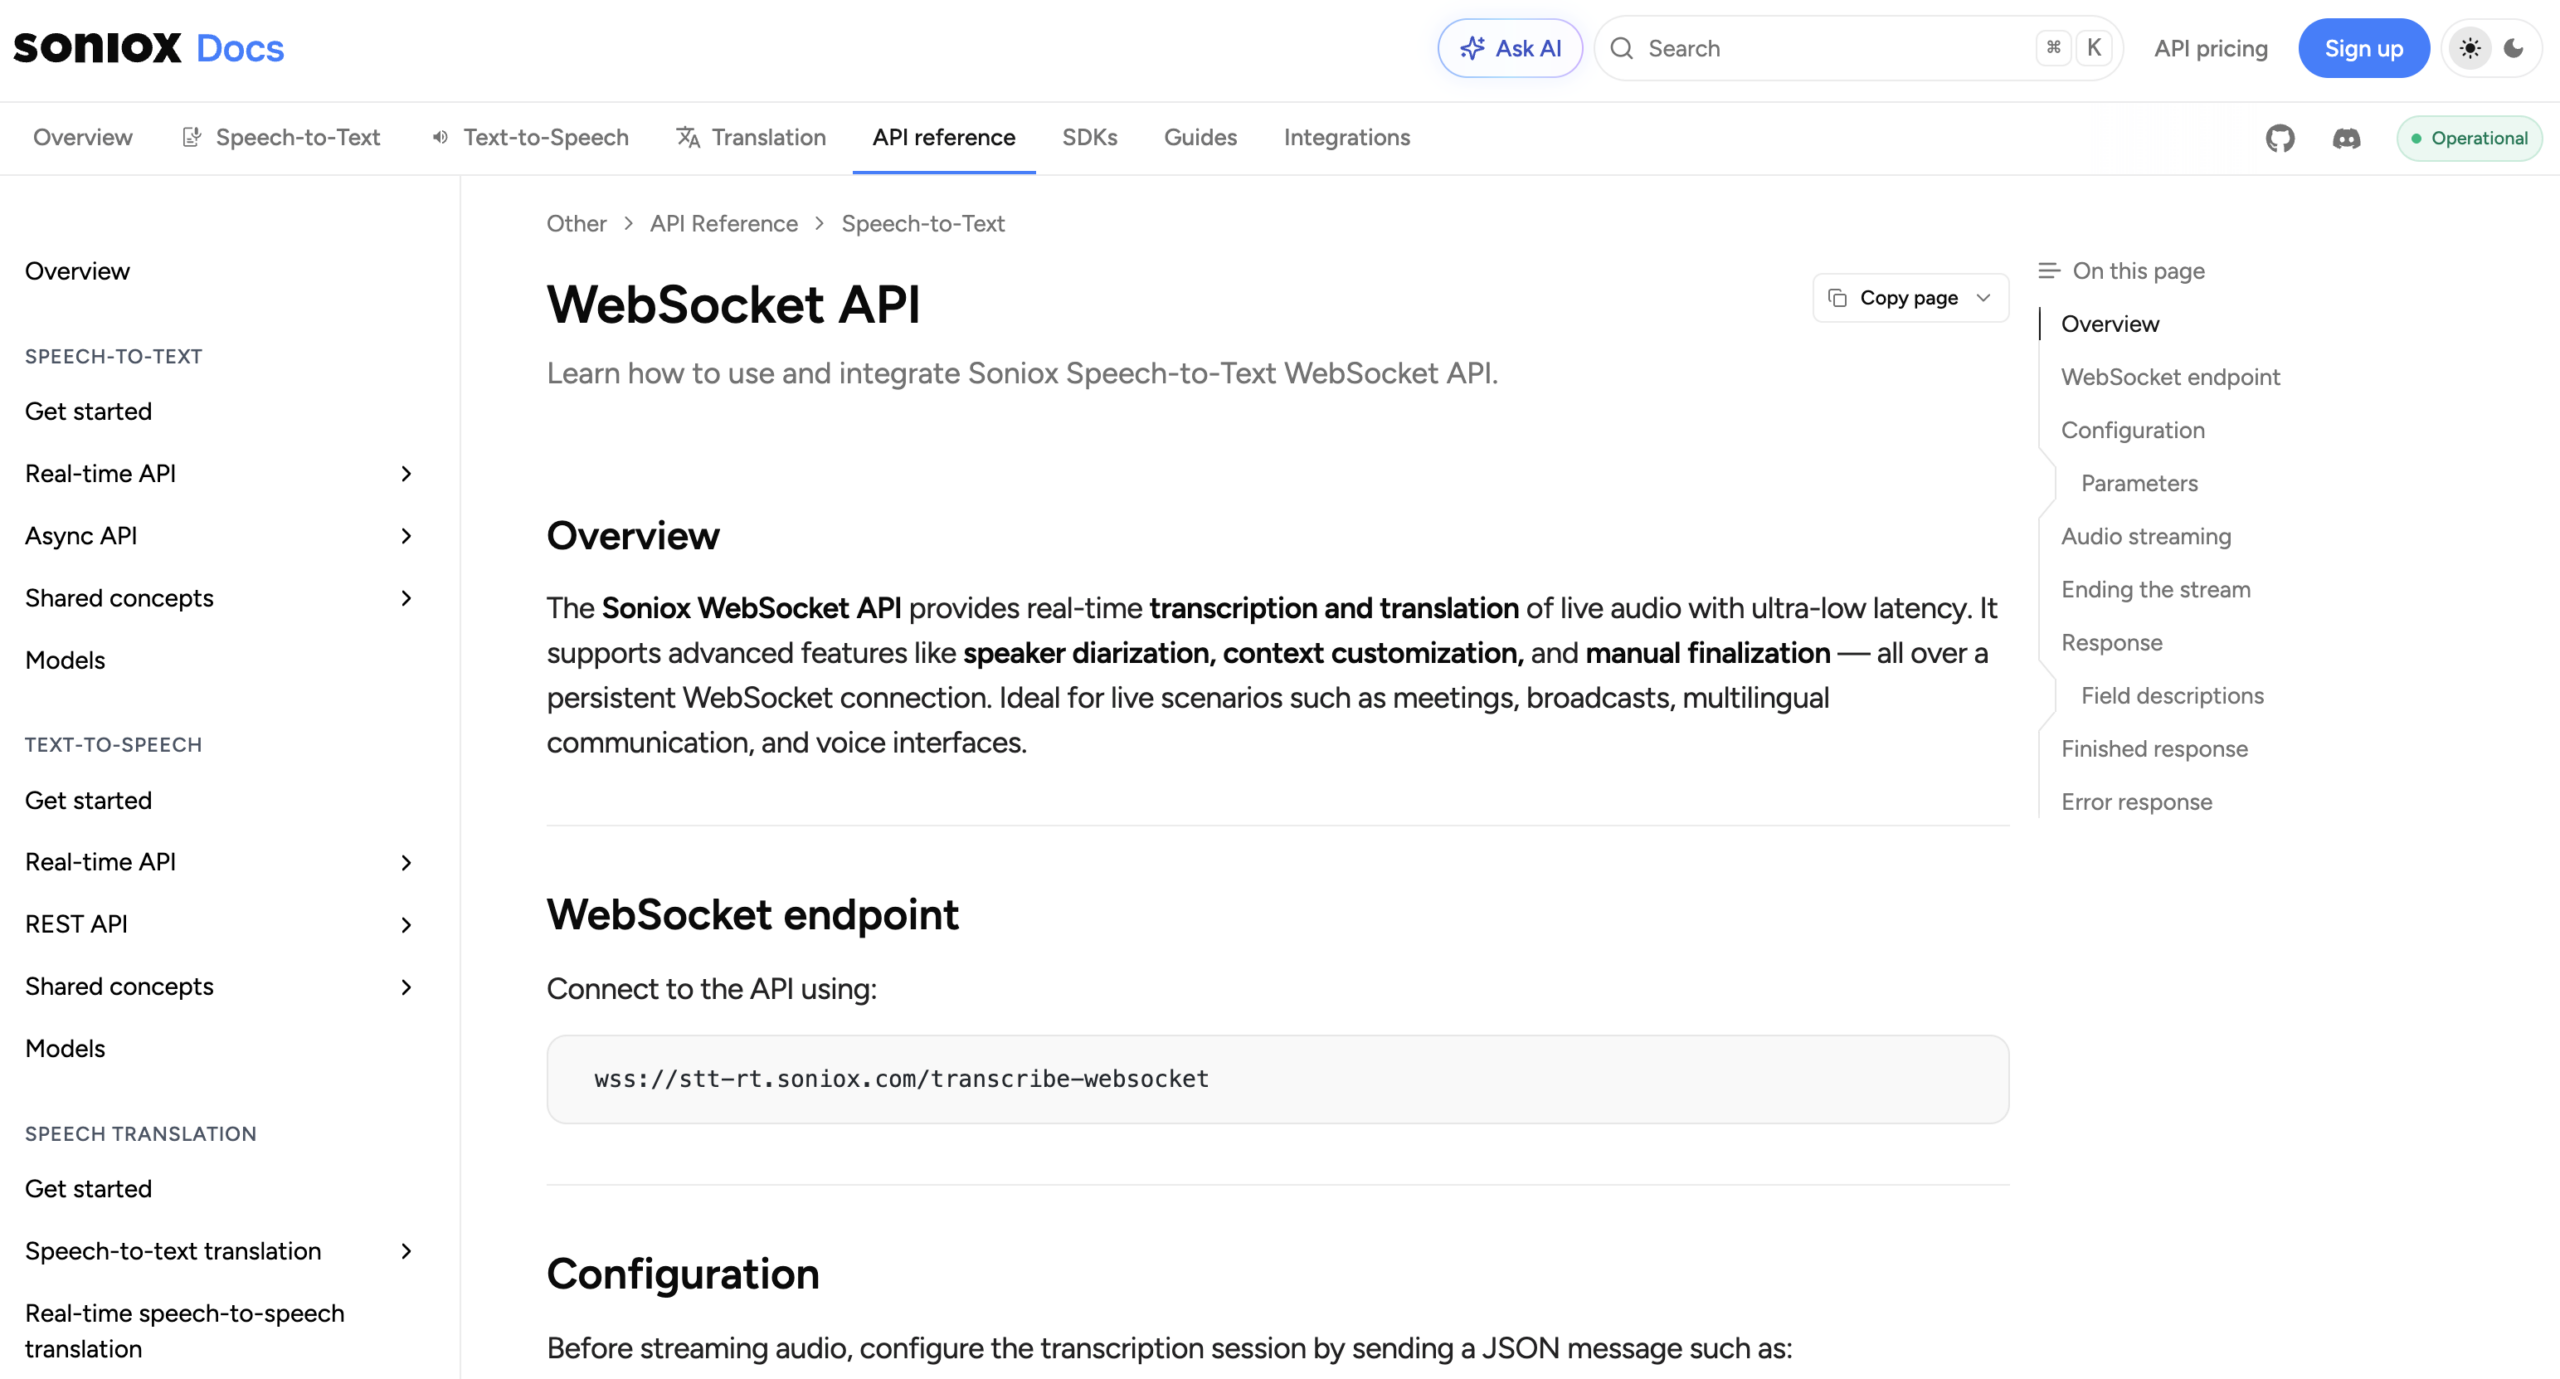
Soniox Ce service combine transcription et traduction en temps réel via son API WebSocket. L'interface actuelle prend en charge les indications linguistiques, la personnalisation du contexte, la diarisation des locuteurs, la configuration de la traduction, l'horodatage au niveau des jetons, le niveau de confiance, la finalité et les informations linguistiques.
Cela fait Soniox pertinent lorsque les développeurs le souhaitent conversion vocale en texte en temps réel et une sortie multilingue au sein de leur propre application. La configuration du contexte peut faciliter la gestion des termes du domaine, mais il convient de la tester avec un script de terminologie fixe plutôt que de la déduire du nom de la fonctionnalité.
Comme pour les autres API, ce service fournit des composants de base. L'acheteur doit néanmoins configurer l'accès des participants, les corrections, la conservation des données, les exportations, les synthèses, les contrôles d'administration, la surveillance, la récupération des erreurs et le support.
Pourquoi le taux d'erreurs lexicales ne suffit pas
Le taux d'erreur lexicale mesure les substitutions, les suppressions et les insertions par rapport à une transcription de référence. Il est utile, mais une simple moyenne peut masquer les erreurs les plus importantes.
Comparez ces deux erreurs :
- “ Nous pouvons expédier sur Jeudi” “ devient « Nous pouvons expédier sur Mardi.”
- “ Veuillez ouvrir le panneau des paramètres” “ devient « Veuillez ouvrir » un panneau de paramètres.”
Les deux peuvent avoir une valeur similaire, mais la première modifie un engagement. Constituez un registre des erreurs pour :
- Noms et identité des intervenants.
- Nombres, devises, dates et unités.
- Négations et conditions.
- Noms de produits et terminologie spécialisée.
- Alternance codique et changements linguistiques.
- Interruptions et autocorrections.
- Ponctuation qui change le sens.
Il faut ensuite tenir compte du facteur temps. Un mot correct prononcé après la prise de décision peut s'avérer erroné sur le plan opérationnel. Une erreur provisoire, corrigée ultérieurement, peut tout de même avoir incité un agent vocal ou un participant à agir.
Le droit conversion vocale en texte en temps réel Le score combine donc la gravité des erreurs factuelles, la stabilité, le rythme des interventions et la qualité de l'élocution, et non pas simplement la précision moyenne des mots.
La cassette de vérité en deux minutes
Utilisez une seule source audio enregistrée afin que chaque candidat reçoive le même son. Ne laissez pas chaque fournisseur choisir sa propre démo.
Scénario
- “Bonjour, je suis Niamh O'Rourke d'Aster-Q.”
- “ La référence est BX-417, et non BX-471. ”
- “ Le chiffre d'affaires s'est élevé à 15,05 millions de dollars, en hausse de 13,6 %. ”
- “ Ne renouvelez pas le contrat tant que l’accord de niveau de service n’est pas signé. ”
- “Expédier quinze… pardon, cinquante… unités jeudi.”
- “ L’API utilise le streaming WebSocket et un point de terminaison de 300 millisecondes. ”
- Faites une pause de 700 millisecondes au milieu d'une phrase conditionnelle.
- Laissez une deuxième personne intervenir, puis revenez au premier intervenant.
- Ajoutez une phrase dans la deuxième langue requise.
- Terminez par une phrase prononcée à voix basse, tandis que l'on entend le bruit d'un clavier.
Feuille de capture
| Mesures | Comment l'enregistrer | Transmettre la condition à définir avant le test |
|---|---|---|
| Délai avant le premier SMS | Début audio de la première hypothèse non vide | En fonction du besoin de l'utilisateur en matière de retour visuel |
| Temps pour un texte stable | Dernière parole prononcée jusqu'au texte final immuable | Assez rapidement pour que les gens ne tiennent pas compte des modifications. |
| Retard de finalité du tour | Déclencheur de fin de virage prévu vers le point final ou de réponse | N'interrompt pas les pauses normales et ne donne pas l'impression de ne pas réagir. |
| Nombre de révisions | Nombre de modifications d'hypothèses visibles ou au niveau de l'API | L'interface reste lisible et les actions en aval attendent leur finalisation. |
| Erreurs factuelles critiques | Noms, chiffres, négations, dates, unités et conditions | Aucune erreur grave non signalée dans le pilote |
| Récupération de l'étiquette du locuteur | Heure et exactitude après interruption | La transcription enregistrée reflète l'attribution corrigée |
| Achèvement du flux de travail | Fin de réunion pour l'enregistrement consultable/exportable ou l'action d'application | Respecte les délais opérationnels |
Effectuez dix essais, puis indiquez la médiane, le 95e percentile et le résultat le plus défavorable observé lorsque la taille de l'échantillon le permet. Un seul essai parfait ne suffit pas à établir la fiabilité.
Sept modes de défaillance et la première solution
| Symptôme | Couche probable | Premier contrôle utile |
|---|---|---|
| Le texte apparaît tardivement par rapport au premier mot | Capture, mise en mémoire tampon, encodage, réseau ou modèle | Mesurer chaque saut ; réduire les segments audio trop volumineux |
| Le texte apparaît rapidement mais est fortement réécrit. | Comportement de l'hypothèse intermédiaire | Attendez la décision finale avant d'entreprendre des actions ; repensez l'affichage provisoire. |
| Le système coupe les haut-parleurs réfléchis | Détection de seuil ou d'activité vocale au niveau du point de terminaison | Testez des pauses plus longues et ajustez les points de terminaison lorsque cela est possible. |
| Le système attend trop longtemps après des commandes courtes. | Seuil de point de terminaison ou logique de rotation d'application | Tester des seuils plus courts ou des commandes de fin de virage explicites |
| Les noms et les codes échouent de manière répétée | Ambiguïté acoustique et contexte de domaine manquant | Ajouter des termes clés/du contexte et améliorer la qualité du microphone |
| Les étiquettes des haut-parleurs changent après l'affichage | La diarisation en continu révise les clusters | Prendre en charge les étiquettes en attente et appliquer les événements de révision à l'enregistrement |
| La transcription est rapide mais inutilisable par la suite. | Flux de travail du produit manquant | Ajoutez des options de correction, de stockage, de recherche, d'autorisation, d'exportation et de suppression, ou choisissez une application finalisée. |
Dépannage conversion vocale en texte en temps réel De gauche à droite. Le remplacement du modèle ne corrigera pas une entrée muette, une fréquence d'échantillonnage incorrecte ni une interface utilisateur qui enregistre du texte provisoire comme version finale.
Quand la transcription vocale n'est pas la tâche finale
La transcription répond à la question : “ Quels mots ont été reconnus ? ” La traduction, quant à elle, répond : “ Que signifient ces mots dans une autre langue ? ” Le compte rendu d’une réunion doit également répondre à la question : “ L’autre personne peut-elle comprendre, répondre et retrouver la décision ultérieurement ? ”
Si tous les participants parlent la même langue et ont besoin de sous-titres, de dictée, de recherche ou d'analyses d'accessibilité, une API STT ou un logiciel de transcription dédié peut suffire. Si les participants utilisent des langues différentes, le flux de travail nécessite des contrôles supplémentaires.
- Texte source visible à côté de la traduction.
- Sélection de la langue ou gestion automatique.
- Préparation de la terminologie et du contexte.
- Texte en langue cible diffusé pendant la conversation.
- Voix traduite optionnelle lorsque la lecture est impossible.
- Documents et notes qui préservent la discussion multilingue.
C'est le point où conversion vocale en texte en temps réel devient un élément d'un ensemble plus vaste Transync AI le flux de travail plutôt que le produit final.
FAQ sur la conversion vocale en texte en temps réel
Qu'est-ce que la conversion vocale en texte en temps réel ?
Conversion vocale en texte en temps réel Ce système convertit le flux audio en texte provisoire puis définitif pendant la prise de parole. Il peut réviser ses premières hypothèses à mesure qu'il reçoit davantage de contexte, détecte la fin d'une intervention, applique la ponctuation ou améliore l'identification du locuteur.
Quel délai est considéré comme du temps réel ?
Il n'existe pas de seuil unique. Mesurez le temps d'affichage du premier texte, du texte stable, de la finalité de la prise de parole et du résultat exploitable du flux de travail. Les délais acceptables varient selon le type d'utilisateur : lecteur de sous-titres, agent vocal, participant à la réunion et relecteur après appel.
Pourquoi le texte en direct change-t-il constamment ?
Les systèmes de reconnaissance vocale en flux continu publient des hypothèses partielles avant même que la phrase soit complète. L'audio ultérieur peut modifier la formulation, la ponctuation, la langue ou le locuteur les plus probables. Les applications doivent distinguer les résultats provisoires du texte final.
La conversion de la parole en texte en temps réel est-elle la même chose que la traduction en direct ?
Non. La reconnaissance vocale reconnaît les mots prononcés dans la langue source. La traduction instantanée ajoute une autre transformation linguistique et peut également inclure la voix traduite. Transync AI combine la reconnaissance et la traduction pour les conversations multilingues.
Quelle API est la meilleure pour la conversion vocale en texte en temps réel ?
Il n'y a pas de vainqueur universel. Deepgram offre des contrôles détaillés des points de terminaison et de l'état des résultats, Assemblage IA offre une prise en charge de la diarisation en continu et du comportement de révision, et Soniox Ce module combine des options de transcription et de traduction multilingues. Testez chaque option avec un fichier audio identique et en respectant scrupuleusement les exigences du produit.
La transcription vocale en temps réel peut-elle identifier les locuteurs ?
Certains modèles prennent en charge la diarisation ou l'entrée multicanal, mais les étiquettes peuvent être provisoires et évoluer au fur et à mesure que de nouveaux signaux audio arrivent. Testez les interruptions, les voix similaires, les changements d'appareil et les corrections des étiquettes enregistrées.
Quels sont les premiers tests qu'une entreprise doit effectuer ?
Commencez par le trajet audio proprement dit et un script de deux minutes contenant les noms, les chiffres, les négations, les corrections, les pauses, les interruptions, la terminologie et les langues requises. Mesurez les quatre horloges et examinez l'enregistrement sauvegardé.
Verdict final
Le plus rapide conversion vocale en texte en temps réel Le système n'est pas nécessairement celui qui affiche le premier mot en premier. Un système fiable équilibre quatre horloges :
premier texte → texte stable → tour terminé → enregistrement utilisable
Optez pour une API de streaming lorsque les développeurs doivent contrôler les points de terminaison, les résultats partiels, les modifications des intervenants et le comportement de l'application. Choisissez une solution de réunion clé en main lorsque l'équipe a besoin de l'ensemble du processus, de l'audio aux sous-titres, en passant par la traduction, les enregistrements et les notes, sans avoir à développer l'infrastructure nécessaire.
Surtout, testez les données d'entrée réelles et les conséquences réelles. Mesurez le mot qui apparaît, le mot qui change, le tour de parole qui se termine et le résultat auquel on pourra se fier par la suite.