Funkcja zamiany mowy na tekst w czasie rzeczywistym to coś więcej niż tylko szybkie napisy. Przed dokonaniem wyboru zmierz 4 ukryte zegary, popraw je, uwzględnij obsługę mówcy i dostosuj do wielojęzycznego spotkania.
Przetwarzanie mowy na tekst w czasie rzeczywistym może wyglądać doskonale w wersji demonstracyjnej, ale i tak nie zadziałać w rozmowie. Pierwsze słowa mogą pojawić się po 300 milisekundach, ale zdanie może się zmieniać przez dwie sekundy. Etykieta mówcy może zostać dostarczona, a następnie poprawiona. Dopracowany transkrypt może być gotowy szybko, ale z pominięciem negacji, która zmieniła decyzję.
Dlatego pytanie “Jak szybko?” jest niewłaściwe. Do poprawnej oceny potrzebne są cztery zegary: czas do pierwszego tekstu, czas do stabilnego tekstu, czas do ukończenia obrotu i czas do użytecznego zapisu. Każdy zegar odpowiada na inną potrzebę operacyjną.
W tym artykule omówiono zamiana mowy na tekst w czasie rzeczywistym jako mierzalny kanał, a nie efekt wizualny. Porównuje specjalistyczne interfejsy API do strumieniowania z gotowym do użycia wielojęzycznym produktem do obsługi spotkań, dostarcza powtarzalny skrypt testowy i wyjaśnia, kiedy sama transkrypcja jest niewystarczająca, ponieważ uczestnicy potrzebują tłumaczenia, głosu lub notatek.
Odpowiedź w 60 sekund
Mowa w czasie rzeczywistym na tekst Konwertuje strumień audio na żywo na tekst, gdy mówca wciąż mówi. Wyświetlany tekst jest często tymczasowy. Wczesne słowa można modyfikować, gdy model otrzymuje więcej kontekstu, wykrywa pauzę, identyfikuje mówcę, stosuje interpunkcję lub finalizuje wypowiedź.
Cztery zegary to:
- Opóźnienie pierwszego tekstu: Jak długo trzeba czekać na pojawienie się jakiejś hipotezy?
- Opóźnienie stabilności: Jak długo minie, zanim słowa przestaną się zmieniać?
- Opóźnienie finalizacji tury: Ile czasu upłynie zanim system uzna, że dana kolej mówienia lub wypowiedź dobiegła końca?
- Opóźnienie przepływu pracy: Jak długo trzeba czekać, aż transkrypt będzie można wykorzystać do wyszukiwania, robienia notatek, wykonywania działań, tłumaczenia lub reagowania na aplikacje?
Agent głosowy może priorytetowo traktować finalizację tury, ponieważ musi zdecydować, kiedy odpowiedzieć. Napisy ułatwiające dostęp mogą priorytetowo traktować szybki, czytelny fragment tekstu. Zapis spotkania może tolerować nieco wolniejsze wyświetlanie, jeśli nazwiska, numery i przypisanie mówcy staną się bardziej wiarygodne. Spotkanie wielojęzyczne dodaje kolejny etap po rozpoznaniu: tłumaczenie musi dotrzeć wystarczająco szybko, aby ktoś mógł odpowiedzieć.
Przetwarzanie mowy na tekst w czasie rzeczywistym to ruchoma hipoteza
Transkrypcji na żywo nie tworzy się w jednym kroku:
mikrofon lub dźwięk systemowy → kodowanie i przesyłanie → wykrywanie mowy → rozpoznanie tymczasowe → rewizja → finalizacja → etykietowanie i formatowanie mówcy → działanie aplikacji
Ekran zazwyczaj wyświetla tylko środek. To stwarza powszechne złudzenie: ponieważ tekst pojawia się natychmiast, użytkownicy zakładają, że efekt jest gotowy. W rzeczywistości silnik może nadal analizować granice słów, interpunkcję, język lub tożsamość osoby mówiącej.
Specjalistyczne interfejsy API wyraźnie to rozróżnienie zaznaczają. Deepgram Zwraca oddzielnie wyniki tymczasowe i sfinalizowane. W dokumentacji wyjaśniono, że tekst wstępny może ulec zmianie, natomiast sfinalizowane segmenty należy dołączyć, aby odtworzyć pełną wypowiedź. Oddzielny sygnał zakończenia mowy wskazuje, że system wykrył punkt końcowy, taki jak pauza.
Soniox ujawnia ostateczne i nieostateczne tokeny, znaczniki czasu, pewność, informacje o języku, opcjonalne etykiety mówców i postęp przetwarzania przez stałe połączenie strumieniowe. AssemblyAI podobnie oferuje częściowe i ostateczne transkrypcje, określanie punktów końcowych, znaczniki czasu na poziomie słów, podpowiedzi dotyczące słów kluczowych i strumieniowe dzienniki mówcy w obsługiwanych modelach.
Te elementy sterujące są przydatne dla programistów. Ujawniają również, dlaczego użytkownik końcowy nie powinien oceniać zamiana mowy na tekst w czasie rzeczywistym tylko na podstawie pierwszej widocznej linii.
Zegar 1: Czas na wysłanie pierwszego SMS-a
Pierwszy zegar zaczyna biec, gdy sygnał mowy dociera do systemu, a kończy, gdy pierwsza niepusta hipoteza staje się widoczna lub dostępna dla aplikacji.
Pomiar ten obejmuje więcej niż tylko wnioskowanie na podstawie modelu:
- Nagrywanie dźwięku z mikrofonu lub ze spotkania.
- Rozmiar bufora i dzielenie dźwięku.
- Ponowne próbkowanie lub kodowanie.
- Transport sieciowy.
- Przetwarzanie serwera.
- Transport powrotny.
- Renderowanie interfejsu.
Mierzyć zamiana mowy na tekst w czasie rzeczywistym z rzeczywistego urządzenia użytkownika, a nie z pulpitu API. Numer po stronie serwera dostawcy może wykluczać buforowanie dźwięku, sieć klienta, renderowanie w przeglądarce i opóźnienie platformy konferencyjnej.
Szybki pierwszy tekst jest cenny, gdy użytkownicy potrzebują pewności, że system ich słucha. Jest mniej przydatny, gdy interfejs zachęca ich do działania w przypadku niestabilnych słów. Dobry projekt napisów wizualnie wyróżnia tymczasowy tekst, nie czyniąc go nieczytelnym.
Jak przetestować pierwszy zegar
Nagraj ten sam dźwięk i ekran z prędkością 60 klatek na sekundę. Klaśnij raz, a następnie powiedz: “Odnowienie nie zostało zatwierdzone”. Zaznacz klatkę, w której przebieg fali lub klaśnięcie dociera do wejścia, oraz klatkę, w której pojawia się pierwszy tekst. Powtórz dziesięć razy i podaj medianę i najwolniejszy wynik, a nie najlepszy przebieg.
Test zamiana mowy na tekst w czasie rzeczywistym W przypadku standardowego Wi-Fi, przeciążonej sieci, laptopa z redukcją szumów oraz zestawu słuchawkowego lub mikrofonu w pomieszczeniu, prędkość pierwszego tekstu, która zanika przy normalnym obciążeniu, nie jest niezawodną cechą produktu.
Zegar 2: Czas do stabilnego tekstu
Drugi zegar zatrzymuje się, gdy zakres tekstu nie będzie się już zmieniał. To zegar, który większość prezentacji marketingowych ukrywa.
Rozważmy powiedzianą frazę:
“Wysłać piętnaście — przepraszam, pięćdziesiąt — jednostek w czwartek”.”
Wyświetlanie może przebiegać przez “ship 15”, następnie “ship 50”, a następnie z poprawkami interpunkcyjnymi. Pierwsza wersja dotarła szybko, ale tylko wersja ostateczna jest bezpieczna do skopiowania do zamówienia.
Stabilność ma znaczenie, ponieważ systemy niższego szczebla mogą zareagować zbyt wcześnie. Podsumowanie na żywo, asystent sprzedaży, wyzwalacz zgodności, warstwa tłumaczeniowa lub agent głosowy mogą odziedziczyć błąd tymczasowy. W zamiana mowy na tekst w czasie rzeczywistym przepływie pracy programiści powinni przetwarzać sygnały ostateczności silnika, zamiast traktować każdą częściową aktualizację jako zakończone polecenie.
Zmierz odległość rewizji, nie tylko opóźnienie
Dla każdego zdania testowego zapisz:
- Liczba wersji tymczasowych.
- Liczba zastąpionych lub usuniętych słów.
- Czas pomiędzy ostatnim wypowiedzianym słowem a stabilnym tekstem.
- Czy ostatecznie zapisany transkrypt pasuje do stabilnego wyświetlacza.
- Czy przed osiągnięciem stabilności uruchomiono działanie następcze.
Nieco wolniej zamiana mowy na tekst w czasie rzeczywistym System może być bezpieczniejszy, jeśli będzie wprowadzał mniej agresywne zmiany. Właściwy kompromis zależy od tego, czy użytkownicy czytają, dyktują, kontrolują oprogramowanie, czy prowadzą negocjacje.
Zegar 3: Czas do ukończenia tury
Słowa mogą być ostateczne, podczas gdy kolej mówienia jeszcze nie. Użytkownik może zrobić pauzę, aby pomyśleć, odetchnąć, poszukać postaci lub przeczekać przerwę. Jeśli system ogłosi zakończenie tury zbyt wcześnie, asystent głosowy może przejąć głos użytkownika. Jeśli czeka zbyt długo, rozmowa wydaje się nieaktywna.
Zazwyczaj w celu stwierdzenia, że mowa ustała, stosuje się ciszę lub aktywność głosową. Deepgram dokumenty konfigurowalne punkty końcowe i oddzielne jest_ostateczny I przemówienie_końcowe W wytycznych zaznaczono, że krótkie progi mogą odpowiadać krótkim odpowiedziom chatbota, podczas gdy dłuższe przerwy w rozmowie mogą wymagać setek milisekund, zanim ruch zostanie uznany za zakończony.
Nie ma uniwersalnego scenariusza, który sprawdziłby się u każdego mówcy. Szybki scenariusz rozmowy telefonicznej, niepewna historia medyczna, wykład w sali wykładowej i dwujęzyczna negocjacja mają różne schematy pauz. Dlatego finalizacja tury jest kluczowa. zamiana mowy na tekst w czasie rzeczywistym pomiar, a nie tylko ustawienie API.
Wykonaj test wahania
Użyj tych czterech linii:
- “Mój numer konta to … 4172.”
- “Zgadzam się… jeśli termin dostawy pozostanie piątek.”
- “Dawka wynosi piętnaście – nie, pięćdziesiąt – miligramów.”
- “Ana, czy możesz…” – po czym przerwał jej drugi mówca.
Zlicz fałszywe zakończenia, późne punkty końcowe, przerwy i obcięte słowa. Następnie dostosuj próg punktu końcowego tylko wtedy, gdy aplikacja go udostępnia. Jeśli produkt jest ukończoną aplikacją, obserwuj zachowanie i zdecyduj, czy pasuje do zadania.
Ten zegar jest tam, gdzie zamiana mowy na tekst w czasie rzeczywistym staje się inżynierią konwersacji, a nie zwykłą transkrypcją.
Zegar 4: Czas na użyteczny rekord
Czwarty zegar jest najważniejszy dla zespołów. Kończy się, gdy wynik może być wykorzystany do następnej akcji.
“Użyteczny” może oznaczać:
- Napisy pozostają czytelne w trakcie sesji.
- Można zidentyfikować mówców.
- Nazwy, numery i terminologia są możliwe do poprawienia.
- Pełny zapis można skopiować lub wyeksportować.
- Rekord jest przeszukiwalny i wymaga uprawnień.
- Generowane jest podsumowanie i elementy działań.
- Tekst źródłowy i przetłumaczony pozostają w parze.
- Rozumie się przez to przechowywanie i usuwanie danych.
System może wygrać pierwsze trzy zegary, ale przegrać czwarty. Surowy strumieniowy JSON nie jest zapisem spotkania. Szybkie napisy, które znikają, nie stanowią dowodu. Piękne podsumowanie bez transkryptu, który można prześledzić, może ukryć błędy rozpoznania. Właśnie dlatego zamiana mowy na tekst w czasie rzeczywistym dział zaopatrzenia musi mierzyć zarówno gotowy przepływ pracy, jak i model przesyłania strumieniowego.
Mowa w czasie rzeczywistym na tekst Należy zatem oceniać je w momencie użytkowania, a nie w momencie generowania. Poproś uczestnika, recenzenta, programistę i administratora o przetestowanie tej samej sesji z własnej perspektywy.
Cztery trasy porównane przez cztery zegary
| Produkt | Typ produktu | Pierwszy tekst | Kontrola stabilności i ostateczności | Obsługa głośników | Rola wielojęzyczna | Przepływ pracy z użytecznymi rekordami | Najlepiej pasuje |
|---|---|---|---|---|---|---|---|
| Transync AI | Gotowa do użycia aplikacja do tłumaczeń spotkań | Dwujęzyczny wyświetlacz na żywo | Zarządzane przez produkt, a nie udostępniane jako parametry API | Automatyczne rozróżnianie wybranej pary językowej; przegląd w tekście oryginalnym i przetłumaczonym | 60 języków, napisy dwujęzyczne, tłumaczenie głosowe | Zapis tłumaczenia, transkrypt i podsumowanie spotkania AI | Osoby i zespoły potrzebujące bezpośredniej komunikacji międzyjęzykowej bez konieczności tworzenia aplikacji |
| Deepgram | API strumieniowego przetwarzania mowy na tekst | Można włączyć wyniki tymczasowe | Udostępnia wyniki tymczasowe/końcowe, punkty końcowe, zdarzenia końcowe mowy, sterowanie końcem wypowiedzi i ręczną finalizację | Opcje diaryzacji i wielokanałowości zależą od konfiguracji/modelu | Opcje języka i modelu przesyłania strumieniowego; tłumaczenie jest osobną decyzją w ramach przepływu pracy | Klient musi stworzyć przestrzeń do przechowywania, edycji, uprawnień, podsumowań i interfejsu użytkownika | Programiści tworzący agentów głosowych, napisy, rozwiązania do analizy połączeń lub niestandardowe produkty do transkrypcji |
| AssemblyAI | API strumieniowego przetwarzania mowy na tekst | Częściowe transkrypty zwrócone poprzez połączenie strumieniowe | Inteligentne punkty końcowe i niezmienne, sfinalizowane transkrypty; obowiązuje zachowanie specyficzne dla modelu | W obsługiwanych modelach dostępne są strumieniowe wydarzenia związane z dziennikarstwem i przeglądami mówców | Model przesyłania strumieniowego wielojęzycznego obsługuje opublikowany zestaw języków | Klient tworzy gotową aplikację i cykl życia rekordów | Zespoły produktowe potrzebujące rozpoznawania strumieniowego z wykorzystaniem diaryzacji i informacji downstream |
| Soniox | API sztucznej inteligencji mowy w czasie rzeczywistym | Strumień tokenów nieostatecznych z niskim opóźnieniem | Flagi tokenów końcowych, finalizacja ręczna, znaczniki czasu tokenów i postęp przetwarzania | Opcjonalne diarowanie mówców | Transkrypcja i tłumaczenie wielojęzyczne w czasie rzeczywistym za pomocą konfiguracji API | Klient buduje interfejs, trwałość, przegląd i zarządzanie | Deweloperzy tworzący wielojęzyczne spotkania, transmisje, asystentów lub interfejsy głosowe |
Możliwości produktu zostały sprawdzone pod kątem zgodności z oficjalną dokumentacją produktu w dniu 3 października 2026 r. Modele, języki, ograniczenia i ceny mogą ulec zmianie.
Tabela nie wskazuje jednego uniwersalnego zwycięzcy. Rozróżnia dwie decyzje zakupowe: zbudować produkt w oparciu o API strumieniowe lub skorzystać z gotowego procesu. Najlepszy zamiana mowy na tekst w czasie rzeczywistym trasa zależy od tego, kto jest właścicielem przechwytywania dźwięku, projektu interfejsu, korekt, przechowywania i wsparcia.
Trasa 1: Użyj sztucznej inteligencji Transync, gdy mowa musi przekraczać granice języków
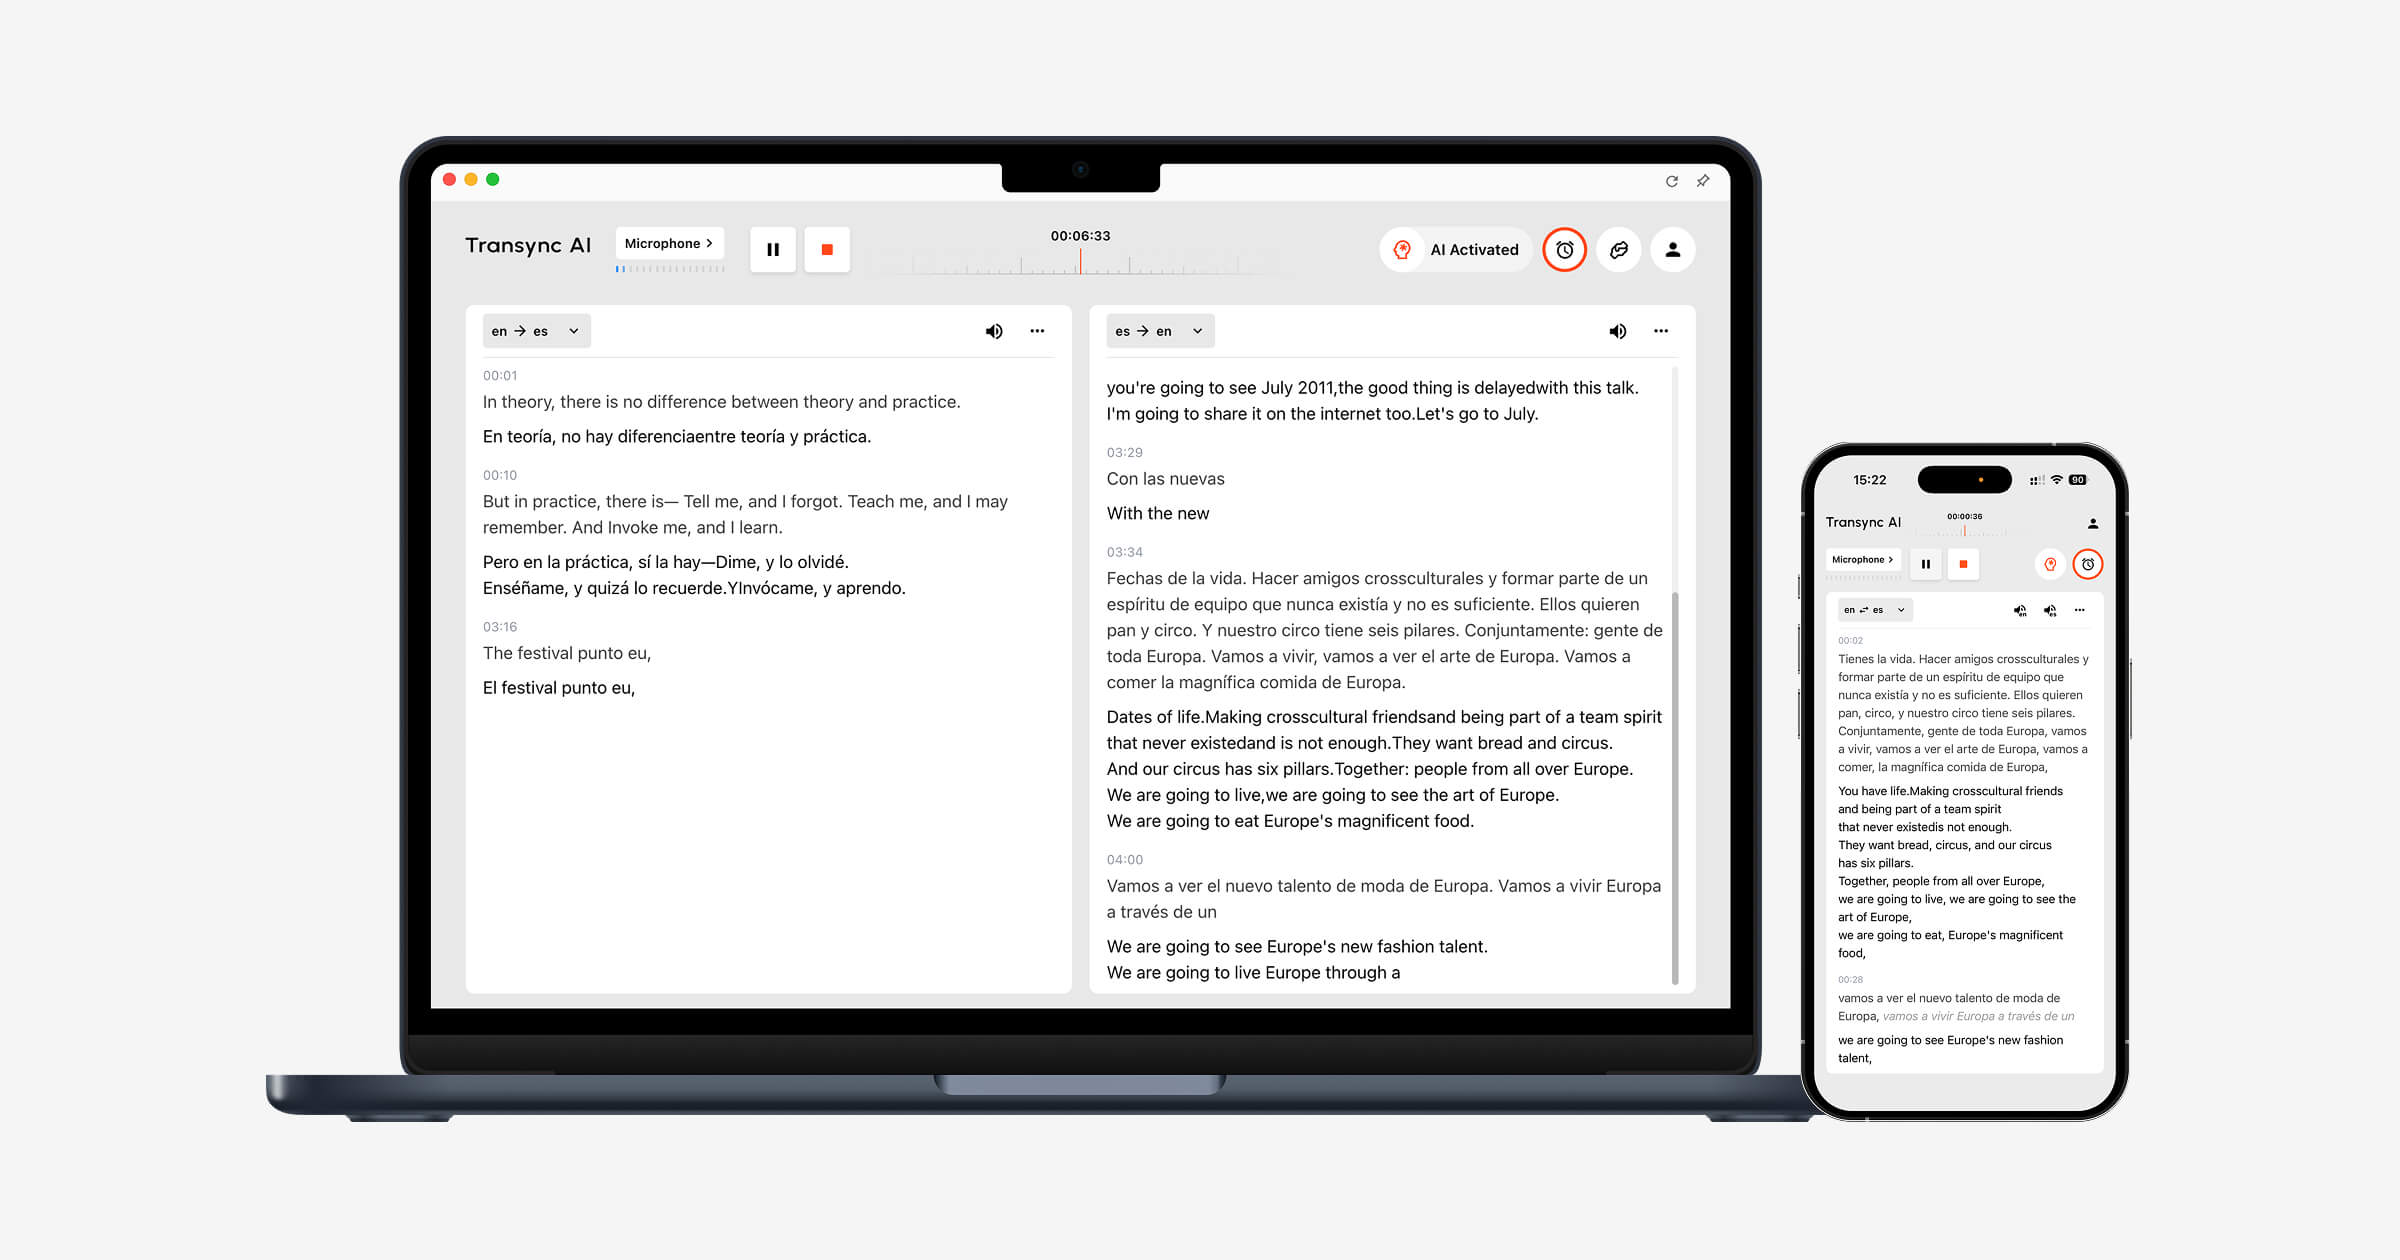
Transync AI Nie jest sprzedawany jako uniwersalny interfejs API do konwersji mowy na tekst. Jest to gotowy do użycia produkt do spotkań i rozmów, który łączy rozpoznawanie mowy z tłumaczeniem. przepływ pracy nad tłumaczeniem w czasie rzeczywistym obsługuje 60 języków i wyświetla oryginalną mowę obok przetłumaczonego tekstu, co pomaga użytkownikom oddzielić błędy rozpoznania od błędów tłumaczenia.
W przypadku połączeń online: tłumaczenie spotkania na żywo może współpracować z różnymi środowiskami konferencyjnymi za pośrednictwem wybranego mikrofonu lub ścieżki komputerowo-audio. Napisy obraz w obrazie zachować dwujęzyczny tekst widoczny nad obsługiwanymi aplikacjami zamiast zmuszać użytkownika do oglądania osobnej zakładki z transkrypcją.
Przed połączeniem, Słowa kluczowe i kontekst Potrafi przygotować nazwy, akronimy, terminy produktowe i kontekst. Po sesji transkrypt zachowuje tekst oryginalny i przetłumaczony, podczas gdy Notatki ze spotkania AI może generować podsumowania i listy zadań. Aktualny przewodnik po transkrypcjach podaje, że podsumowania spotkań można generować w 55 językach.
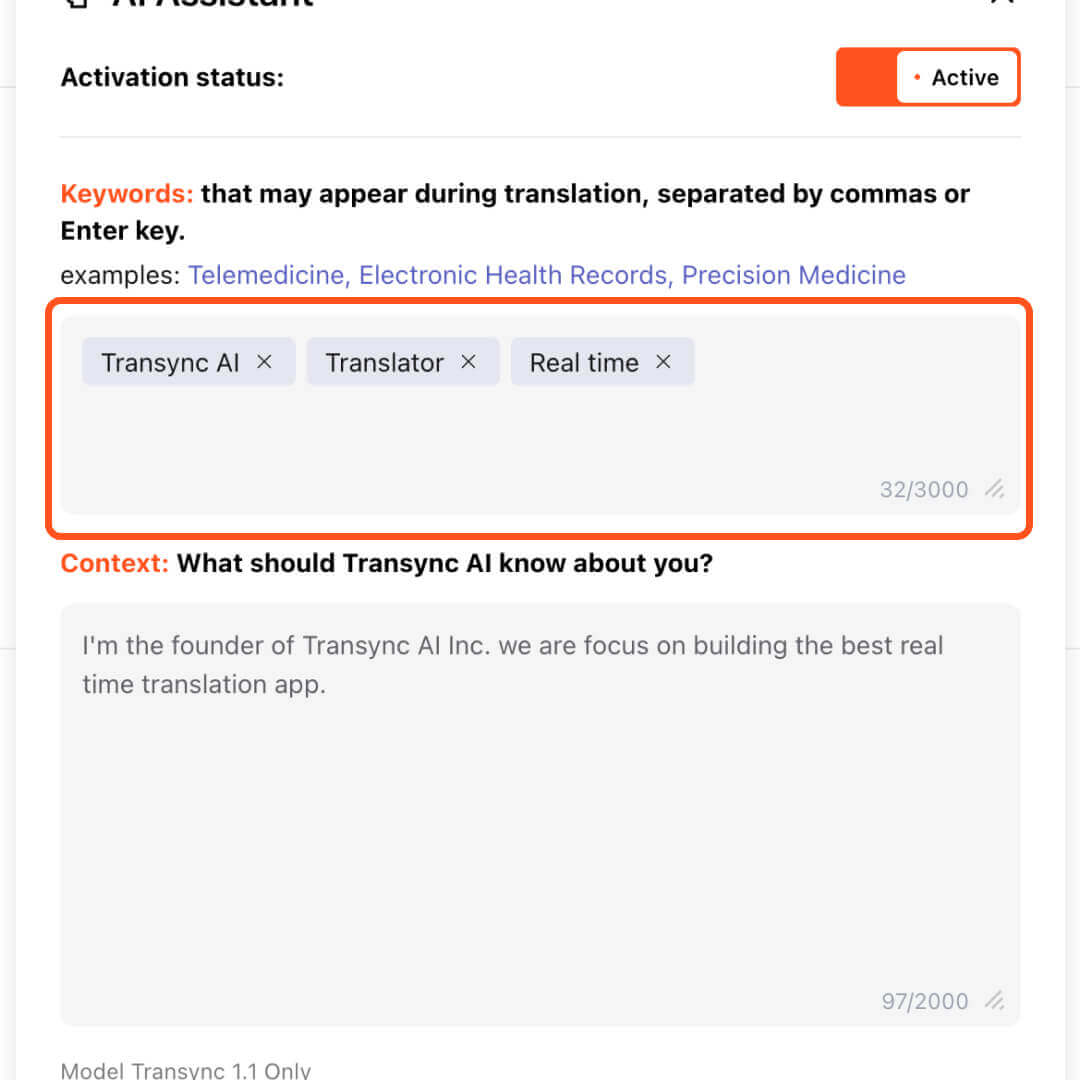
Interfejs Transync AI wyróżnia panel aktywacji asystenta AI słowami kluczowymi ‘Transync AI’, ‘Tłumacz’ i ‘Czas rzeczywisty’, pokazując, jak wprowadzać niestandardowe słowa kluczowe w celu uzyskania dokładnych tłumaczeń.
Wybierać Transync AI Gdy celem biznesowym jest zrozumienie i reagowanie w różnych językach. Wybierz API strumieniowe, gdy zespół tworzy własnego agenta głosowego, platformę do analizy połączeń, produkt ułatwiający dostęp lub wbudowany interfejs transkrypcji.
Ograniczenie jest istotne: Transync AI Nie jest to uniwersalny moduł dyktowania offline ani punkt końcowy STT dla programistów. Przed kolejnym spotkaniem należy przetestować routing audio, jakość sieci, pary językowe, mikrofony i zdalną transmisję.
Trasa 2: Użyj Deepgramu, gdy czas tury jest częścią produktu
Deepgram jest szczególnie pouczający dla programistów, ponieważ jego dokumentacja oddziela wyniki pośrednie, sfinalizowane segmenty, wykryte punkty końcowe mowy i zdarzenia kończące wypowiedź. To rozdzielenie pozwala aplikacji decydować, kiedy wyświetlić tekst, dołączyć tekst stały lub wywołać odpowiedź.
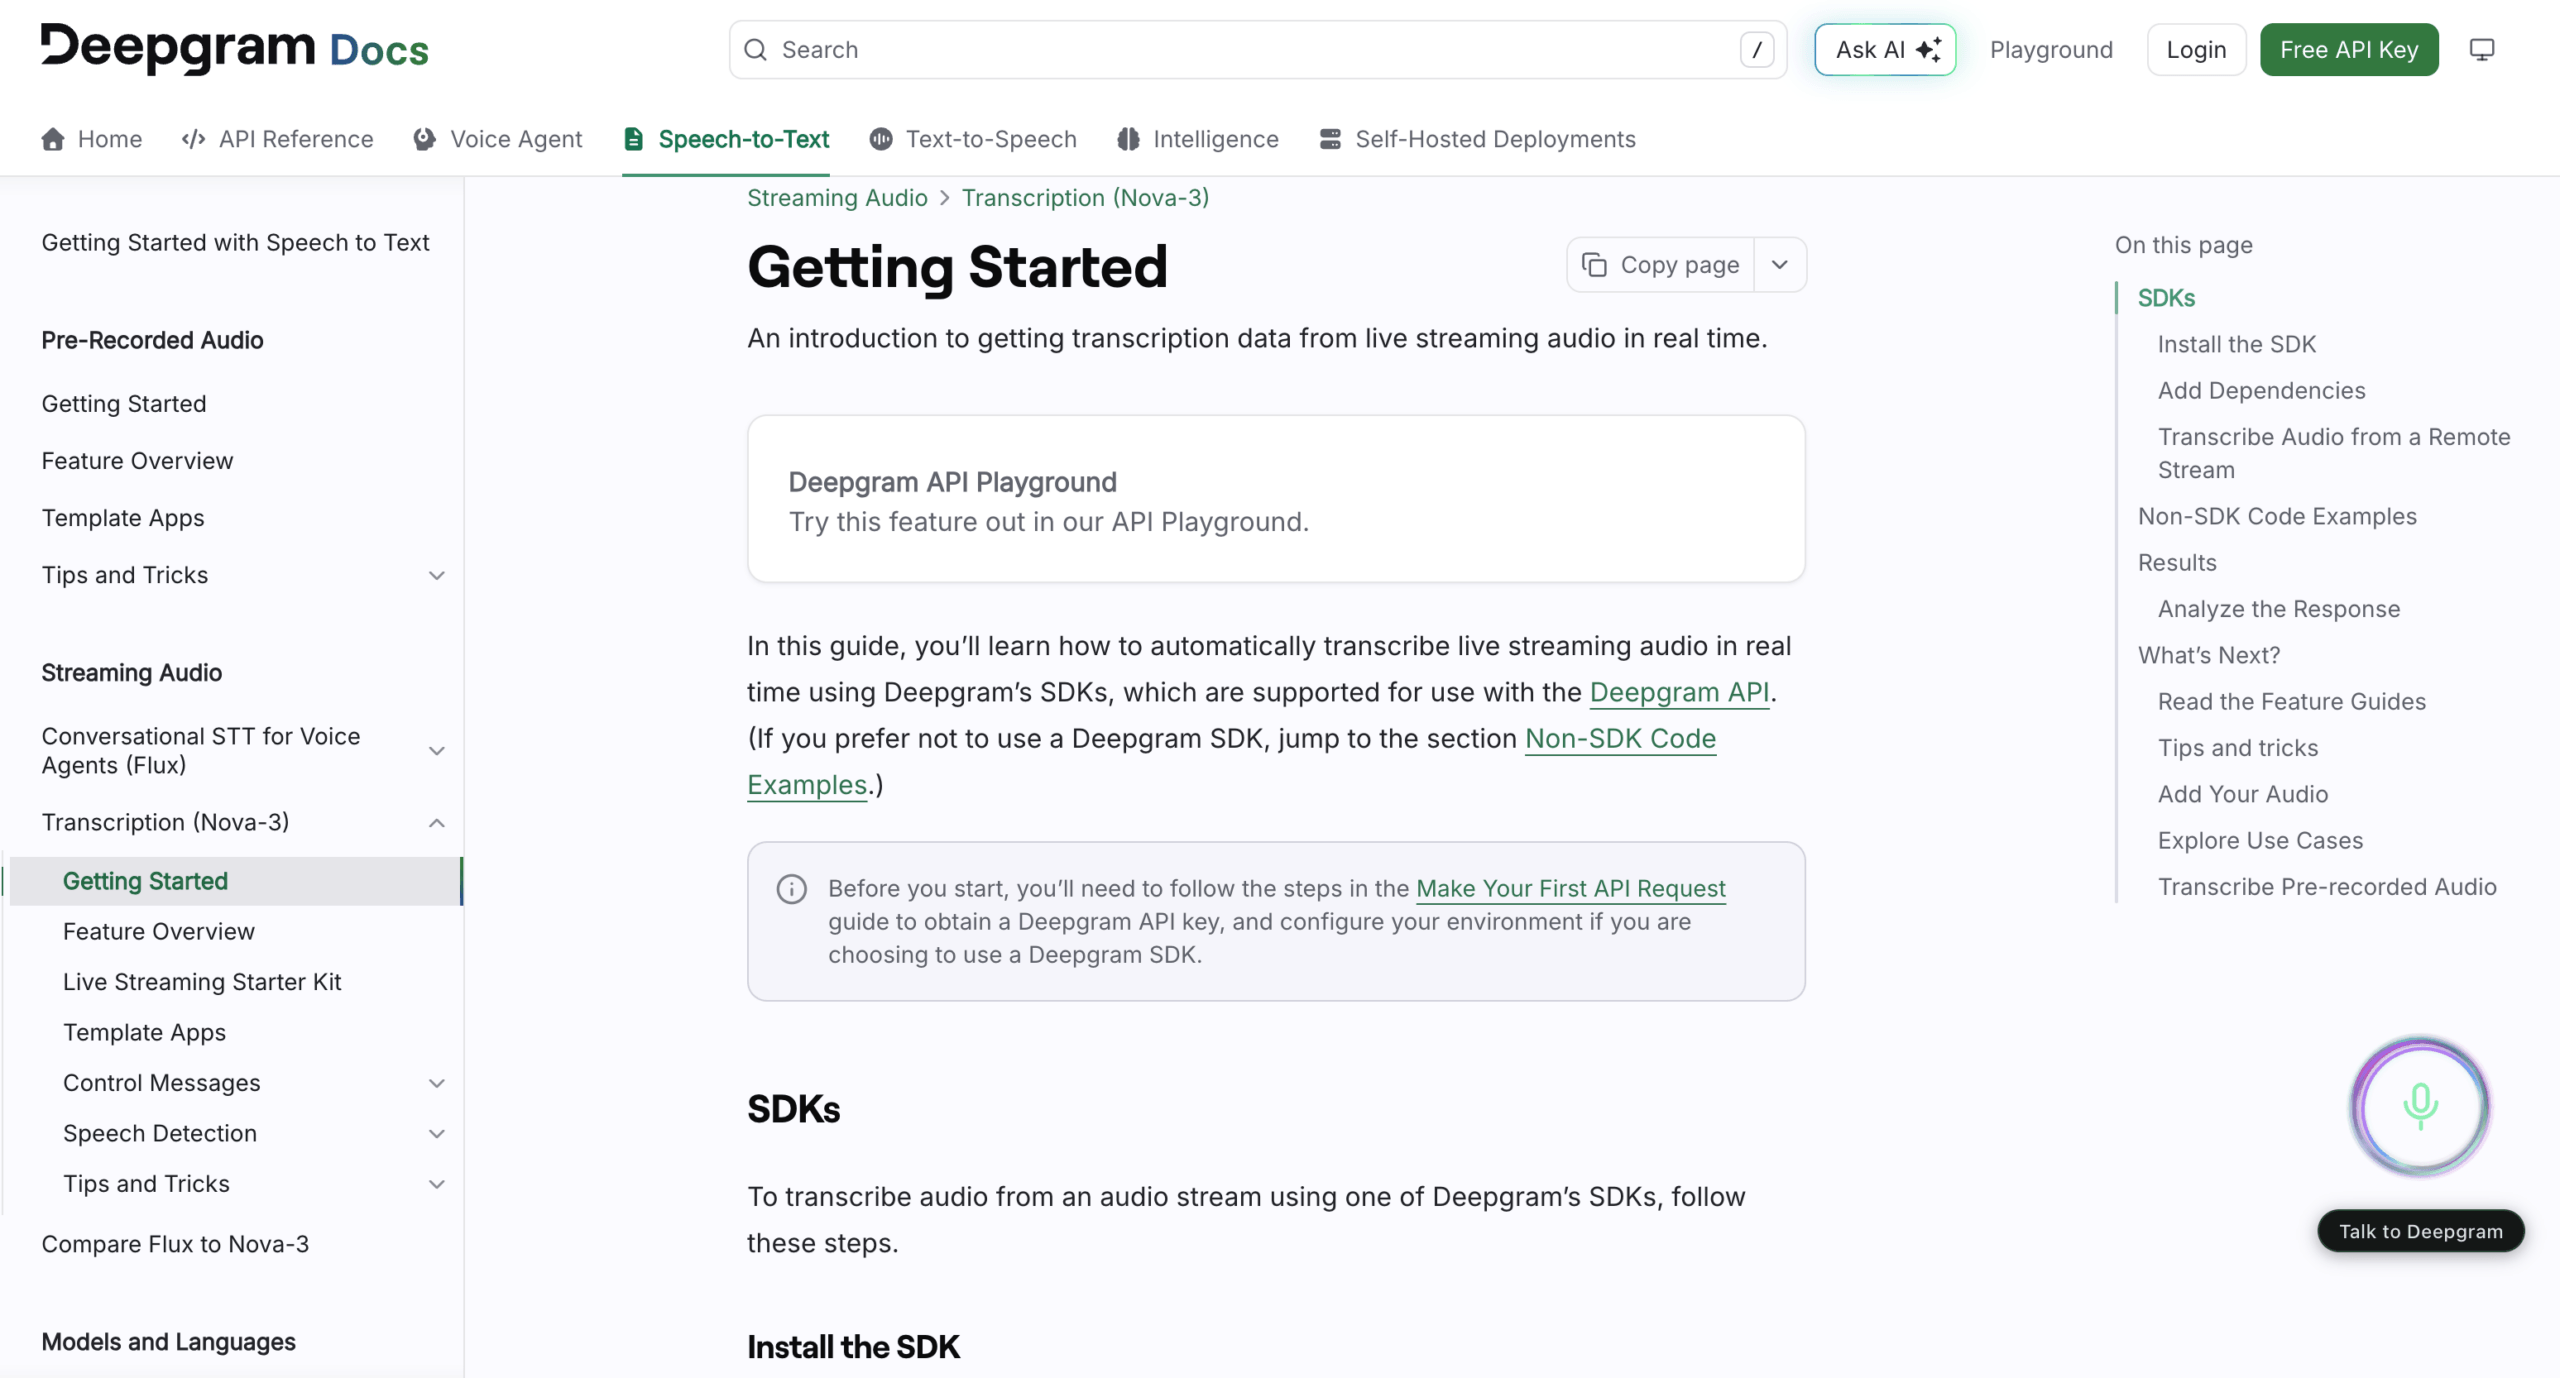
Używać Deepgram gdy zespół produktowy musi dostosować sposób prowadzenia konwersacji, zamiast akceptować stały interfejs napisów. Zespół nadal odpowiada za transmisję dźwięku, zarządzanie stanem, renderowanie części tekstu, przechowywanie, uwierzytelnianie, uprawnienia, poprawki i końcowe wrażenia użytkownika.
Częstym błędem implementacyjnym jest zapisywanie tylko najnowszej odpowiedzi lub oczekiwanie tylko na zdarzenie końcowe mowy. Oficjalne wytyczne wyjaśniają, że długa wypowiedź może zawierać wiele sfinalizowanych segmentów transkryptu przed wykryciem końca mowy. Aplikacja musi poprawnie łączyć segmenty końcowe.
Trasa 3: Użyj AssemblyAI, gdy etykiety głośników przesyłanych strumieniowo mają znaczenie
AssemblyAI Zapewnia modele strumieniowe z transkryptami częściowymi i końcowymi, punktami końcowymi, podpowiedziami dotyczącymi słów kluczowych, znacznikami czasu słów oraz obsługiwanymi trybami dzienników mówców. Dokumentacja opisuje również zdarzenia rewizji mówców: model może korygować wcześniejsze oznaczenia mówców w miarę gromadzenia kolejnych dowodów.
To zachowanie rewizji ma znaczenie w interfejsach na żywo. Jeśli aplikacja zbyt wcześnie ustawi “Głośnik A” jako stały, późniejsze poprawki mogą nigdy nie dotrzeć do zapisanego rekordu. Interfejs użytkownika wymaga przemyślanej strategii dotyczącej oczekujących etykiet i rewizji.
Wybierać AssemblyAI Gdy istotne jest strumieniowanie z uwzględnieniem mówcy i kontrola na poziomie aplikacji. Potwierdź dokładny model, obsługę języków, sposób prowadzenia dziennika, opcje medyczne i wymagania dotyczące danych dla planowanego wdrożenia; funkcje różnią się w zależności od modelu strumieniowania.
Trasa 4: Użyj Soniox do obsługi wielojęzycznych interfejsów API do strumieniowania
Soniox Łączy transkrypcję i tłumaczenie w czasie rzeczywistym za pośrednictwem interfejsu API WebSocket. Obecny interfejs obsługuje podpowiedzi językowe, dostosowywanie kontekstu, tworzenie dzienników mówców, konfigurację tłumaczeń, znaczniki czasu na poziomie tokenów, pewność, ostateczność i informacje o języku.
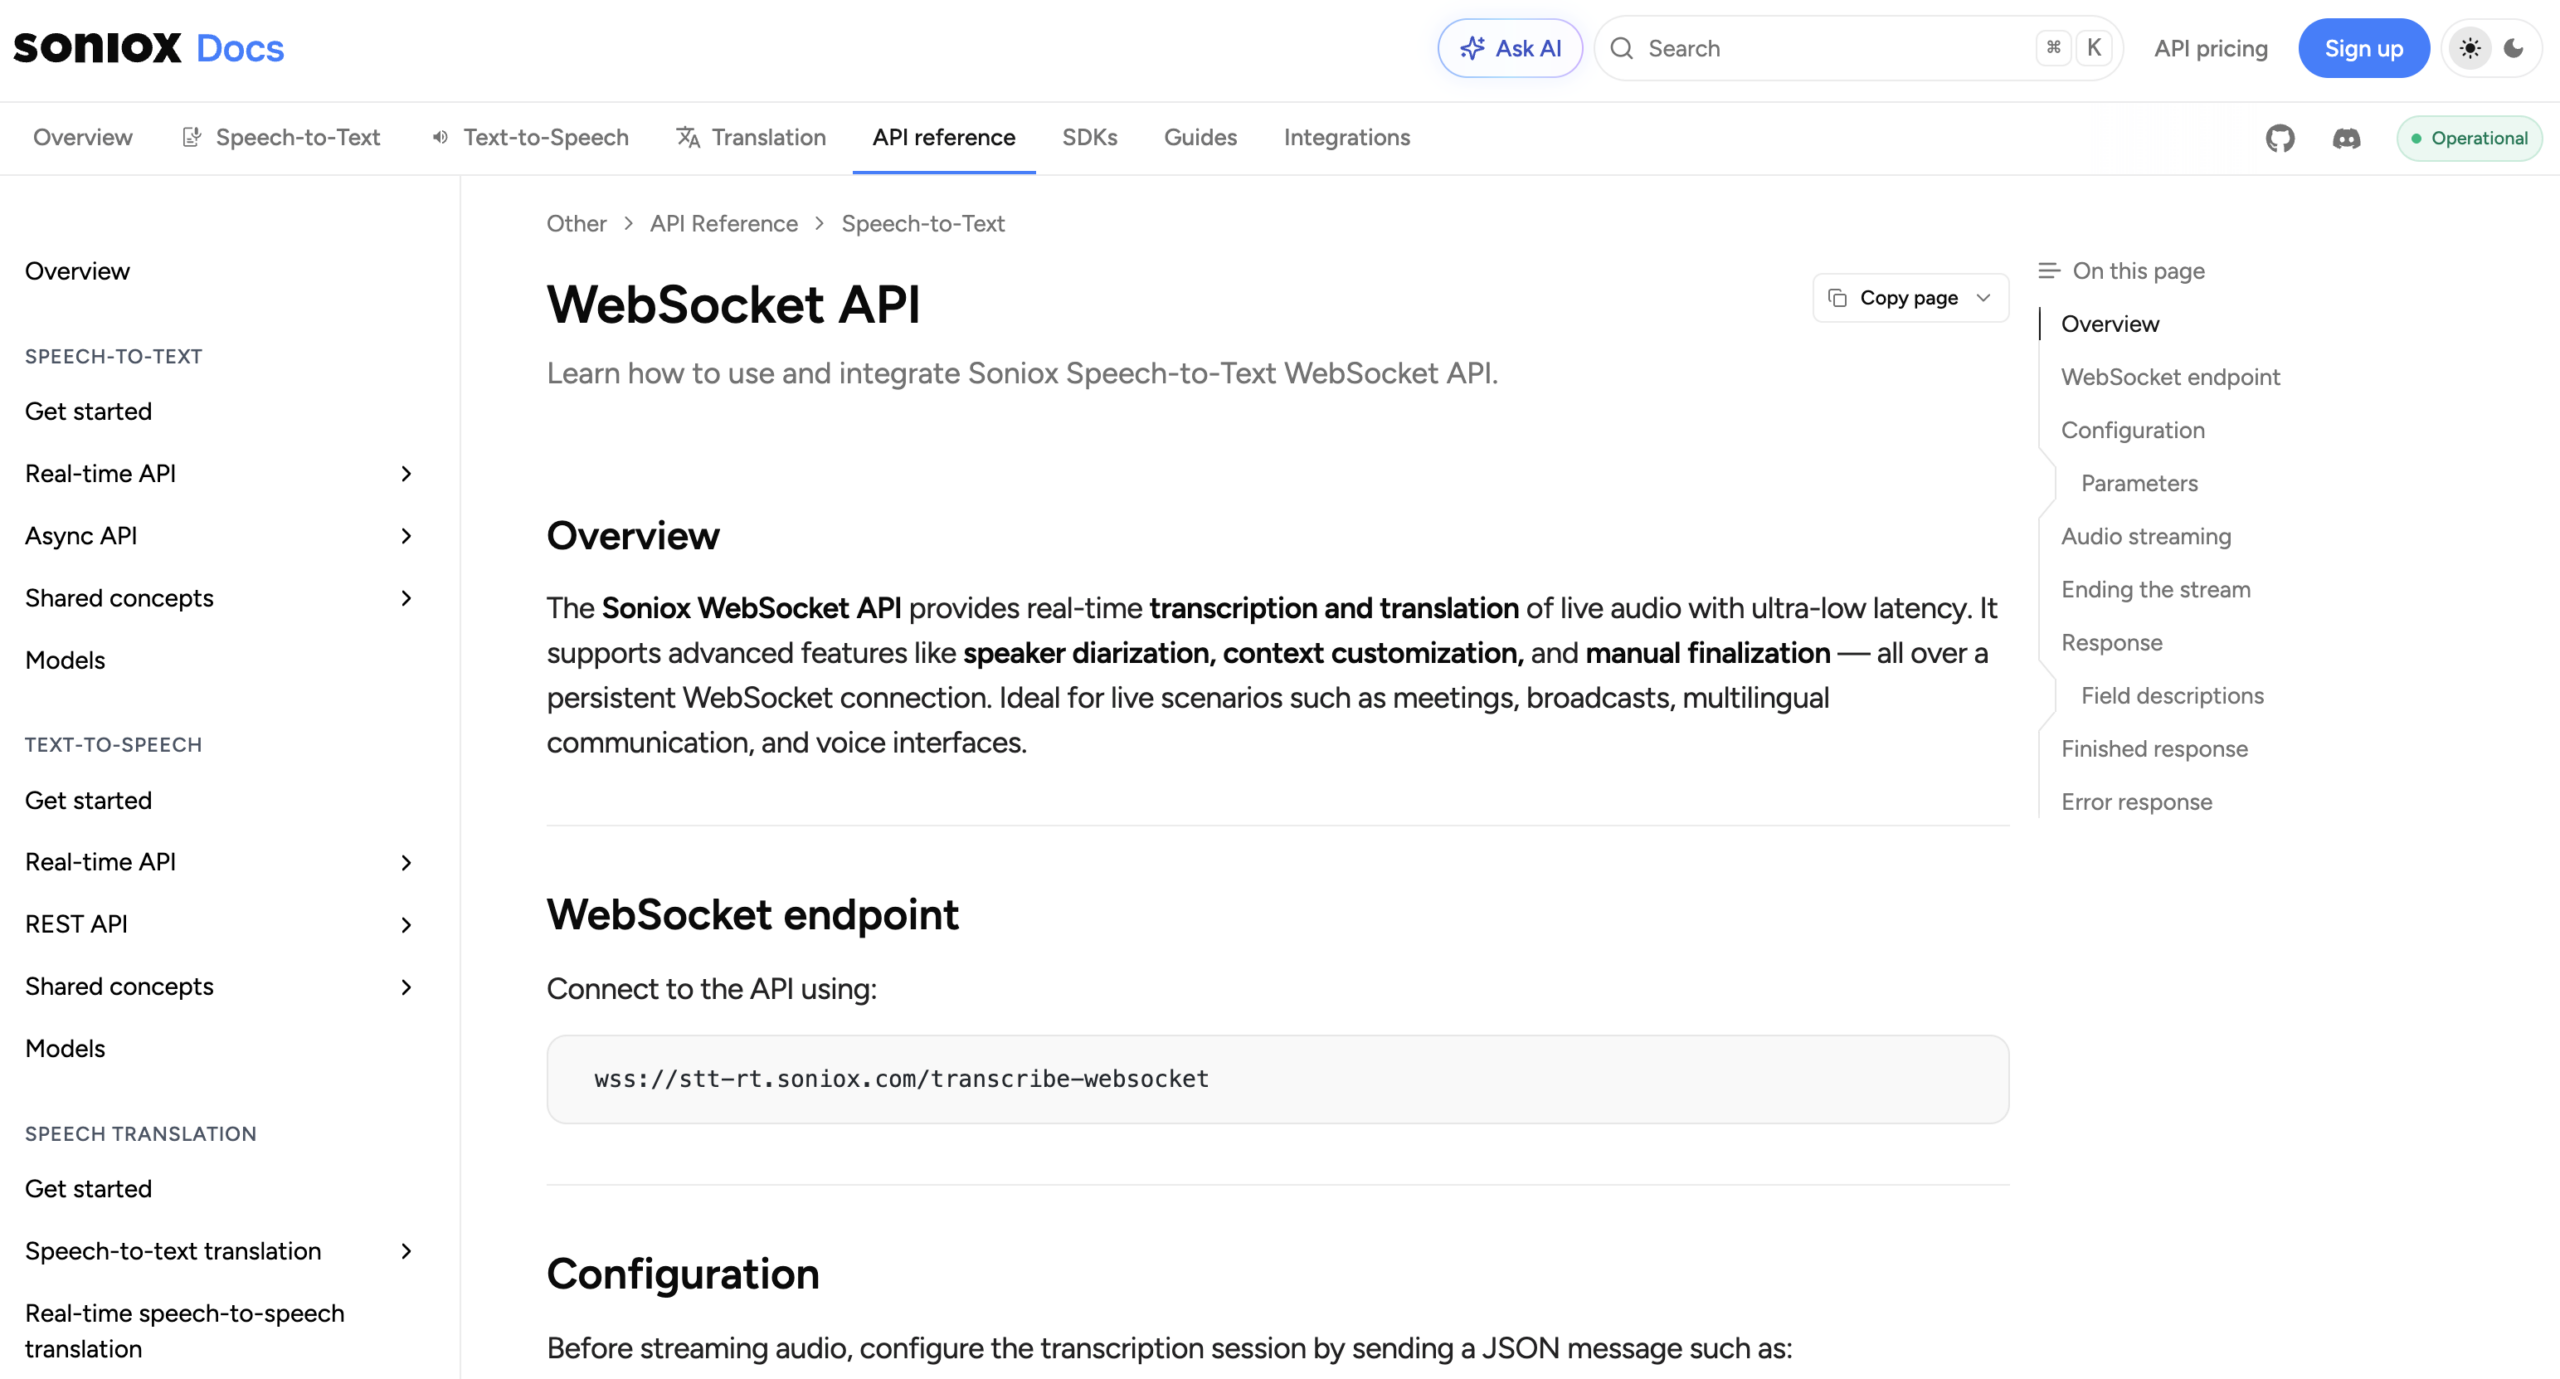
To sprawia, że Soniox istotne, gdy chcą tego programiści zamiana mowy na tekst w czasie rzeczywistym i wielojęzyczne wyjście w ramach własnej aplikacji. Konfiguracja kontekstu może pomóc w terminologii domenowej, ale należy ją testować za pomocą skryptu terminologii stałej, a nie zakładać na podstawie nazwy funkcji.
Podobnie jak w przypadku innych interfejsów API, usługa zwraca bloki konstrukcyjne. Kupujący nadal musi utworzyć dostęp dla uczestników, poprawki, przechowywanie, eksporty, podsumowania, kontrolę administracyjną, monitorowanie, odzyskiwanie błędów i wsparcie.
Dlaczego wskaźnik błędów w słowach nie jest wystarczający
Współczynnik błędów w słowach mierzy podstawienia, usunięcia i wstawienia w odniesieniu do transkryptu referencyjnego. Jest to przydatne, ale pojedyncza średnia może ukryć najważniejsze błędy.
Porównaj te dwa błędy:
- “Możemy wysłać dalej Czwartek”staje się “Możemy wysłać dalej” Wtorek.”
- “Proszę otworzyć panel ustawień” staje się “Proszę otworzyć” panel ustawień.”
Oba mogą się liczyć podobnie, ale pierwszy zmienia zobowiązanie. Zbuduj rejestr błędów dla:
- Nazwy i tożsamość mówcy.
- Liczby, waluty, daty i jednostki.
- Negacje i warunki.
- Nazwy produktów i terminologia specjalistyczna.
- Przełączanie kodów i zmiany języka.
- Przerwy i autokorekty.
- Interpunkcja zmieniająca znaczenie.
Następnie należy uwzględnić czas. Prawidłowe słowo wypowiedziane po podjęciu decyzji może być błędem operacyjnym. Tymczasowy błąd poprawiony później mógł nadal skłonić konsultanta głosowego lub uczestnika do podjęcia działania.
Prawo zamiana mowy na tekst w czasie rzeczywistym Wynik uwzględnia zatem wagę błędów rzeczowych, stabilność, czas trwania i sposób przekazu — nie tylko przeciętną dokładność słownictwa.
Dwuminutowa taśma prawdy
Użyj jednego źródła nagrań, aby każdy kandydat miał identyczny dźwięk. Nie pozwól, aby każdy dostawca wybrał własną wersję demonstracyjną.
Scenariusz
- “Dzień dobry, nazywam się Niamh O'Rourke i pracuję w Aster-Q.”
- “Mowa tu o BX-417, nie o BX-471.”
- “Przychody wyniosły 15,05 mln TP5T, co stanowi wzrost o 13,6 procent.”
- “Nie odnawiaj, dopóki nie podpiszesz umowy o poziomie usług”.”
- “Wysłać piętnaście — przepraszam, pięćdziesiąt — jednostek w czwartek”.”
- “Interfejs API wykorzystuje przesyłanie strumieniowe WebSocket i punkt końcowy o czasie reakcji 300 milisekund”.”
- Zatrzymaj się na 700 milisekund w środku zdania warunkowego.
- Pozwól drugiej osobie przerwać wypowiedź, a następnie wróć do pierwszej osoby.
- Dodaj jedno zdanie w wymaganym drugim języku.
- Zakończ cichym zdaniem, gdy słychać dźwięk klawiatury.
Arkusz przechwytywania
| Pomiar | Jak to nagrać | Zdefiniuj warunek przejścia przed testowaniem |
|---|---|---|
| Czas na pierwszą wiadomość tekstową | Początek audio do pierwszej niepustej hipotezy | Na podstawie potrzeby użytkownika w zakresie wizualnego sprzężenia zwrotnego |
| Czas na stabilny tekst | Ostatnie wypowiedziane słowo do ostatecznego, niezmiennego tekstu | Wystarczająco szybko, aby ludzie nie reagowali na zmiany |
| Opóźnienie finalizacji tury | Koniec zamierzonego zwrotu do punktu końcowego zdarzenia lub wyzwalacza reakcji | Nie przerywa normalnych przerw i nie powoduje braku reakcji |
| Liczba rewizji | Liczba widocznych zmian hipotez na poziomie API | Interfejs pozostaje czytelny, a dalsze działania oczekują na ostateczność |
| Krytyczne błędy faktyczne | Nazwy, liczby, negacje, daty, jednostki i warunki | Zero nieoznaczonych błędów o wysokim stopniu ważności w programie pilotażowym |
| Odzyskiwanie etykiet głośników | Czas i poprawność po przerwaniu | Zapisany transkrypt odzwierciedla poprawioną atrybucję |
| Zakończenie przepływu pracy | Zakończenie spotkania w rekordzie, który można przeszukiwać/eksportować, lub działanie aplikacji | Pasuje do terminu operacyjnego |
Przeprowadź dziesięć prób, a następnie podaj medianę, 95. percentyl i najgorsze zaobserwowane wyniki, o ile pozwala na to próba. Jeden idealny przebieg nie gwarantuje wiarygodności.
Siedem trybów awarii i pierwsza naprawa
| Objaw | Prawdopodobna warstwa | Pierwsza przydatna kontrola |
|---|---|---|
| Tekst pojawia się z opóźnieniem od pierwszego słowa | Przechwytywanie, buforowanie, kodowanie, sieć lub model | Zmierz każdy przeskok i zredukuj zbyt duże fragmenty audio |
| Tekst pojawia się szybko, ale jest mocno przepisany | Zachowanie hipotezy tymczasowej | Poczekaj na ostateczność przed uruchomieniem akcji; przeprojektuj tymczasowy wyświetlacz |
| System odcina przemyślanych mówców | Wykrywanie progu punktu końcowego lub aktywności głosowej | Przetestuj dłuższe przerwy i dostosuj wyznaczanie punktów końcowych, jeśli jest to możliwe |
| System czeka zbyt długo po krótkich poleceniach | Próg punktu końcowego lub logika obrotu aplikacji | Test krótszego progu lub wyraźnych elementów sterujących końcem skrętu |
| Nazwy i kody ciągle zawodzą | Niejednoznaczność akustyczna i brakujący kontekst domeny | Dodaj kluczowe terminy/kontekst i popraw jakość mikrofonu |
| Etykiety głośników zmieniają się po wyświetleniu | Transmisja strumieniowa zmienia klastry | Obsługa oczekujących etykiet i stosowanie zdarzeń rewizji do rekordu |
| Transkrypcja jest szybka, ale później nieużyteczna | Brak przepływu pracy produktu | Dodaj korektę, przechowywanie, wyszukiwanie, uprawnienia, eksportowanie i usuwanie — lub wybierz gotową aplikację |
Rozwiązywanie problemów zamiana mowy na tekst w czasie rzeczywistym Od lewej do prawej. Zastąpienie modelu nie naprawi wyciszonego sygnału wejściowego, nieprawidłowej częstotliwości próbkowania ani interfejsu użytkownika, który zapisuje tekst tymczasowy jako ostateczny.
Kiedy zamiana mowy na tekst nie jest ostatecznym zadaniem
Transkrypcja odpowiada na pytanie: “Jakie słowa zostały rozpoznane?”. Tłumaczenie odpowiada na pytanie: “Co te słowa oznaczają w innym języku?”. Produkt spotkania musi również odpowiedzieć na pytanie: “Czy druga osoba jest w stanie zrozumieć, odpowiedzieć i później podjąć decyzję?”.”
Jeśli wszyscy mówią tym samym językiem i potrzebują napisów, dyktowania, wyszukiwania lub analiz ułatwiających dostęp, dedykowane API STT lub produkt do transkrypcji może być wystarczające. Jeśli uczestnicy używają różnych języków, przepływ pracy wymaga dodatkowych kontroli:
- Tekst źródłowy widoczny obok tłumaczenia.
- Wybór języka lub obsługa automatyczna.
- Przygotowanie terminologii i kontekstu.
- Tekst w języku docelowym przekazywany w trakcie rozmowy.
- Opcjonalny głos tłumaczony podczas czytania jest niepraktyczny.
- Zapisy i notatki utrwalające dyskusję wielojęzyczną.
To jest punkt, w którym zamiana mowy na tekst w czasie rzeczywistym staje się jednym ze składników większej Transync AI przepływu pracy, a nie produktu końcowego.
Najczęściej zadawane pytania dotyczące zamiany mowy na tekst w czasie rzeczywistym
Czym jest przetwarzanie mowy na tekst w czasie rzeczywistym?
Mowa w czasie rzeczywistym na tekst Konwertuje przesyłany strumieniowo dźwięk na tekst tymczasowy i sfinalizowany w trakcie mówienia. System może korygować wstępne hipotezy w miarę otrzymywania szerszego kontekstu, wykrywania końca tury, stosowania znaków interpunkcyjnych lub poprawiania atrybucji mówcy.
Jakie opóźnienie uznaje się za czas rzeczywisty?
Nie ma jednego progu. Zmierz czas do pierwszego tekstu, stabilny tekst, ostateczność tury i użyteczny wynik przepływu pracy. Czytnik napisów, agent głosowy, uczestnik spotkania i recenzent po rozmowie mają różne dopuszczalne opóźnienia.
Dlaczego tekst na żywo ciągle się zmienia?
Rozpoznawacze strumieniowe publikują częściowe hipotezy przed ukończeniem zdania. Późniejszy dźwięk może zmienić najbardziej prawdopodobne sformułowanie, interpunkcję, język lub osobę mówiącą. Aplikacje powinny odróżniać wyniki tymczasowe od tekstu finalnego.
Czy przetwarzanie mowy na tekst w czasie rzeczywistym to to samo, co tłumaczenie na żywo?
Nie. Funkcja zamiany mowy na tekst rozpoznaje słowa mówione w języku źródłowym. Tłumaczenie na żywo dodaje kolejną transformację językową i może również dodać przetłumaczony głos. Transync AI łączy rozpoznawanie i tłumaczenie w celu prowadzenia rozmów wielojęzycznych.
Który interfejs API jest najlepszy do przetwarzania mowy na tekst w czasie rzeczywistym?
Nie ma uniwersalnego zwycięzcy. Deepgram oferuje szczegółową kontrolę punktów końcowych i stanu wyników, AssemblyAI oferuje obsługę strumieniowego dziennikowania i zachowań rewizji, a także Soniox Łączy wielojęzyczne opcje transkrypcji i tłumaczenia. Przetestuj każdą z nich z identycznym dźwiękiem i dokładnymi wymaganiami produktu.
Czy technologia przetwarzania mowy na tekst w czasie rzeczywistym może identyfikować mówców?
Niektóre modele obsługują diaryzację lub wejście wielokanałowe, ale etykiety mogą być tymczasowe i mogą się zmieniać wraz z napływem kolejnych sygnałów audio. Przerwy w testach, podobne głosy, zmiany w urządzeniu i korekty zapisanych etykiet.
Co firma powinna przetestować w pierwszej kolejności?
Zacznij od faktycznej ścieżki audio i dwuminutowego skryptu zawierającego nazwy, liczby, negacje, poprawki, pauzy, przerwy, terminologię i wymagane języki. Zmierz wszystkie cztery zegary i sprawdź zapisany zapis.
Ostateczny werdykt
Najszybszy zamiana mowy na tekst w czasie rzeczywistym System niekoniecznie musi być tym, który pokazuje pierwsze słowo najwcześniej. Niezawodny system równoważy cztery zegary:
pierwszy tekst → tekst stabilny → ukończony obrót → użyteczny rekord
Wybierz API strumieniowe, gdy programiści potrzebują kontrolować punkty końcowe, częściowe wyniki, poprawki prelegentów i działanie aplikacji. Wybierz gotowy produkt do obsługi spotkań, gdy zespół potrzebuje pełnej ścieżki od dźwięku do napisów, tłumaczeń, nagrań i notatek bez konieczności budowania infrastruktury.
Co najważniejsze, przetestuj rzeczywisty wkład i rzeczywisty skutek. Zmierz słowo, które się pojawia, słowo, które się zmienia, obrót, który się kończy, i zapis, któremu ktoś później zaufa.