रियल टाइम स्पीच टू टेक्स्ट सिर्फ़ तेज़ कैप्शन से कहीं ज़्यादा है। चुनने से पहले 4 छिपी हुई घड़ियों, संशोधनों, स्पीकर हैंडलिंग और बहुभाषी मीटिंग के अनुकूलता जैसी विशेषताओं का आकलन करें।.
डेमो में रियल टाइम स्पीच-टू-टेक्स्ट देखने में तो शानदार लग सकता है, लेकिन बातचीत में विफल हो सकता है। पहले शब्द 300 मिलीसेकंड में दिखाई दे सकते हैं, लेकिन वाक्य दो सेकंड तक बदलता रह सकता है। स्पीकर का नाम आ सकता है, फिर उसे संशोधित किया जा सकता है। एक सुव्यवस्थित ट्रांसक्रिप्ट जल्दी तैयार हो सकती है, लेकिन उसमें वह नकारात्मक शब्द छूट सकता है जिसके कारण निर्णय बदला गया।.
इसीलिए "यह कितना तेज़ है?" पहला सवाल पूछना गलत है। एक उपयोगी मूल्यांकन के लिए चार समयों की आवश्यकता होती है: पहले टेक्स्ट तक का समय, स्थिर टेक्स्ट तक का समय, एक पूरा टर्न लेने तक का समय और एक उपयोगी रिकॉर्ड तक का समय। प्रत्येक समय एक अलग परिचालन आवश्यकता को पूरा करता है।.
यह लेख निम्नलिखित विषयों पर चर्चा करता है। वास्तविक समय में भाषण को पाठ में परिवर्तित करना इसे दृश्य प्रभाव के बजाय एक मापने योग्य प्रक्रिया के रूप में प्रस्तुत किया गया है। यह विशेषज्ञ स्ट्रीमिंग एपीआई की तुलना एक तैयार बहुभाषी मीटिंग उत्पाद से करता है, एक दोहराने योग्य परीक्षण स्क्रिप्ट प्रदान करता है, और यह बताता है कि कब केवल प्रतिलेखन अपर्याप्त है क्योंकि प्रतिभागियों को अनुवाद, ध्वनि आउटपुट या नोट्स की आवश्यकता होती है।.
60 सेकंड का उत्तर
वास्तविक समय में भाषण को पाठ में परिवर्तित करना यह मॉडल वक्ता के बोलते समय ही लाइव ऑडियो स्ट्रीम को टेक्स्ट में परिवर्तित करता है। प्रदर्शित टेक्स्ट अक्सर अस्थायी होता है। शुरुआती शब्दों को तब संशोधित किया जा सकता है जब मॉडल को अधिक संदर्भ प्राप्त होता है, विराम का पता चलता है, वक्ता की पहचान होती है, विराम चिह्न लगाए जाते हैं या वाक्य पूरा होता है।.
ये चार घड़ियाँ इस प्रकार हैं:
- प्रथम-पाठ विलंबता: कोई परिकल्पना कब तक सामने आएगी?
- स्थिरता विलंबता: शब्दों का बदलना कब तक बंद हो जाएगा?
- टर्न-फ़ाइनैलिटी लेटेंसी: किसी व्यक्ति के बोलने की बारी या कथन समाप्त होने का निर्णय लेने में सिस्टम को कितना समय लगता है?
- वर्कफ़्लो विलंबता: ट्रांसक्रिप्ट को खोज, नोट्स, कार्यों, अनुवाद या आवेदन प्रतिक्रिया के लिए उपयोग करने योग्य होने में कितना समय लगेगा?
वॉइस एजेंट को बारी समाप्त होने को प्राथमिकता देनी पड़ सकती है क्योंकि उसे यह तय करना होता है कि कब जवाब देना है। एक्सेसिबिलिटी कैप्शन तेज़, पठनीय आंशिक पाठ को प्राथमिकता दे सकते हैं। यदि नाम, संख्याएँ और वक्ता का विवरण अधिक विश्वसनीय हो जाता है, तो मीटिंग रिकॉर्ड में थोड़ी धीमी गति से प्रदर्शन स्वीकार्य हो सकता है। बहुभाषी मीटिंग में पहचान के बाद एक और चरण जुड़ जाता है: अनुवाद इतनी जल्दी उपलब्ध होना चाहिए कि कोई जवाब दे सके।.
रियल टाइम स्पीच टू टेक्स्ट एक गतिशील परिकल्पना है
लाइव ट्रांसक्रिप्ट एक ही चरण में तैयार नहीं होती है:
माइक्रोफ़ोन या सिस्टम ऑडियो → एन्कोडिंग और परिवहन → वाक् पहचान → अस्थायी पहचान → संशोधन → अंतिम रूप देना → स्पीकर लेबलिंग और फ़ॉर्मेटिंग → अनुप्रयोग क्रिया
स्क्रीन पर आमतौर पर केवल मध्य भाग ही दिखाई देता है। इससे एक आम भ्रम पैदा होता है: क्योंकि टेक्स्ट तुरंत दिखाई देता है, उपयोगकर्ता मान लेते हैं कि परिणाम पूरा हो गया है। वास्तव में, इंजन अभी भी शब्द सीमाओं, विराम चिह्नों, भाषा या वक्ता की पहचान पर पुनर्विचार कर रहा हो सकता है।.
विशेषज्ञ एपीआई इस अंतर को स्पष्ट करते हैं।. दीपग्राम यह अंतरिम और अंतिम परिणाम अलग-अलग लौटाता है। इसके दस्तावेज़ में बताया गया है कि प्रारंभिक पाठ में बदलाव हो सकता है, जबकि पूर्ण वाक्य को पुनर्निर्मित करने के लिए अंतिम खंडों को जोड़ा जाना चाहिए। एक अलग स्पीच-फ़ाइनल सिग्नल इंगित करता है कि सिस्टम ने विराम जैसे किसी समाप्ति बिंदु का पता लगा लिया है।.
सोनियॉक्स यह एक निरंतर स्ट्रीमिंग कनेक्शन पर अंतिम और गैर-अंतिम टोकन, टाइमस्टैम्प, विश्वास, भाषा की जानकारी, वैकल्पिक स्पीकर लेबल और प्रसंस्करण प्रगति को प्रदर्शित करता है।. AssemblyAI इसी प्रकार, समर्थित मॉडलों में आंशिक और अंतिम प्रतिलेख, एंडपॉइंटिंग, शब्द-स्तरीय टाइमस्टैम्प, प्रमुख-शब्द संकेत और स्ट्रीमिंग स्पीकर डायराइजेशन जैसी सुविधाएं उपलब्ध हैं।.
ये नियंत्रण डेवलपर्स के लिए उपयोगी हैं। साथ ही, ये यह भी बताते हैं कि अंतिम उपयोगकर्ता को निर्णय क्यों नहीं लेना चाहिए। वास्तविक समय में भाषण को पाठ में परिवर्तित करना केवल पहली दिखाई देने वाली रेखा से ही।.
घड़ी 1: पहले संदेश का समय
पहली घड़ी तब शुरू होती है जब सिस्टम तक भाषण पहुंचता है और तब रुकती है जब पहली गैर-रिक्त परिकल्पना एप्लिकेशन को दिखाई देती है या उपलब्ध हो जाती है।.
इस माप में मॉडल अनुमान से कहीं अधिक शामिल है:
- माइक्रोफोन या मीटिंग की ऑडियो रिकॉर्डिंग।.
- बफर आकार और ऑडियो चंकिंग।.
- रीसैंपलिंग या एन्कोडिंग।.
- नेटवर्क परिवहन।.
- सर्वर प्रोसेसिंग।.
- वापसी परिवहन।.
- इंटरफ़ेस रेंडरिंग।.
उपाय वास्तविक समय में भाषण को पाठ में परिवर्तित करना यह डेटा वास्तविक उपयोगकर्ता के डिवाइस से लिया गया है, न कि API डैशबोर्ड से। विक्रेता के सर्वर-साइड नंबर में ऑडियो बफरिंग, क्लाइंट नेटवर्किंग, ब्राउज़र रेंडरिंग और मीटिंग प्लेटफ़ॉर्म की अपनी देरी शामिल नहीं हो सकती है।.
जब उपयोगकर्ताओं को यह आश्वासन चाहिए होता है कि सिस्टम उनकी बात सुन रहा है, तो त्वरित प्रारंभिक पाठ उपयोगी होता है। यह तब कम उपयोगी होता है जब इंटरफ़ेस उन्हें अनिश्चित शब्दों पर कार्रवाई करने के लिए प्रोत्साहित करता है। एक अच्छा कैप्शन डिज़ाइन अस्थायी पाठ को अस्पष्ट बनाए बिना उसे स्पष्ट रूप से अलग करता है।.
पहली घड़ी का परीक्षण कैसे करें
ऑडियो और स्क्रीन को 60 फ्रेम प्रति सेकंड की दर से रिकॉर्ड करें। एक बार ताली बजाएं, फिर कहें: "नवीनीकरण स्वीकृत नहीं है।" उस फ्रेम को चिह्नित करें जहां वेवफॉर्म या ताली इनपुट तक पहुंचती है और उस फ्रेम को भी जहां पहला टेक्स्ट दिखाई देता है। इसे दस बार दोहराएं और औसत और सबसे धीमे परिणाम की रिपोर्ट करें, न कि सबसे अच्छे परिणाम की।.
परीक्षा वास्तविक समय में भाषण को पाठ में परिवर्तित करना सामान्य वाई-फाई, भीड़भाड़ वाले नेटवर्क, शोर कम करने वाले लैपटॉप और हेडसेट या कमरे के माइक्रोफोन जैसी स्थितियों में, सामान्य लोड के तहत टेक्स्ट की शुरुआती गति का कम हो जाना एक भरोसेमंद उत्पाद विशेषता नहीं है।.
घड़ी 2: स्थिर पाठ तक का समय
दूसरी घड़ी तब रुक जाती है जब टेक्स्ट का एक हिस्सा बदलना बंद हो जाता है। मार्केटिंग के अधिकांश प्रदर्शनों में यही घड़ी छिपी रहती है।.
बोले गए वाक्यांश पर विचार करें:
“"गुरुवार को पंद्रह—माफ़ कीजिए, पचास—यूनिट भेजिए।"”
डिस्प्ले में पहले “शिप 15”, फिर “शिप 50”, और फिर विराम चिह्नों के साथ एक सुधार दिखाई दे सकता है। पहला संस्करण जल्दी आ गया, लेकिन केवल अंतिम संस्करण ही ऑर्डर में कॉपी करने के लिए सुरक्षित है।.
स्थिरता महत्वपूर्ण है क्योंकि डाउनस्ट्रीम सिस्टम बहुत जल्दी प्रतिक्रिया कर सकते हैं। लाइव सारांश, बिक्री सहायक, अनुपालन ट्रिगर, अनुवाद परत या वॉयस एजेंट अस्थायी त्रुटि को विरासत में ले सकते हैं। वास्तविक समय में भाषण को पाठ में परिवर्तित करना वर्कफ़्लो में, डेवलपर्स को प्रत्येक आंशिक अपडेट को पूर्ण कथन के रूप में मानने के बजाय इंजन के अंतिम संकेतों को संसाधित करना चाहिए।.
संशोधन की दूरी मापें, केवल विलंब नहीं।
प्रत्येक परीक्षण वाक्य के लिए, लॉग करें:
- अस्थायी संस्करणों की संख्या।.
- बदले या हटाए गए शब्दों की संख्या।.
- अंतिम बोले गए शब्द और स्थिर पाठ के बीच का समय।.
- क्या अंतिम संग्रहित प्रतिलेख स्थिर प्रदर्शन से मेल खाता है?.
- क्या स्थिरता आने से पहले कोई अनुगामी कार्रवाई शुरू हुई थी?.
थोड़ा धीमा वास्तविक समय में भाषण को पाठ में परिवर्तित करना यदि सिस्टम में बार-बार बदलाव न किए जाएं तो वह अधिक सुरक्षित हो सकता है। सही संतुलन इस बात पर निर्भर करता है कि उपयोगकर्ता सॉफ्टवेयर पढ़ रहे हैं, निर्देश दे रहे हैं, नियंत्रित कर रहे हैं या कोई बातचीत कर रहे हैं।.
क्लॉक 3: एक चक्कर पूरा करने में लगने वाला समय
शब्द अंतिम हो सकते हैं, लेकिन बोलने की बारी नहीं। कोई व्यक्ति सोचने, सांस लेने, किसी आकृति को याद करने या किसी रुकावट के दौरान प्रतीक्षा करने के लिए रुक सकता है। यदि सिस्टम बोलने की बारी समय से पहले समाप्त घोषित कर देता है, तो एक वॉइस एजेंट उपयोगकर्ता के ऊपर बोलना शुरू कर सकता है। यदि यह बहुत देर तक प्रतीक्षा करता है, तो बातचीत अनुत्तरदायी प्रतीत होती है।.
एंडपॉइंटिंग आमतौर पर मौन या ध्वनि गतिविधि का उपयोग यह अनुमान लगाने के लिए करती है कि भाषण समाप्त हो गया है।. दीपग्राम दस्तावेज़ विन्यास योग्य एंडपॉइंटिंग और अलग है_अंतिम और भाषण_अंतिम राज्यों के दिशानिर्देशों में कहा गया है कि छोटी समयसीमा संक्षिप्त चैटबॉट उत्तरों के लिए उपयुक्त हो सकती है, जबकि लंबी वार्तालाप विराम के लिए किसी बात को पूरा माना जाने से पहले सैकड़ों मिलीसेकंड का समय लग सकता है।.
कोई भी सार्वभौमिक तरीका हर वक्ता के लिए उपयुक्त नहीं होता। एक तेज़ कॉल-सेंटर स्क्रिप्ट, एक हिचकिचाती हुई मेडिकल हिस्ट्री, एक क्लासरूम लेक्चर और एक द्विभाषी बातचीत में विराम के अलग-अलग पैटर्न होते हैं। इसलिए, बातचीत का समापन एक महत्वपूर्ण पहलू है। वास्तविक समय में भाषण को पाठ में परिवर्तित करना माप, न कि केवल एक एपीआई सेटिंग।.
संकोच परीक्षण चलाएँ
इन चार पंक्तियों का उपयोग करें:
- “मेरा खाता नंबर … 4172 है।”
- “मैं सहमत हूँ… बशर्ते डिलीवरी की तारीख शुक्रवार ही रहे।”
- “"इसकी खुराक पंद्रह—नहीं, पचास—मिलीग्राम है।"”
- “एना, क्या तुम—” तभी दूसरे वक्ता ने बीच में ही टोक दिया।.
गलत अंत, विलंबित समापन बिंदु, रुकावटें और कटे हुए शब्दों की गणना करें। फिर, यदि एप्लिकेशन इसे प्रदर्शित करता है, तो ही समापन बिंदु सीमा को समायोजित करें। यदि उत्पाद एक पूर्ण ऐप है, तो उसके व्यवहार का अवलोकन करें और तय करें कि क्या यह कार्य के लिए उपयुक्त है।.
यह घड़ी वह जगह है जहाँ वास्तविक समय में भाषण को पाठ में परिवर्तित करना यह साधारण प्रतिलेखन के बजाय वार्तालाप इंजीनियरिंग बन जाता है।.
घड़ी 4: उपयोगी रिकॉर्ड प्राप्त करने का समय
टीमों के लिए चौथा चरण सबसे महत्वपूर्ण होता है। यह तब समाप्त होता है जब आउटपुट अगली कार्रवाई का समर्थन करने में सक्षम हो जाता है।.
“उपयोगी” का अर्थ निम्नलिखित हो सकता है:
- सेशन के दौरान कैप्शन पठनीय बने रहते हैं।.
- वक्ताओं की पहचान की जा सकती है।.
- नाम, संख्याएँ और शब्दावली में सुधार किया जा सकता है।.
- संपूर्ण प्रतिलेख की प्रतिलिपि बनाई जा सकती है या उसे निर्यात किया जा सकता है।.
- यह रिकॉर्ड खोज योग्य है और इसके लिए अनुमति प्राप्त है।.
- सारांश और कार्रवाई योग्य मद तैयार किए जाते हैं।.
- मूल पाठ और अनुवादित पाठ एक साथ ही रहते हैं।.
- प्रतिधारण और विलोपन की प्रक्रिया समझी जा चुकी है।.
एक सिस्टम पहले तीन क्लॉक जीत सकता है और चौथा हार सकता है। रॉ स्ट्रीमिंग JSON मीटिंग का रिकॉर्ड नहीं है। तेज़ी से गायब होने वाले कैप्शन सबूत नहीं होते। ट्रेस करने योग्य ट्रांसक्रिप्ट के बिना एक सुंदर सारांश पहचान की त्रुटियों को छिपा सकता है। इसीलिए वास्तविक समय में भाषण को पाठ में परिवर्तित करना खरीद प्रक्रिया में स्ट्रीमिंग मॉडल के साथ-साथ तैयार वर्कफ़्लो का भी मापन किया जाना चाहिए।.
वास्तविक समय में भाषण को पाठ में परिवर्तित करना इसलिए, इसका मूल्यांकन उपयोग के समय किया जाना चाहिए, न कि निर्माण के समय। प्रतिभागी, समीक्षक, डेवलपर और प्रशासक से कहें कि वे अपने-अपने दृष्टिकोण से उसी सत्र का परीक्षण करें।.
चार घड़ियों द्वारा तुलना किए गए चार मार्ग
| उत्पाद | उत्पाद का प्रकार | पहला पाठ | स्थिरता और अंतिम नियंत्रण | स्पीकर हैंडलिंग | बहुभाषी भूमिका | उपयोग योग्य रिकॉर्ड वर्कफ़्लो | सबसे अच्छा फिट |
|---|---|---|---|---|---|---|---|
| Transync AI | मीटिंग अनुवाद ऐप (उपयोग के लिए तैयार) | लाइव द्विभाषी प्रदर्शन | उत्पाद द्वारा प्रबंधित, न कि एपीआई पैरामीटर के रूप में प्रदर्शित। | चयनित भाषा जोड़ी को स्वचालित रूप से पहचानता है; मूल और अनुवादित पाठ में समीक्षा करें | 60 भाषाएँ, द्विभाषी उपशीर्षक, अनुवादित आवाज | अनुवाद रिकॉर्ड, प्रतिलेख और एआई मीटिंग का सारांश | ऐसे व्यक्ति और टीमें जिन्हें ऐप बनाए बिना लाइव क्रॉस-लैंग्वेज कम्युनिकेशन की आवश्यकता है |
| दीपग्राम | स्ट्रीमिंग स्पीच-टू-टेक्स्ट एपीआई | अंतरिम परिणाम सक्षम किए जा सकते हैं | अंतरिम/अंतिम परिणाम, एंडपॉइंटिंग, भाषण-अंतिम घटनाएँ, उच्चारण-समाप्ति नियंत्रण और मैन्युअल अंतिमकरण प्रदर्शित करता है। | डायराइजेशन और मल्टीचैनल विकल्प कॉन्फ़िगरेशन/मॉडल पर निर्भर करते हैं। | स्ट्रीमिंग भाषा और मॉडल विकल्प; अनुवाद एक अलग वर्कफ़्लो निर्णय है। | ग्राहक को संग्रहण, संपादन, अनुमतियाँ, सारांश और उपयोगकर्ता इंटरफ़ेस (UI) बनाना होगा। | वॉइस एजेंट, कैप्शन, कॉल इंटेलिजेंस या कस्टम ट्रांसक्रिप्शन उत्पाद बनाने वाले डेवलपर्स |
| AssemblyAI | स्ट्रीमिंग स्पीच-टू-टेक्स्ट एपीआई | स्ट्रीमिंग कनेक्शन के माध्यम से आंशिक प्रतिलेख वापस भेजे गए। | बुद्धिमान एंडपॉइंटिंग और अपरिवर्तनीय अंतिम प्रतिलेख; मॉडल-विशिष्ट व्यवहार लागू होता है | समर्थित मॉडलों में स्ट्रीमिंग डायराइजेशन और स्पीकर-रिवीजन इवेंट उपलब्ध हैं। | बहुभाषी स्ट्रीमिंग मॉडल प्रकाशित भाषा सेट का समर्थन करता है। | ग्राहक तैयार एप्लिकेशन और रिकॉर्ड जीवनचक्र का निर्माण करता है। | उत्पाद टीमों को डायराइजेशन और डाउनस्ट्रीम इंटेलिजेंस के साथ स्ट्रीमिंग पहचान की आवश्यकता होती है। |
| सोनियॉक्स | रीयल-टाइम स्पीच एआई एपीआई | कम विलंबता के साथ गैर-अंतिम टोकन स्ट्रीम करें | अंतिम-टोकन फ़्लैग, मैन्युअल अंतिमकरण, टोकन टाइमस्टैम्प और प्रोसेसिंग प्रगति | वैकल्पिक स्पीकर डायराइजेशन | एपीआई कॉन्फ़िगरेशन के माध्यम से वास्तविक समय में बहुभाषी प्रतिलेखन और अनुवाद | ग्राहक इंटरफ़ेस, निरंतरता, समीक्षा और शासन का निर्माण करता है। | बहुभाषी मीटिंग, प्रसारण, सहायक या वॉइस इंटरफेस बनाने वाले डेवलपर |
3 अक्टूबर, 2026 को आधिकारिक उत्पाद दस्तावेज़ के आधार पर क्षमताओं की जाँच की गई। मॉडल, भाषाएँ, सीमाएँ और मूल्य निर्धारण में परिवर्तन हो सकते हैं।.
यह तालिका किसी एक सर्वमान्य विजेता को स्थान नहीं देती। यह दो खरीद निर्णयों को अलग करती है: स्ट्रीमिंग एपीआई के आसपास एक उत्पाद बनाना, या एक तैयार वर्कफ़्लो का उपयोग करना। वास्तविक समय में भाषण को पाठ में परिवर्तित करना यह प्रक्रिया इस बात पर निर्भर करती है कि ऑडियो कैप्चर, इंटरफेस डिजाइन, सुधार, स्टोरेज और सपोर्ट का स्वामित्व किसके पास है।.
विकल्प 1: जब वाक् संचार को कई भाषाओं में करना आवश्यक हो, तो Transync एआई का उपयोग करें।
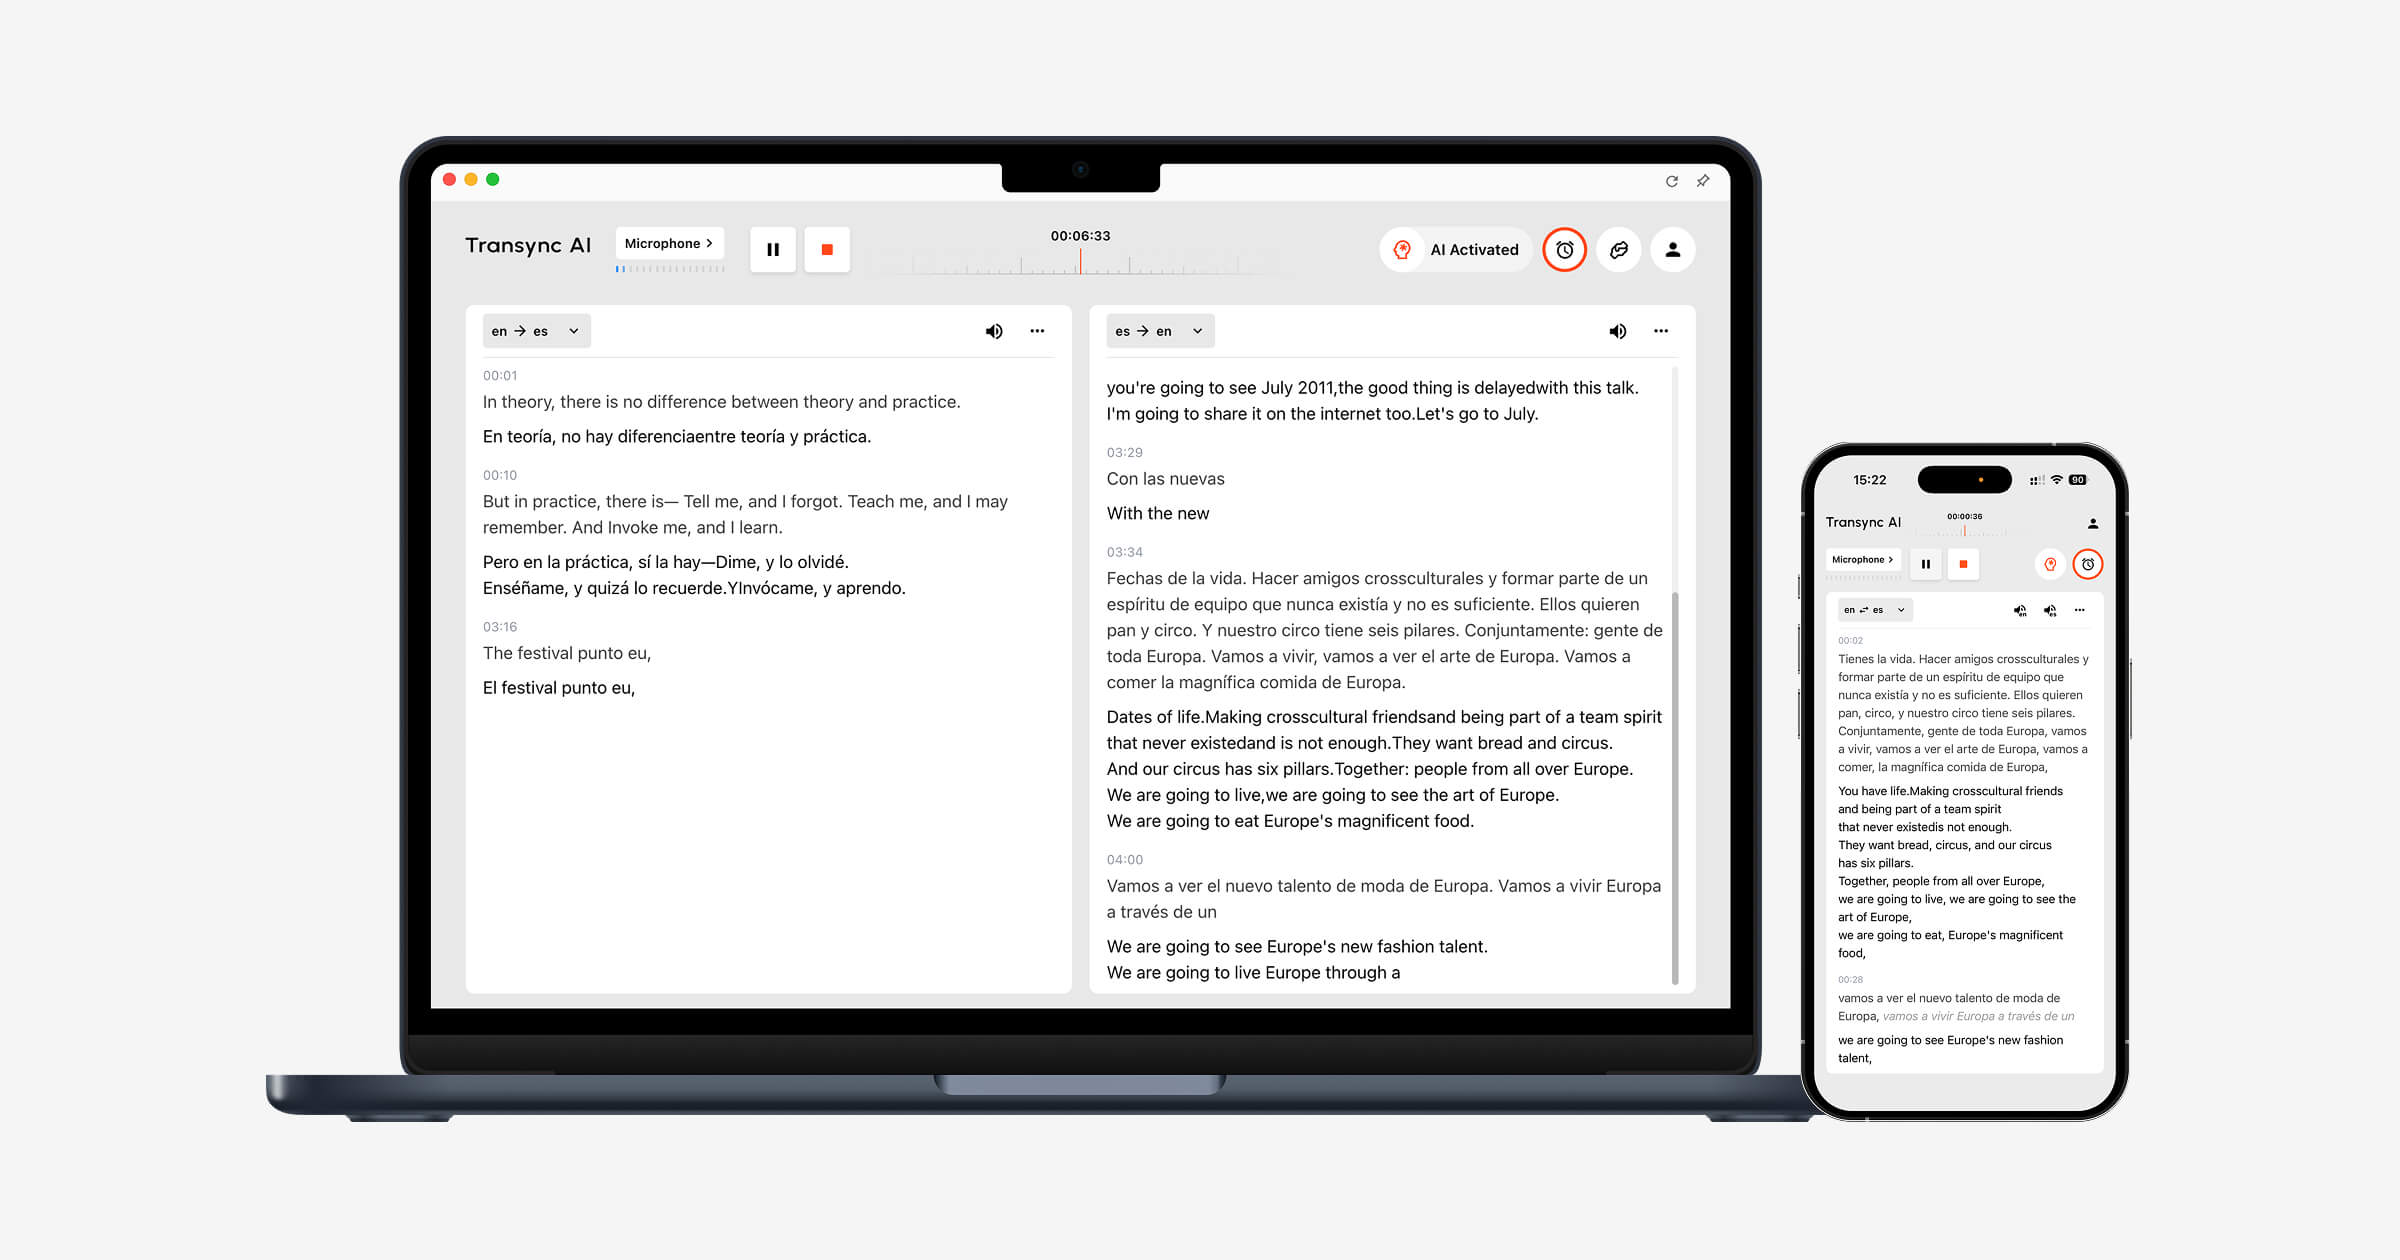
Transync AI इसे सामान्य प्रयोजन वाले स्पीच-टू-टेक्स्ट एपीआई के रूप में नहीं बेचा जाता है। यह एक तैयार-टू-यूज़ मीटिंग और वार्तालाप उत्पाद है जो पहचान और अनुवाद को जोड़ता है। रीयल-टाइम अनुवाद कार्यप्रवाह यह 60 भाषाओं को सपोर्ट करता है और अनुवादित पाठ के साथ मूल भाषण को भी रखता है, जिससे उपयोगकर्ताओं को पहचान संबंधी त्रुटियों को अनुवाद संबंधी त्रुटियों से अलग करने में मदद मिलती है।.
ऑनलाइन कॉल के लिए, इसका लाइव मीटिंग अनुवाद यह चयनित माइक्रोफोन या कंप्यूटर-ऑडियो मार्ग के माध्यम से विभिन्न कॉन्फ्रेंसिंग वातावरणों के साथ काम कर सकता है।. पिक्चर-इन-पिक्चर उपशीर्षक उपयोगकर्ता को अलग से ट्रांसक्रिप्ट टैब देखने के लिए मजबूर करने के बजाय, समर्थित अनुप्रयोगों के ऊपर द्विभाषी पाठ को दृश्यमान रखें।.
कॉल करने से पहले, मुख्य शब्द और संदर्भ नाम, संक्षिप्त रूप, उत्पाद संबंधी शब्द और पृष्ठभूमि तैयार कर सकते हैं। सत्र के बाद, प्रतिलेख में मूल और अनुवादित पाठ दोनों सुरक्षित रहते हैं, जबकि एआई मीटिंग नोट्स यह सारांश और कार्रवाई योग्य मद तैयार कर सकता है। वर्तमान प्रतिलेख मार्गदर्शिका के अनुसार, बैठक के सारांश 55 भाषाओं में तैयार किए जा सकते हैं।.
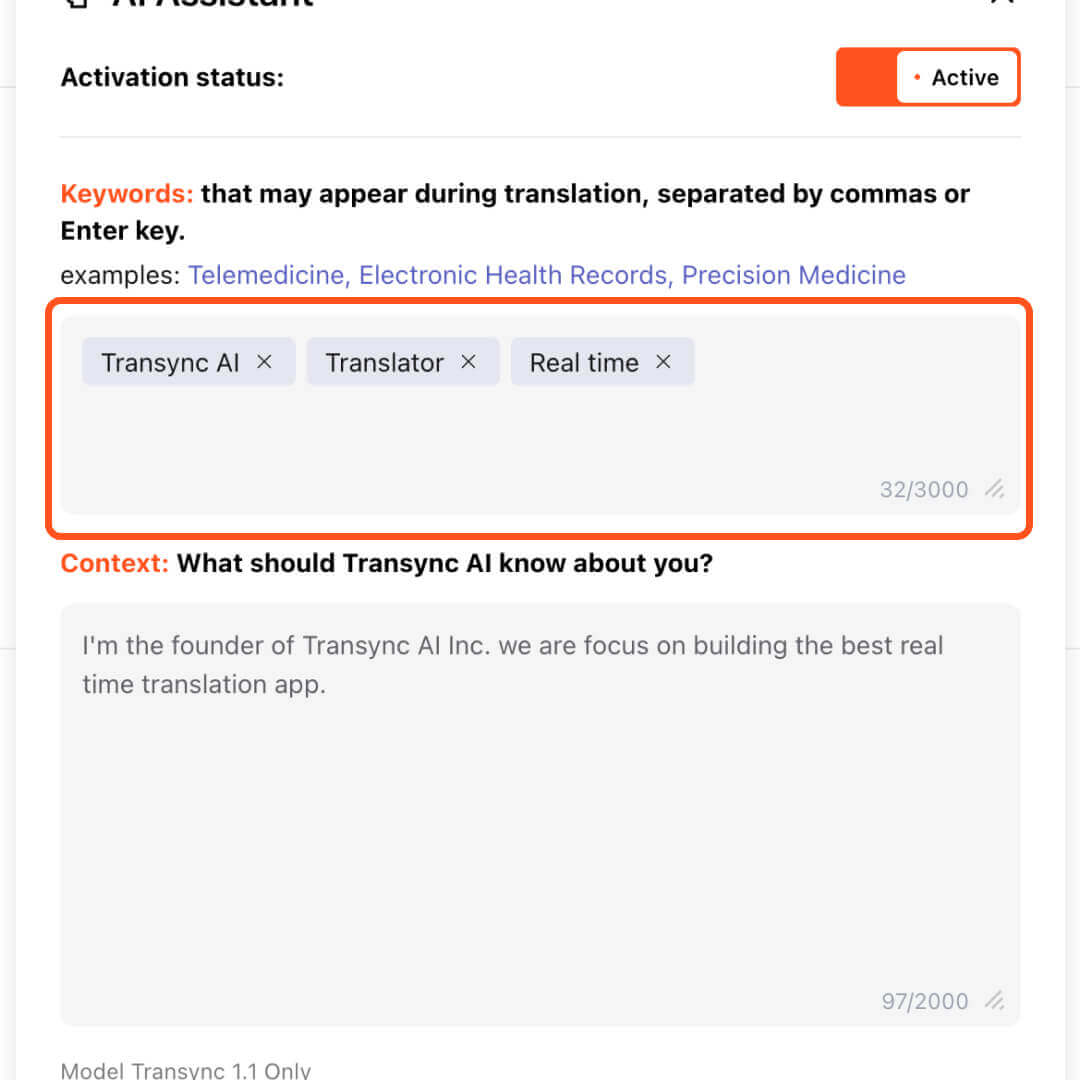
Transync AI इंटरफेस 'Transync AI', 'अनुवादक' और 'रीयल टाइम' जैसे कीवर्ड के साथ AI सहायक सक्रियण पैनल को हाइलाइट करता है, जिससे यह पता चलता है कि सटीक अनुवाद के लिए कस्टम कीवर्ड कैसे इनपुट करें।.
Transsync AI को मुफ़्त में आज़माएँ
चुनना Transync AI जब व्यावसायिक लक्ष्य विभिन्न भाषाओं में समझ और प्रतिक्रिया देना हो। इसके बजाय, स्ट्रीमिंग एपीआई का चयन तब करें जब टीम अपना स्वयं का वॉइस एजेंट, कॉल-विश्लेषण प्लेटफ़ॉर्म, एक्सेसिबिलिटी उत्पाद या एम्बेडेड ट्रांसक्रिप्शन इंटरफ़ेस बना रही हो।.
यह सीमा महत्वपूर्ण है: Transync AI यह कोई सामान्य ऑफ़लाइन डिक्टेशन इंजन या डेवलपर एसटीटी एंडपॉइंट नहीं है। किसी महत्वपूर्ण मीटिंग से पहले ऑडियो रूटिंग, नेटवर्क गुणवत्ता, भाषा युग्म, माइक्रोफ़ोन और रिमोट डिलीवरी की जाँच अवश्य कर लें।.
रूट 2: जब टर्न टाइमिंग उत्पाद का हिस्सा हो, तब डीपग्राम का उपयोग करें
दीपग्राम यह दस्तावेज़ डेवलपर्स के लिए विशेष रूप से उपयोगी है क्योंकि इसमें अंतरिम परिणाम, अंतिम खंड, पहचाने गए भाषण के अंतिम बिंदु और उच्चारण-समाप्ति की घटनाओं को अलग-अलग दर्शाया गया है। यह अलगाव किसी एप्लिकेशन को यह तय करने में मदद करता है कि कब टेक्स्ट प्रदर्शित करना है, स्थिर टेक्स्ट जोड़ना है या प्रतिक्रिया ट्रिगर करनी है।.
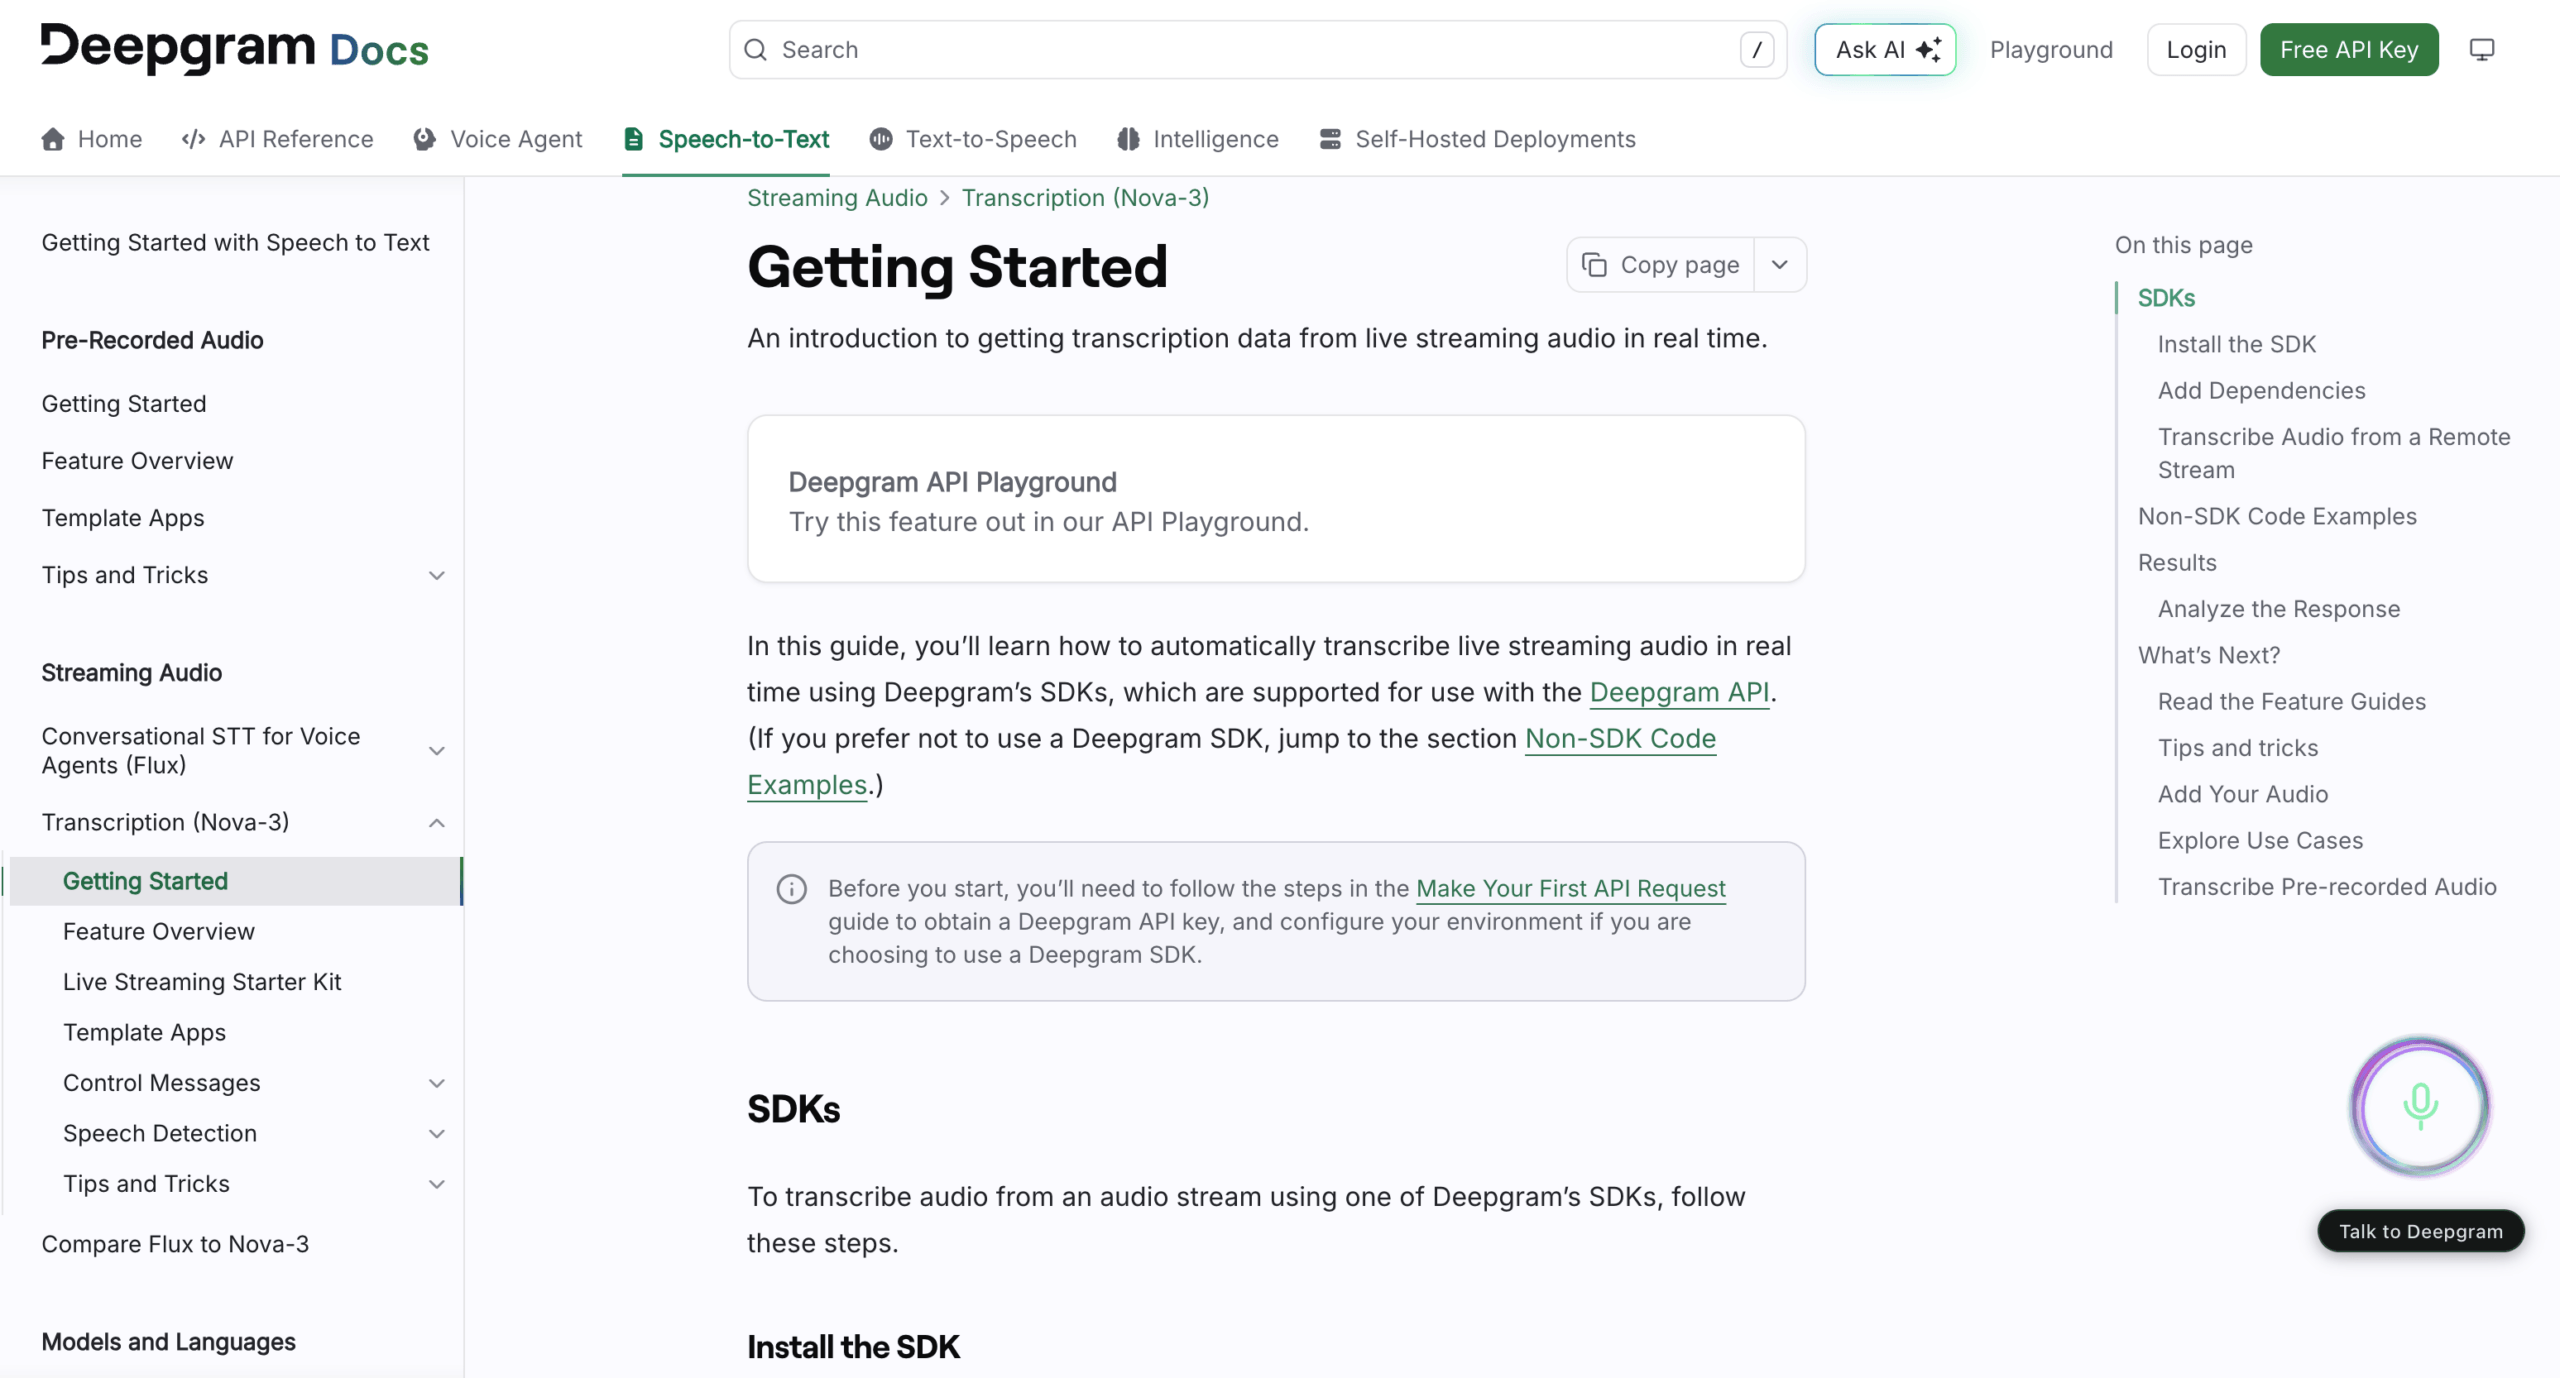
डीपग्राम स्ट्रीमिंग का अन्वेषण करें
उपयोग दीपग्राम जब उत्पाद टीम को एक निश्चित कैप्शन इंटरफ़ेस को स्वीकार करने के बजाय संवादात्मक व्यवहार को बेहतर बनाने की आवश्यकता होती है। ऑडियो परिवहन, स्थिति प्रबंधन, आंशिक-पाठ प्रतिपादन, भंडारण, प्रमाणीकरण, अनुमतियाँ, सुधार और अंतिम उपयोगकर्ता अनुभव की ज़िम्मेदारी अभी भी टीम के पास ही रहती है।.
कार्यान्वयन में एक आम गलती यह है कि केवल नवीनतम प्रतिक्रिया को सहेजा जाता है या केवल भाषण के अंतिम क्षण की प्रतीक्षा की जाती है। आधिकारिक दिशानिर्देश बताते हैं कि एक लंबे वाक्य में भाषण के अंत का पता चलने से पहले कई अंतिम रूप से तैयार किए गए प्रतिलेख खंड हो सकते हैं। एप्लिकेशन को अंतिम खंडों को सही ढंग से संयोजित करना होगा।.
तीसरा तरीका: स्ट्रीमिंग के दौरान स्पीकर लेबल महत्वपूर्ण होने पर AssemblyAI का उपयोग करें
AssemblyAI यह स्ट्रीमिंग मॉडल को आंशिक और अंतिम प्रतिलेख, एंडपॉइंटिंग, प्रमुख-शब्द संकेत, शब्द टाइमस्टैम्प और समर्थित स्पीकर-डायराइजेशन मोड प्रदान करता है। इसके दस्तावेज़ीकरण में स्पीकर-संशोधन घटनाओं का भी वर्णन है: जैसे-जैसे मॉडल अधिक साक्ष्य एकत्र करता है, यह पहले के स्पीकर लेबल को सही कर सकता है।.
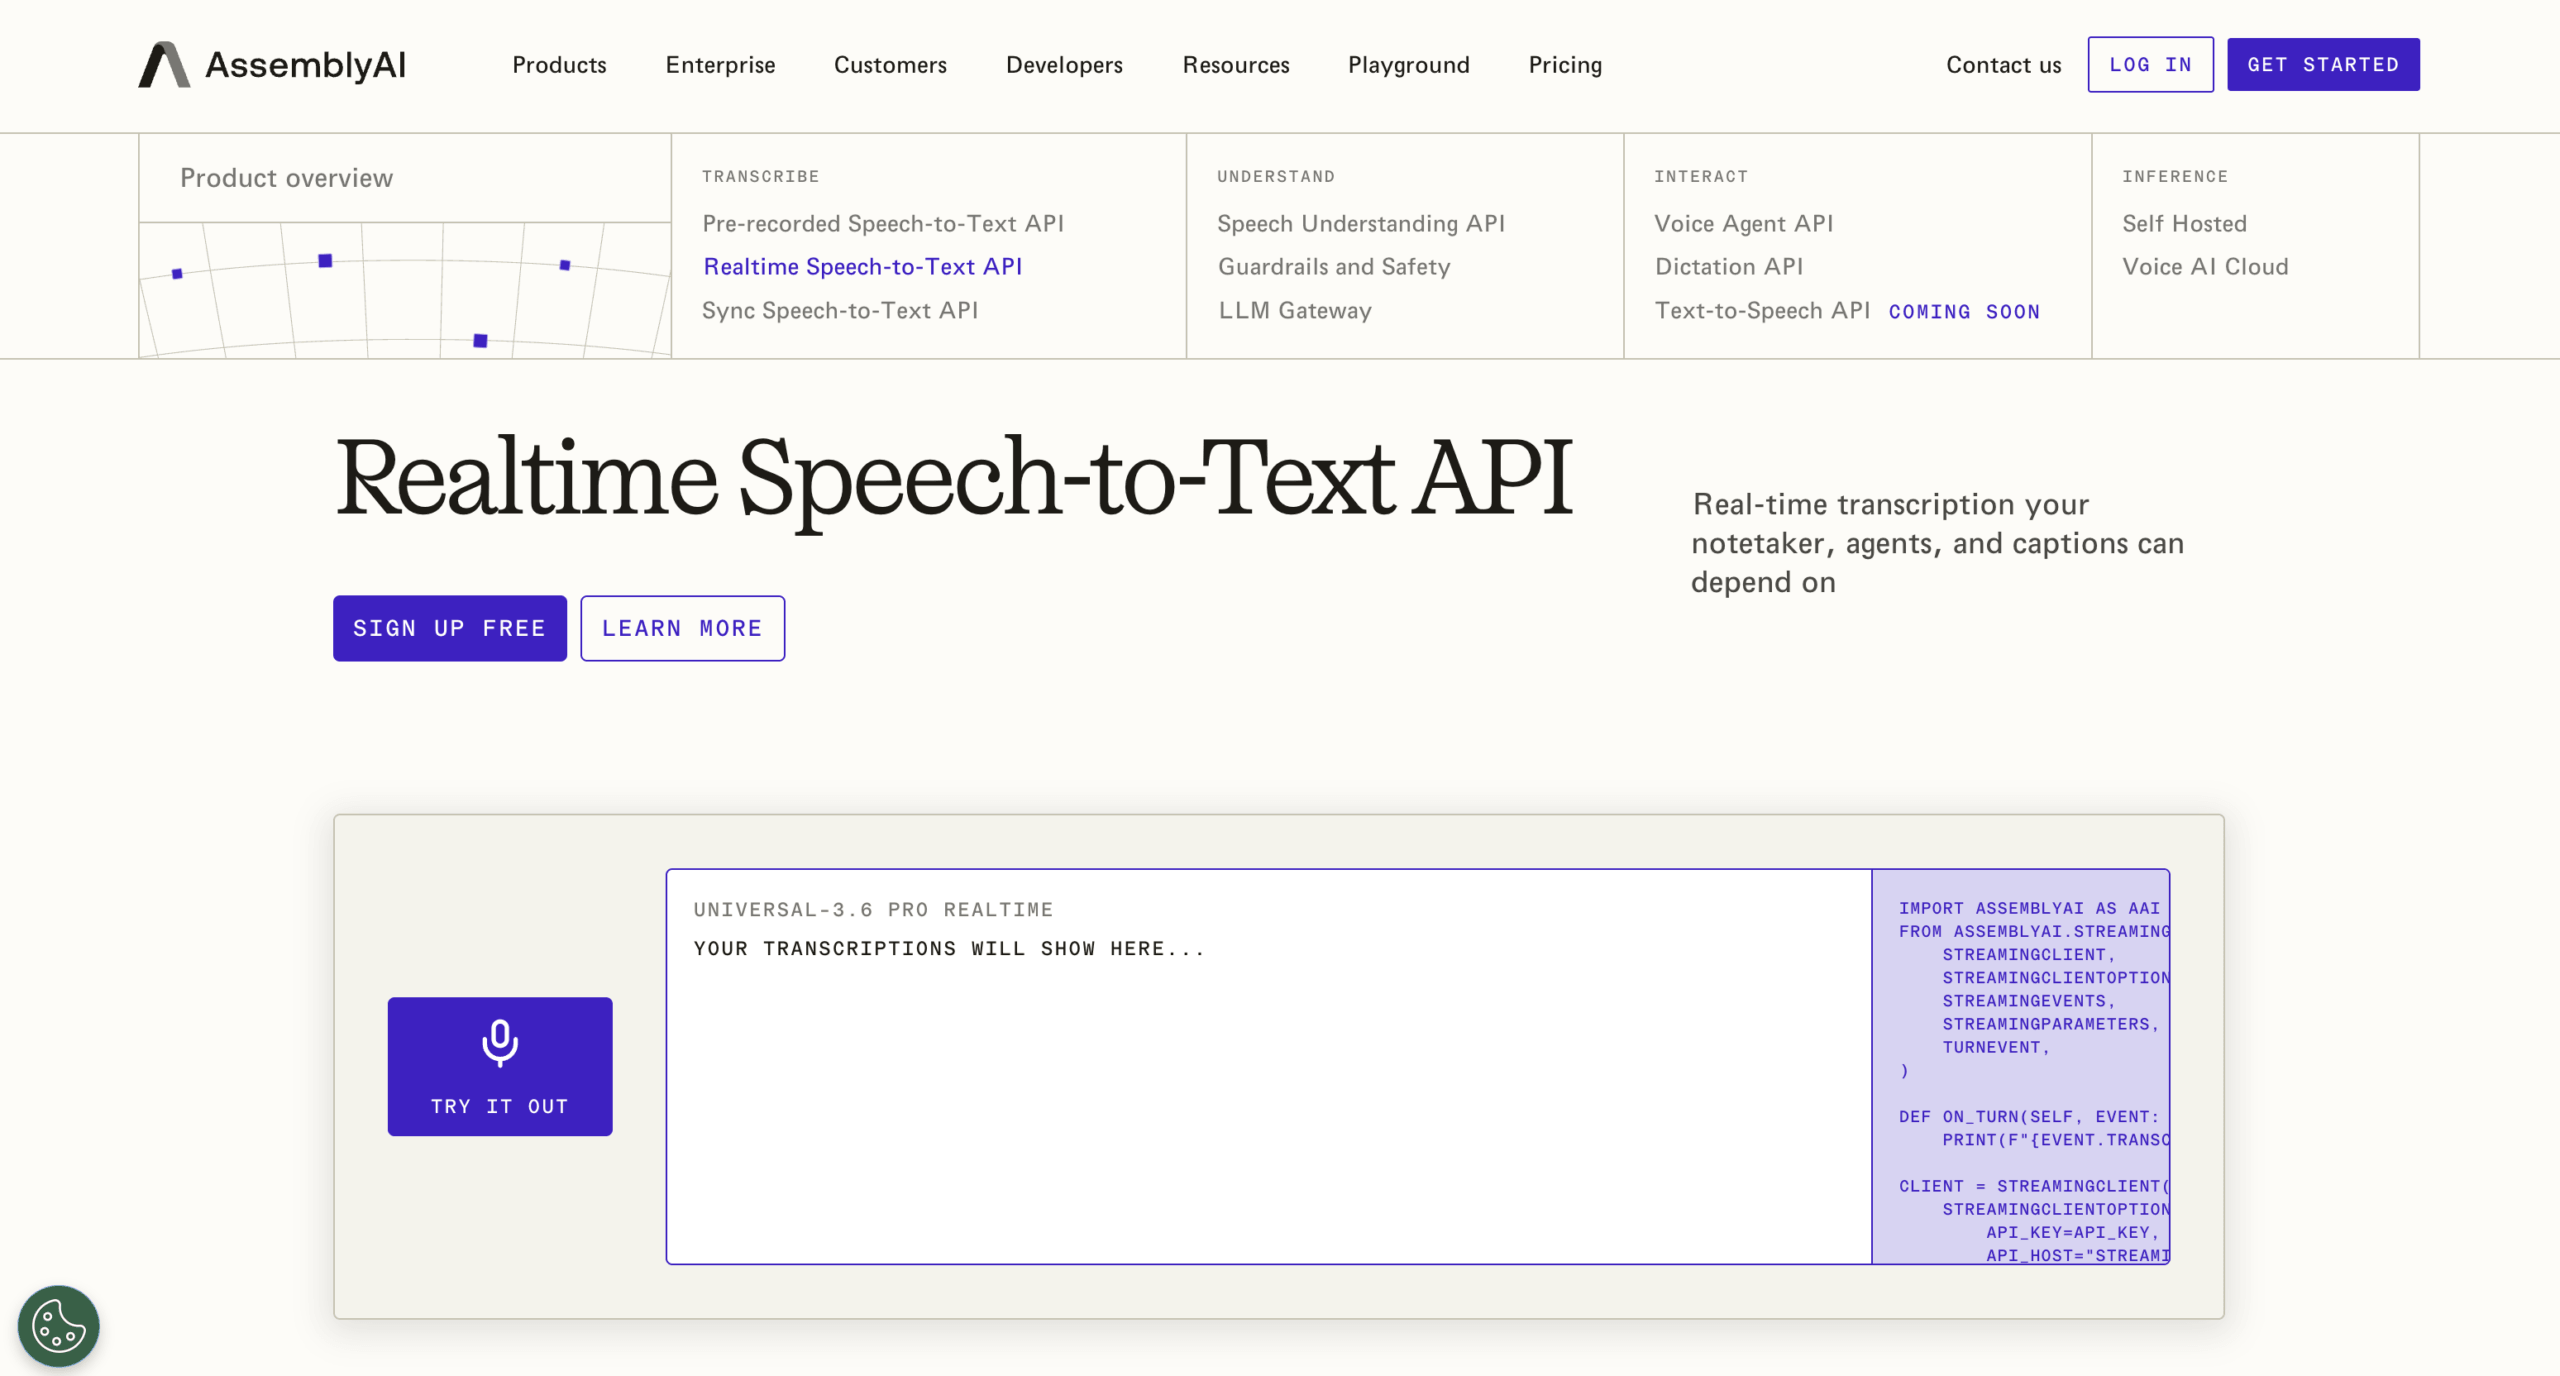
AssemblyAI स्ट्रीमिंग का अन्वेषण करें
लाइव इंटरफेस में संशोधन व्यवहार महत्वपूर्ण होता है। यदि कोई एप्लिकेशन "वक्ता A" को बहुत जल्दी स्थायी के रूप में चिह्नित कर देता है, तो बाद में किए गए सुधार संग्रहीत रिकॉर्ड तक कभी नहीं पहुंच पाएंगे। उपयोगकर्ता इंटरफेस को लंबित लेबल और संशोधनों के लिए एक सुनियोजित रणनीति की आवश्यकता होती है।.
चुनना AssemblyAI जब स्पीकर-अवेयर स्ट्रीमिंग और एप्लिकेशन-स्तरीय नियंत्रण महत्वपूर्ण हों। नियोजित तैनाती के लिए सटीक मॉडल, भाषा समर्थन, डायरीकरण व्यवहार, चिकित्सा विकल्प और डेटा आवश्यकताओं की पुष्टि करें; स्ट्रीमिंग मॉडल के अनुसार सुविधाएँ भिन्न होती हैं।.
रूट 4: बहुभाषी स्ट्रीमिंग एपीआई के लिए Soniox का उपयोग करें
सोनियॉक्स यह वेबसॉकेट एपीआई के माध्यम से रीयल-टाइम ट्रांसक्रिप्शन और अनुवाद को जोड़ता है। वर्तमान इंटरफ़ेस भाषा संकेत, संदर्भ अनुकूलन, वक्ता डायरीकरण, अनुवाद कॉन्फ़िगरेशन, टोकन-स्तरीय टाइमस्टैम्प, विश्वसनीयता, अंतिम स्थिति और भाषा संबंधी जानकारी का समर्थन करता है।.
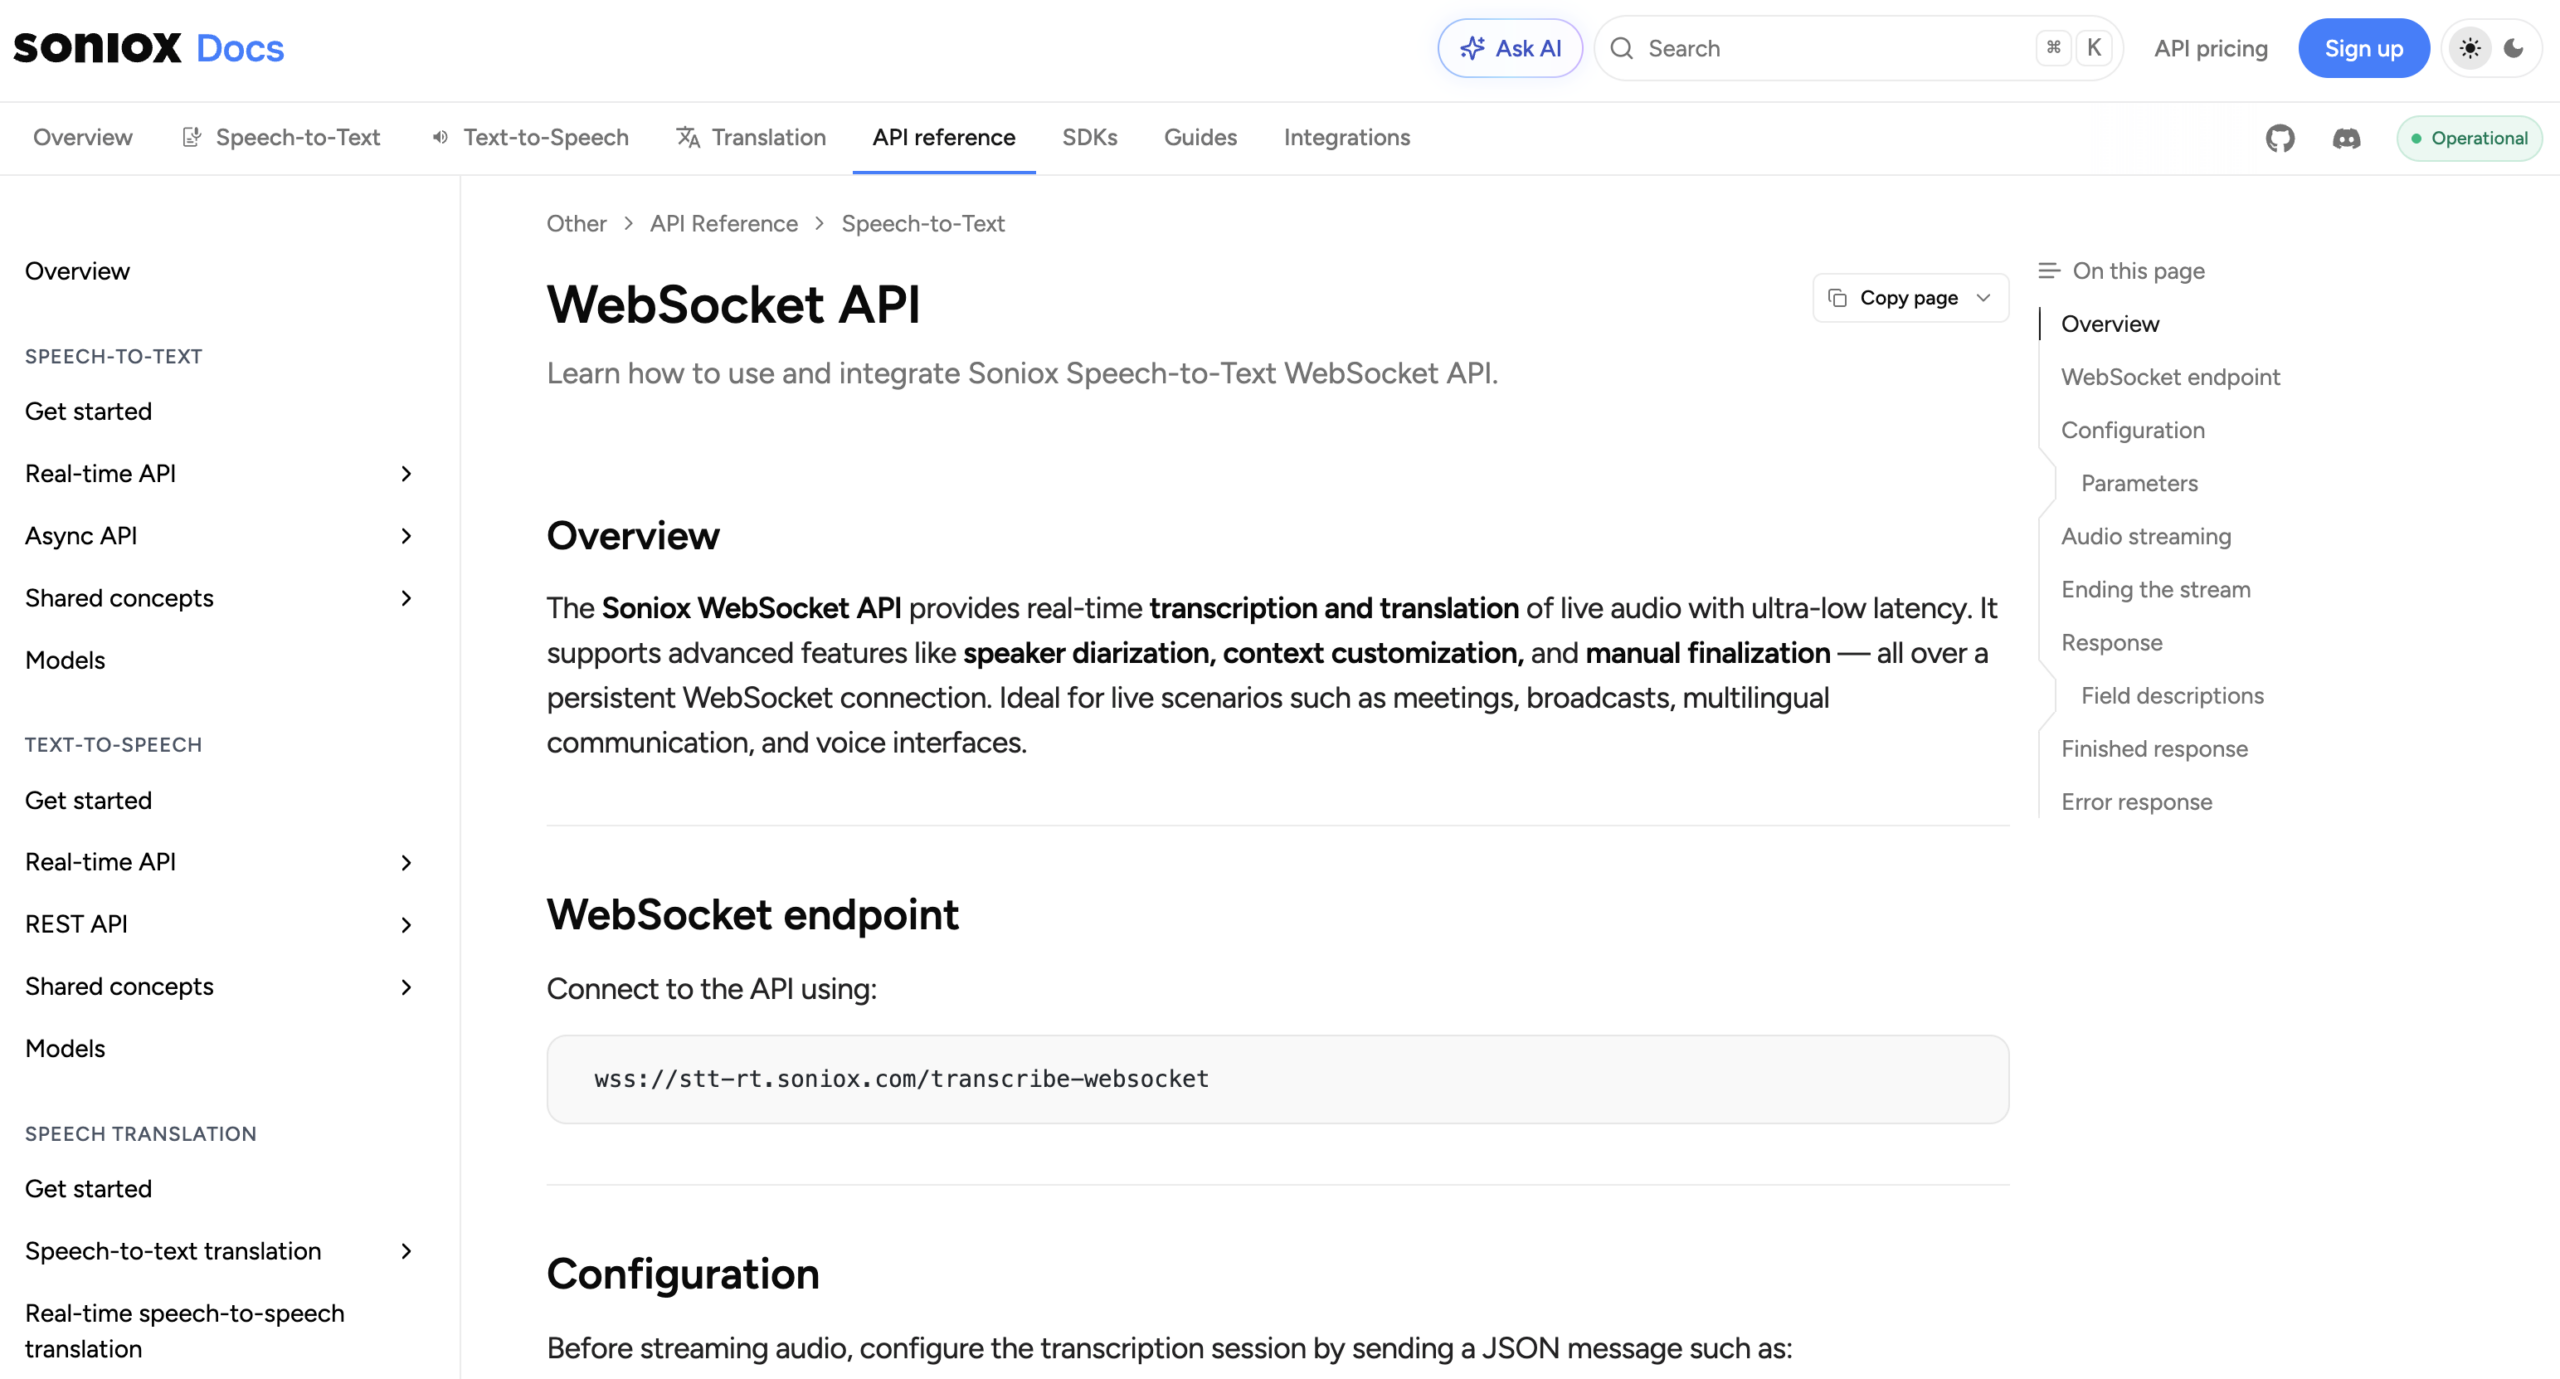
Soniox स्ट्रीमिंग का अन्वेषण करें
इससे सोनियॉक्स यह तब प्रासंगिक होता है जब डेवलपर्स चाहते हैं वास्तविक समय में भाषण को पाठ में परिवर्तित करना और अपने स्वयं के एप्लिकेशन के भीतर बहुभाषी आउटपुट। संदर्भ कॉन्फ़िगरेशन डोमेन शब्दों में मदद कर सकता है, लेकिन इसे फ़ीचर नाम से अनुमान लगाने के बजाय एक निश्चित शब्दावली स्क्रिप्ट के साथ परीक्षण किया जाना चाहिए।.
अन्य API की तरह, यह सेवा मूलभूत संरचनाएँ प्रदान करती है। खरीदार को प्रतिभागी पहुँच, सुधार, प्रतिधारण, निर्यात, सारांश, प्रशासनिक नियंत्रण, निगरानी, त्रुटि निवारण और समर्थन जैसी सुविधाएँ स्वयं बनानी होंगी।.
शब्द त्रुटि दर पर्याप्त क्यों नहीं है?
शब्द त्रुटि दर संदर्भ प्रतिलेख के आधार पर प्रतिस्थापन, विलोपन और सम्मिलन को मापती है। यह उपयोगी है, लेकिन एक औसत मान सबसे महत्वपूर्ण त्रुटियों को छिपा सकता है।.
इन दो त्रुटियों की तुलना करें:
- “हम शिपिंग कर सकते हैं गुरुवार”" बन जाता है "हम इसे भेज सकते हैं" मंगलवार.”
- “कृपया खोलें सेटिंग पैनल” बदलकर “कृपया खोलें” हो जाता है एक सेटिंग पैनल.”
दोनों की गिनती समान हो सकती है, लेकिन पहला एक प्रतिबद्धता को बदल देता है। इसके लिए एक त्रुटि बहीखाता बनाएं:
- नाम और वक्ता की पहचान।.
- संख्याएँ, मुद्राएँ, तिथियाँ और इकाइयाँ।.
- निषेध और शर्तें।.
- उत्पाद के नाम और विशेषज्ञ शब्दावली।.
- कोड-स्विचिंग और भाषा परिवर्तन।.
- व्यवधान और स्व-सुधार।.
- ऐसे विराम चिह्न जो अर्थ बदल देते हैं।.
फिर समय का ध्यान रखें। निर्णय लेने के बाद बोला गया सही शब्द भी गलत हो सकता है। बाद में सुधारी गई अस्थायी गलती के कारण भी वॉइस एजेंट या प्रतिभागी कोई कार्रवाई कर सकता है।.
दायाँ वास्तविक समय में भाषण को पाठ में परिवर्तित करना इसलिए स्कोर में तथ्यात्मक त्रुटि की गंभीरता, स्थिरता, बारी का समय और प्रस्तुति को शामिल किया जाता है - न कि केवल औसत शब्द सटीकता को।.
दो मिनट का सत्य टेप
एक ही रिकॉर्डिंग स्रोत का उपयोग करें ताकि प्रत्येक उम्मीदवार को एक समान ऑडियो प्राप्त हो। प्रत्येक विक्रेता को अपना डेमो चुनने की अनुमति न दें।.
लिखी हुई कहानी
- “"हैलो, मैं एस्टर-क्यू से नियाम ओ'रूर्के हूं।"”
- “यह संदर्भ संख्या BX-417 है, न कि BX-471।”
- “"राजस्व 13.6 प्रतिशत बढ़कर 15.05 मिलियन डॉलर हो गया।"”
- “"सेवा स्तर समझौते पर हस्ताक्षर किए बिना नवीनीकरण न करें।"”
- “"गुरुवार को पंद्रह—माफ़ कीजिए, पचास—यूनिट भेजिए।"”
- “"एपीआई वेबसॉकेट स्ट्रीमिंग और 300 मिलीसेकंड के एंडपॉइंट का उपयोग करती है।"”
- किसी सशर्त वाक्य के बीच में 700 मिलीसेकंड का विराम लें।.
- किसी दूसरे व्यक्ति को बोलने दें, फिर पहले वक्ता को बोलने का मौका दें।.
- आवश्यक दूसरी भाषा में एक वाक्य जोड़ें।.
- कीबोर्ड की आवाज सुनाई देते हुए, धीमी आवाज में एक वाक्य बोलकर समाप्त करें।.
कैप्चर शीट
| माप | इसे कैसे रिकॉर्ड करें | परीक्षण से पहले परिभाषित करने के लिए शर्त पास करें |
|---|---|---|
| पहला मैसेज भेजने का समय | पहले गैर-रिक्त परिकल्पना के लिए ऑडियो प्रारंभ | उपयोगकर्ता की दृश्य प्रतिक्रिया की आवश्यकता के आधार पर |
| स्थिर पाठ का समय | अंतिम बोले गए शब्द से लेकर अंतिम अपरिवर्तनीय पाठ तक | इतनी तेजी से कि लोग संशोधनों पर अमल न कर सकें |
| बारी-अंतिमता विलंब | इच्छित मोड़ का अंत, अंतिम बिंदु घटना या प्रतिक्रिया ट्रिगर | सामान्य विरामों में बाधा नहीं डालता या अनुत्तरदायी महसूस नहीं होता |
| संशोधन संख्या | दृश्यमान या एपीआई-स्तर पर परिकल्पना परिवर्तनों की संख्या | इंटरफ़ेस पठनीय बना रहता है और आगे की कार्रवाइयां अंतिम रूप से तय होने की प्रतीक्षा करती हैं। |
| महत्वपूर्ण तथ्य त्रुटियाँ | नाम, आंकड़े, निषेध, तिथियां, इकाइयां और स्थितियां | पायलट प्रोजेक्ट में बिना चिह्नित किए गए उच्च-गंभीरता वाली कोई त्रुटि नहीं थी। |
| स्पीकर-लेबल रिकवरी | व्यवधान के बाद समय और शुद्धता | संग्रहित प्रतिलेख में सही श्रेय दर्शाया गया है |
| वर्कफ़्लो पूर्णता | खोज योग्य/निर्यात योग्य रिकॉर्ड या एप्लिकेशन कार्रवाई के लिए बैठक समाप्त | परिचालन समयसीमा के अनुरूप है |
दस परीक्षण करें, फिर नमूने की उपलब्धता के अनुसार माध्यिका, 95वें प्रतिशतक और सबसे खराब देखे गए परिणामों की रिपोर्ट करें। एक पूर्ण परीक्षण से विश्वसनीयता स्थापित नहीं होती।.
विफलता के सात प्रकार और पहला समाधान
| लक्षण | संभावित परत | पहली उपयोगी जाँच |
|---|---|---|
| पहला शब्द आने के बाद पाठ देर से दिखाई देता है। | कैप्चर, बफरिंग, एन्कोडिंग, नेटवर्क या मॉडल | प्रत्येक चरण को मापें; ऑडियो के बड़े-बड़े हिस्सों को कम करें |
| पाठ शीघ्रता से दिखाई देता है लेकिन उसमें बहुत अधिक पुनर्लेखन की आवश्यकता होती है। | अंतरिम परिकल्पना व्यवहार | कार्रवाई शुरू करने से पहले अंतिम निर्णय की प्रतीक्षा करें; अस्थायी प्रदर्शन को पुनः डिज़ाइन करें |
| सिस्टम विचारशील वक्ताओं की आवाज़ काट देता है। | एंडपॉइंट थ्रेशोल्ड या वॉयस एक्टिविटी डिटेक्शन | जहां संभव हो, लंबे विरामों का परीक्षण करें और एंडपॉइंटिंग को ट्यून करें। |
| छोटे आदेशों के बाद सिस्टम बहुत देर तक प्रतीक्षा करता है | एंडपॉइंट थ्रेशोल्ड या एप्लिकेशन टर्न लॉजिक | कम सीमा या स्पष्ट अंत-वार नियंत्रणों का परीक्षण करें |
| नाम और कोड बार-बार विफल हो रहे हैं | ध्वनिक अस्पष्टता और अनुपलब्ध डोमेन संदर्भ | मुख्य शब्दों/संदर्भ को जोड़ें और माइक्रोफ़ोन की गुणवत्ता में सुधार करें |
| डिस्प्ले के बाद स्पीकर लेबल बदल जाते हैं | स्ट्रीमिंग डायराइजेशन क्लस्टरों को संशोधित कर रहा है | लंबित लेबलों का समर्थन करें और रिकॉर्ड पर संशोधन इवेंट लागू करें |
| प्रतिलेख तो जल्दी तैयार हो जाता है, लेकिन बाद में अनुपयोगी हो जाता है। | उत्पाद कार्यप्रवाह गायब है | सुधार, संग्रहण, खोज, अनुमतियाँ, निर्यात और विलोपन जैसी सुविधाएँ जोड़ें—या पहले से तैयार ऐप चुनें |
समस्याओं का निवारण वास्तविक समय में भाषण को पाठ में परिवर्तित करना बाएं से दाएं। मॉडल को बदलने से म्यूट इनपुट, गलत सैंपल रेट या ऐसा यूजर इंटरफेस जो अस्थायी टेक्स्ट को अंतिम रूप में सहेजता है, जैसी समस्याएं ठीक नहीं होंगी।.
जब स्पीच टू टेक्स्ट अंतिम कार्य नहीं होता है
प्रतिलेखन से यह सवाल उठता है, "किन शब्दों को पहचाना गया?" अनुवाद से यह सवाल उठता है, "उन शब्दों का दूसरी भाषा में क्या अर्थ है?" एक मीटिंग उत्पाद को इस सवाल का भी जवाब देना चाहिए, "क्या दूसरा व्यक्ति निर्णय को समझ सकता है, प्रतिक्रिया दे सकता है और बाद में उसे पुनः प्राप्त कर सकता है?"“
यदि सभी प्रतिभागी एक ही भाषा बोलते हैं और उन्हें एक्सेसिबिलिटी कैप्शन, डिक्टेशन, सर्च या एनालिटिक्स की आवश्यकता है, तो एक समर्पित STT API या ट्रांसक्रिप्शन उत्पाद पर्याप्त हो सकता है। यदि प्रतिभागी अलग-अलग भाषाओं का उपयोग करते हैं, तो वर्कफ़्लो में अतिरिक्त नियंत्रणों की आवश्यकता होती है:
- अनुवाद के बगल में मूल पाठ दिखाई दे रहा है।.
- भाषा का चयन या स्वचालित प्रबंधन।.
- शब्दावली और संदर्भ की तैयारी।.
- वार्तालाप के दौरान लक्षित भाषा में पाठ प्रस्तुत किया जाता है।.
- जब पढ़ना अव्यावहारिक हो तो वैकल्पिक रूप से अनुवादित आवाज का उपयोग किया जा सकता है।.
- बहुभाषी चर्चा को संरक्षित करने वाले अभिलेख और नोट्स।.
यही वह बिंदु है जहाँ वास्तविक समय में भाषण को पाठ में परिवर्तित करना यह बड़े हिस्से का एक घटक बन जाता है Transync AI अंतिम उत्पाद के बजाय कार्यप्रवाह पर ध्यान केंद्रित किया जाता है।.
रीयल टाइम स्पीच टू टेक्स्ट FAQ
रियल टाइम स्पीच टू टेक्स्ट क्या है?
वास्तविक समय में भाषण को पाठ में परिवर्तित करना यह सिस्टम बोलते समय ही स्ट्रीमिंग ऑडियो को अस्थायी और अंतिम टेक्स्ट में परिवर्तित करता है। जैसे-जैसे सिस्टम को अधिक संदर्भ प्राप्त होता है, यह किसी बात के समाप्त होने का पता लगाता है, विराम चिह्नों का प्रयोग करता है, या वक्ता की पहचान में सुधार करता है, वैसे-वैसे यह प्रारंभिक अनुमानों को संशोधित कर सकता है।.
कितनी देरी को वास्तविक समय माना जाता है?
कोई एक निश्चित सीमा नहीं है। पहले टेक्स्ट, स्थिर टेक्स्ट, अंतिम परिणाम और उपयोगी वर्कफ़्लो आउटपुट तक के समय को मापें। कैप्शन रीडर, वॉइस एजेंट, मीटिंग प्रतिभागी और कॉल के बाद समीक्षा करने वाले के लिए स्वीकार्य विलंब अलग-अलग होते हैं।.
लाइव टेक्स्ट में बदलाव क्यों होता रहता है?
स्ट्रीमिंग रिकॉग्नाइज़र वाक्य पूरा होने से पहले ही आंशिक परिकल्पनाएँ प्रकाशित कर देते हैं। बाद में ऑडियो से संभावित शब्द, विराम चिह्न, भाषा या वक्ता बदल सकते हैं। अनुप्रयोगों को अस्थायी परिणामों और अंतिम पाठ के बीच अंतर स्पष्ट रूप से बताना चाहिए।.
क्या रियल टाइम स्पीच टू टेक्स्ट और लाइव ट्रांसलेशन एक ही चीज़ हैं?
नहीं। स्पीच-टू-टेक्स्ट मूल भाषा में बोले गए शब्दों को पहचानता है। लाइव ट्रांसलेशन में एक और भाषा रूपांतरण जोड़ा जाता है और इसमें अनुवादित आवाज भी शामिल हो सकती है।. Transync AI यह बहुभाषी वार्तालापों के लिए पहचान और अनुवाद को संयोजित करता है।.
रियल टाइम स्पीच टू टेक्स्ट के लिए कौन सा एपीआई सबसे अच्छा है?
कोई सर्वव्यापी विजेता नहीं है।. दीपग्राम यह विस्तृत एंडपॉइंटिंग और परिणाम-स्थिति नियंत्रण प्रदान करता है।, AssemblyAI यह समर्थित स्ट्रीमिंग डायराइजेशन और संशोधन व्यवहार प्रदान करता है, और सोनियॉक्स इसमें बहुभाषी प्रतिलेखन और अनुवाद विकल्प शामिल हैं। प्रत्येक विकल्प को एक समान ऑडियो और उत्पाद की सटीक आवश्यकताओं के साथ परीक्षण करें।.
क्या रीयल टाइम स्पीच टू टेक्स्ट प्रोग्राम वक्ताओं की पहचान कर सकता है?
कुछ मॉडल डायराइज़ेशन या मल्टीचैनल इनपुट को सपोर्ट करते हैं, लेकिन लेबल अस्थायी हो सकते हैं और अधिक ऑडियो आने पर बदल सकते हैं। रुकावटों, मिलती-जुलती आवाज़ों, डिवाइस में बदलाव और संग्रहीत लेबल में सुधारों का परीक्षण करें।.
किसी व्यवसाय को सबसे पहले क्या परीक्षण करना चाहिए?
सबसे पहले वास्तविक ऑडियो रूट और दो मिनट की स्क्रिप्ट लें जिसमें नाम, संख्याएँ, निषेध, सुधार, विराम, रुकावटें, शब्दावली और आवश्यक भाषाएँ शामिल हों। चारों घड़ियों का समय मापें और सहेजे गए रिकॉर्ड का निरीक्षण करें।.
अंतिम निर्णय
सबसे तेज वास्तविक समय में भाषण को पाठ में परिवर्तित करना यह जरूरी नहीं है कि सिस्टम वही हो जो सबसे पहले पहला शब्द दिखाए। एक भरोसेमंद सिस्टम चार घड़ियों को संतुलित करता है:
पहला पाठ → स्थिर पाठ → पूर्ण बारी → प्रयोग करने योग्य रिकॉर्ड
जब डेवलपर्स को एंडपॉइंटिंग, आंशिक परिणाम, स्पीकर संशोधन और एप्लिकेशन व्यवहार को नियंत्रित करने की आवश्यकता हो, तो स्ट्रीमिंग API चुनें। जब टीम को ऑडियो से लेकर कैप्शन, अनुवाद, रिकॉर्ड और नोट्स तक का पूरा मार्ग चाहिए और इसके लिए बुनियादी ढांचा बनाने की आवश्यकता न हो, तो तैयार मीटिंग उत्पाद चुनें।.
सबसे महत्वपूर्ण बात यह है कि वास्तविक इनपुट और वास्तविक परिणाम का परीक्षण करें। दिखाई देने वाले शब्द, बदलने वाले शब्द, अंत में आने वाले मोड़ और बाद में व्यक्ति जिस रिकॉर्ड पर भरोसा करेगा, उन सभी का आकलन करें।.