Преобразование речи в текст в реальном времени — это больше, чем просто быстрые субтитры. Перед выбором учтите 4 скрытых таймера, правки, обработку говорящего и совместимость с многоязычными конференциями.
Преобразование речи в текст в реальном времени может отлично выглядеть в демонстрации, но всё равно не сработать в разговоре. Первые слова могут появиться через 300 миллисекунд, но предложение может продолжать меняться в течение двух секунд. Может появиться метка говорящего, а затем её нужно будет изменить. Отполированная стенограмма может быть готова быстро, но в ней может отсутствовать отрицание, повлиявшее на решение.
Вот почему вопрос “Насколько это быстро?” — неправильный первый вопрос. Для полезной оценки необходимы четыре «часа»: время до первого текста, время до стабильного текста, время до завершения хода и время до получения пригодной для использования записи. Каждый «час» отвечает различным оперативным потребностям.
В данной статье рассматривается преобразование речи в текст в реальном времени Он представляет собой измеримый конвейер обработки данных, а не визуальный эффект. Он сравнивает специализированные API для потоковой передачи данных с готовым к использованию многоязычным продуктом для проведения совещаний, предоставляет воспроизводимый сценарий тестирования и объясняет, когда одной транскрипции недостаточно, поскольку участникам необходим перевод, голосовой вывод или заметки.
Ответ за 60 секунд
Преобразование речи в текст в реальном времени Преобразует потоковое аудио в реальном времени в текст, пока говорящий еще говорит. Отображаемый текст часто является предварительным. Первые слова могут быть скорректированы по мере того, как модель получает больше контекста, обнаруживает паузу, идентифицирует говорящего, добавляет знаки препинания или завершает высказывание.
Четыре часовых механизма:
- Задержка первого текста: Сколько времени пройдет, прежде чем появится какая-либо гипотеза?
- Задержка стабильности: Сколько времени пройдет, прежде чем слова перестанут меняться?
- Задержка завершения хода: Сколько времени проходит, прежде чем система определит, что реплика или высказывание закончились?
- Задержка рабочего процесса: Через какое время расшифровка текста станет пригодна для поиска, заметок, действий, перевода или ответа на запрос в приложении?
Голосовой агент может отдавать приоритет завершению реплики, поскольку ему необходимо решить, когда отвечать. Субтитры для людей с ограниченными возможностями могут отдавать приоритет быстрому, читаемому частичному тексту. В протоколе совещания может быть допустимо несколько более медленное отображение, если имена, номера и указание говорящего станут более надежными. Многоязычное совещание добавляет еще один этап после распознавания: перевод должен поступить достаточно быстро, чтобы кто-то смог ответить.
Преобразование речи в текст в реальном времени — это пока ещё не до конца разработанная гипотеза.
Создание стенограммы в режиме реального времени не происходит за один шаг:
Аудиосигнал с микрофона или системы → кодирование и передача → распознавание речи → предварительное распознавание → редактирование → завершение → присвоение меток и форматирование говорящему → действие приложения
На экране обычно отображается только середина текста. Это создает распространенную иллюзию: поскольку текст появляется мгновенно, пользователи предполагают, что результат завершен. В действительности же поисковая система может все еще пересматривать границы слов, пунктуацию, язык или идентификацию говорящего.
Специализированные API-интерфейсы явно указывают на это различие. Дипграм Система возвращает промежуточные и окончательные результаты отдельно. В документации поясняется, что предварительный текст может изменяться, а окончательные сегменты следует добавлять для восстановления полного высказывания. Отдельный сигнал «окончательный результат речи» указывает на то, что система обнаружила конечную точку, например, паузу.
Сониокс Предоставляет доступ к окончательным и неокончательным токенам, временным меткам, уровню достоверности, информации о языке, необязательным меткам говорящего и ходу обработки через постоянное потоковое соединение. AssemblyAI Аналогичным образом, в поддерживаемых моделях предлагаются частичные и окончательные стенограммы, определение конечной точки, временные метки на уровне слов, подсказки по ключевым словам и потоковая диаризация говорящих.
Эти элементы управления полезны для разработчиков. Они также показывают, почему конечному пользователю не следует выносить суждения. преобразование речи в текст в реальном времени по одной лишь первой видимой линии.
Часы 1: Время до первого сообщения
Первый тактовый генератор запускается, когда речь достигает системы, и останавливается, когда первая непустая гипотеза становится видимой или доступной для приложения.
Данное измерение включает в себя не только вывод модели:
- Запись звука с микрофона или запись аудио с совещания.
- Размер буфера и разбивка аудиофрагментов.
- Передискретизация или кодирование.
- Сетевой транспорт.
- Обработка на сервере.
- Обратный транспорт.
- Отображение интерфейса.
Мера преобразование речи в текст в реальном времени Данные о задержках на стороне сервера, предоставляемые поставщиком, могут не включать буферизацию звука, сетевые проблемы клиента, отрисовку в браузере и задержку самой платформы для проведения совещаний.
Быстрый ввод текста важен, когда пользователям необходимо убедиться, что система их слышит. Он менее полезен, когда интерфейс побуждает их реагировать на нестабильные слова. Хороший дизайн подписи визуально выделяет предварительный текст, не делая его нечитаемым.
Как проверить первые часы
Запишите тот же звук и изображение с экрана со скоростью 60 кадров в секунду. Хлопните в ладоши один раз, затем произнесите: “Продление не одобрено”. Отметьте кадр, где звуковой сигнал или хлопок достигают входного сигнала, и кадр, где появляется первый текст. Повторите десять раз и сообщите средний и самый медленный результат, а не лучший.
Тест преобразование речи в текст в реальном времени При использовании обычного Wi-Fi, перегруженной сети, ноутбука с шумоподавлением и самих наушников или микрофона в помещении скорость отправки первого текста, которая исчезает при нормальной нагрузке, не является надежной характеристикой продукта.
Часы 2: Время стабилизации текста
Второй таймер останавливается, когда фрагмент текста перестает меняться. Именно этот таймер чаще всего скрывают в маркетинговых демонстрациях.
Рассмотрим произнесённую фразу:
“Отправить пятнадцать — простите, пятьдесят — единиц в четверг”.”
На экране может отображаться надпись “корабль 15”, затем “корабль 50”, а затем — пунктуационная поправка. Первая версия пришла быстро, но только окончательная версия может быть безопасно использована для заказа.
Стабильность важна, потому что нижестоящие системы могут реагировать слишком рано. Система оперативного обновления информации, помощник по продажам, триггер соответствия требованиям, слой перевода или голосовой агент могут унаследовать предварительную ошибку. преобразование речи в текст в реальном времени В рамках рабочего процесса разработчикам следует обрабатывать сигналы завершения работы движка, а не рассматривать каждое частичное обновление как завершенное сообщение.
Измеряйте расстояние до места внесения изменений, а не только задержку.
Для каждого тестового предложения запишите в лог:
- Количество предварительных версий.
- Количество замененных или удаленных слов.
- Время между последним произнесенным словом и появлением стабильного текста.
- Проверяется, соответствует ли окончательная сохраненная стенограмма стабильному отображению.
- Было ли инициировано какое-либо последующее действие до достижения стабильности.
Немного медленнее преобразование речи в текст в реальном времени Система может быть безопаснее, если она вносит изменения менее агрессивно. Оптимальный компромисс зависит от того, читают ли пользователи, диктуют, управляют программным обеспечением или ведут переговоры.
Часы 3: Время до завершения хода
Слова могут быть окончательными, в то время как реплика говорящего — нет. Человек может сделать паузу, чтобы подумать, перевести дыхание, поискать нужную фигуру или дождаться прерывания. Если система объявляет о завершении реплики слишком рано, голосовой агент может перебить пользователя. Если же ожидание затягивается, разговор кажется вялым.
Обычно для определения окончания речи используется пауза или голосовая активность. Дипграм документы настраиваемые конечные точки и отдельные is_final и speech_final В рекомендациях отмечается, что короткие пороговые значения подходят для кратких ответов чат-ботов, в то время как для более длительных пауз в разговоре может потребоваться несколько сотен миллисекунд, прежде чем реплика будет считаться завершенной.
Универсального сценария, подходящего для каждого говорящего, не существует. Быстрый сценарий разговора в колл-центре, нерешительный рассказ о медицинской истории, лекция в классе и двуязычные переговоры предполагают разные модели пауз. Поэтому завершенность реплики является ключевым моментом. преобразование речи в текст в реальном времени измерение, а не просто настройка API.
Проведите тест на рывки
Используйте эти четыре строки:
- “Номер моего счета: … 4172”.”
- “Согласен… если дата доставки останется пятницей”.”
- “Дозировка составляет пятнадцать — нет, пятьдесят — миллиграммов”.”
- “Ана, ты можешь…” — после чего второй говорящий прервал их.
Подсчитайте количество ложных окончаний реплик, запоздалых конечных точек, прерываний и обрезанных слов. Затем настройте пороговое значение конечной точки только в том случае, если приложение его предоставляет. Если продукт представляет собой готовое приложение, понаблюдайте за его поведением и решите, подходит ли оно для решения поставленной задачи.
Эти часы находятся там. преобразование речи в текст в реальном времени Это превращается в инженерию разговора, а не в обычную транскрипцию.
Часы 4: Время до получения пригодной для использования записи
Четвертый контрольный таймер — самый важный для команд. Он заканчивается, когда результат позволяет предпринять следующее действие.
“Пригодный к использованию” может означать:
- Субтитры остаются читаемыми на протяжении всего сеанса.
- Выступающих можно идентифицировать.
- Имена, числа и терминология подлежат исправлению.
- Полную стенограмму можно скопировать или экспортировать.
- Данная запись доступна для поиска и имеет защищенный доступ.
- Создается сводная информация и план действий.
- Исходный и переведенный текст остаются парными.
- Принципы сохранения и удаления понятны.
Система может выиграть первые три тайминга и проиграть четвертый. Потоковая передача JSON-данных не является записью совещания. Быстро исчезающие субтитры не являются доказательством. Красивое резюме без отслеживаемой стенограммы может скрывать ошибки распознавания. Вот почему. преобразование речи в текст в реальном времени При закупках необходимо оценивать как завершенный рабочий процесс, так и модель потоковой передачи данных.
Преобразование речи в текст в реальном времени Поэтому оценку следует проводить в момент использования, а не в момент создания. Попросите участника, рецензента, разработчика и администратора протестировать одну и ту же сессию со своей точки зрения.
Четыре маршрута, сравненные по четырем часам
| инструменты | Тип продукта | Первый текст | Контроль стабильности и конечности | Обработка динамиков | Многоязычная роль | Рабочий процесс создания удобной для использования записи | Лучший вариант |
|---|---|---|---|---|---|---|---|
| Transync AI | Готовое к использованию приложение для перевода совещаний | Двуязычная прямая трансляция | Управляется самим продуктом, а не предоставляется в виде параметров API. | Автоматически определяет выбранную языковую пару; проверка текста в оригинале и в переводе. | 60 языков, двуязычные субтитлы, перевод озвучки. | Запись перевода, стенограмма и краткое изложение совещания с использованием ИИ. | Для отдельных лиц и команд, которым необходима оперативная межъязыковая коммуникация без создания приложения. |
| Дипграм | API для потоковой передачи речи в текст | Можно включить отображение промежуточных результатов. | Отображает промежуточные/окончательные результаты, определение конечной точки, события завершения речи, элементы управления завершением высказывания и ручную окончательную обработку. | Возможности диаризации и многоканального воспроизведения зависят от конфигурации/модели. | Выбор языка и модели потоковой передачи; перевод — это отдельное решение в рамках рабочего процесса. | Заказчик должен разработать интерфейсы для хранения данных, редактирования, управления правами доступа, создания сводок и пользовательского интерфейса. | Разработчики, создающие голосовых агентов, субтитры, системы анализа звонков или продукты для пользовательской транскрипции. |
| AssemblyAI | API для потоковой передачи речи в текст | Частичные стенограммы, возвращаемые через потоковое соединение. | Интеллектуальное определение конечных точек и неизменяемые окончательные транскрипты; применяется поведение, специфичное для модели. | В поддерживаемых моделях доступны потоковая диаризация и события редактирования речи говорящим. | Многоязычная потоковая модель поддерживает опубликованный набор языков. | Заказчик разрабатывает готовое приложение и обеспечивает полный цикл обработки записей. | Командам разработчиков продуктов требуется распознавание потоков данных с помощью диаризации и анализа последующих данных. |
| Сониокс | API искусственного интеллекта для обработки речи в реальном времени | Нефинальные токены передаются с низкой задержкой. | Флаги финального токена, ручная финализация, временные метки токена и ход обработки. | Дополнительная возможность диаризации говорящих | Многоязычная транскрипция и перевод в режиме реального времени через конфигурацию API | Заказчик разрабатывает интерфейс, обеспечивает хранение данных, проводит проверку и управляет процессами. | Разработчики, создающие многоязычные системы для проведения совещаний, трансляций, голосовых помощников или голосовых интерфейсов. |
Функциональные возможности были проверены по официальной документации продукта 3 октября 2026 года. Модели, языки, ограничения и цены могут меняться.
В таблице нет единого универсального победителя. Она различает два варианта покупки: разработка продукта на основе потокового API или использование готового рабочего процесса. Лучший из них преобразование речи в текст в реальном времени Маршрут зависит от того, кто отвечает за захват звука, разработку интерфейса, исправление ошибок, хранение и поддержку.
Вариант 1: Использование ИИ Transync, когда речь должна передаваться между языками.
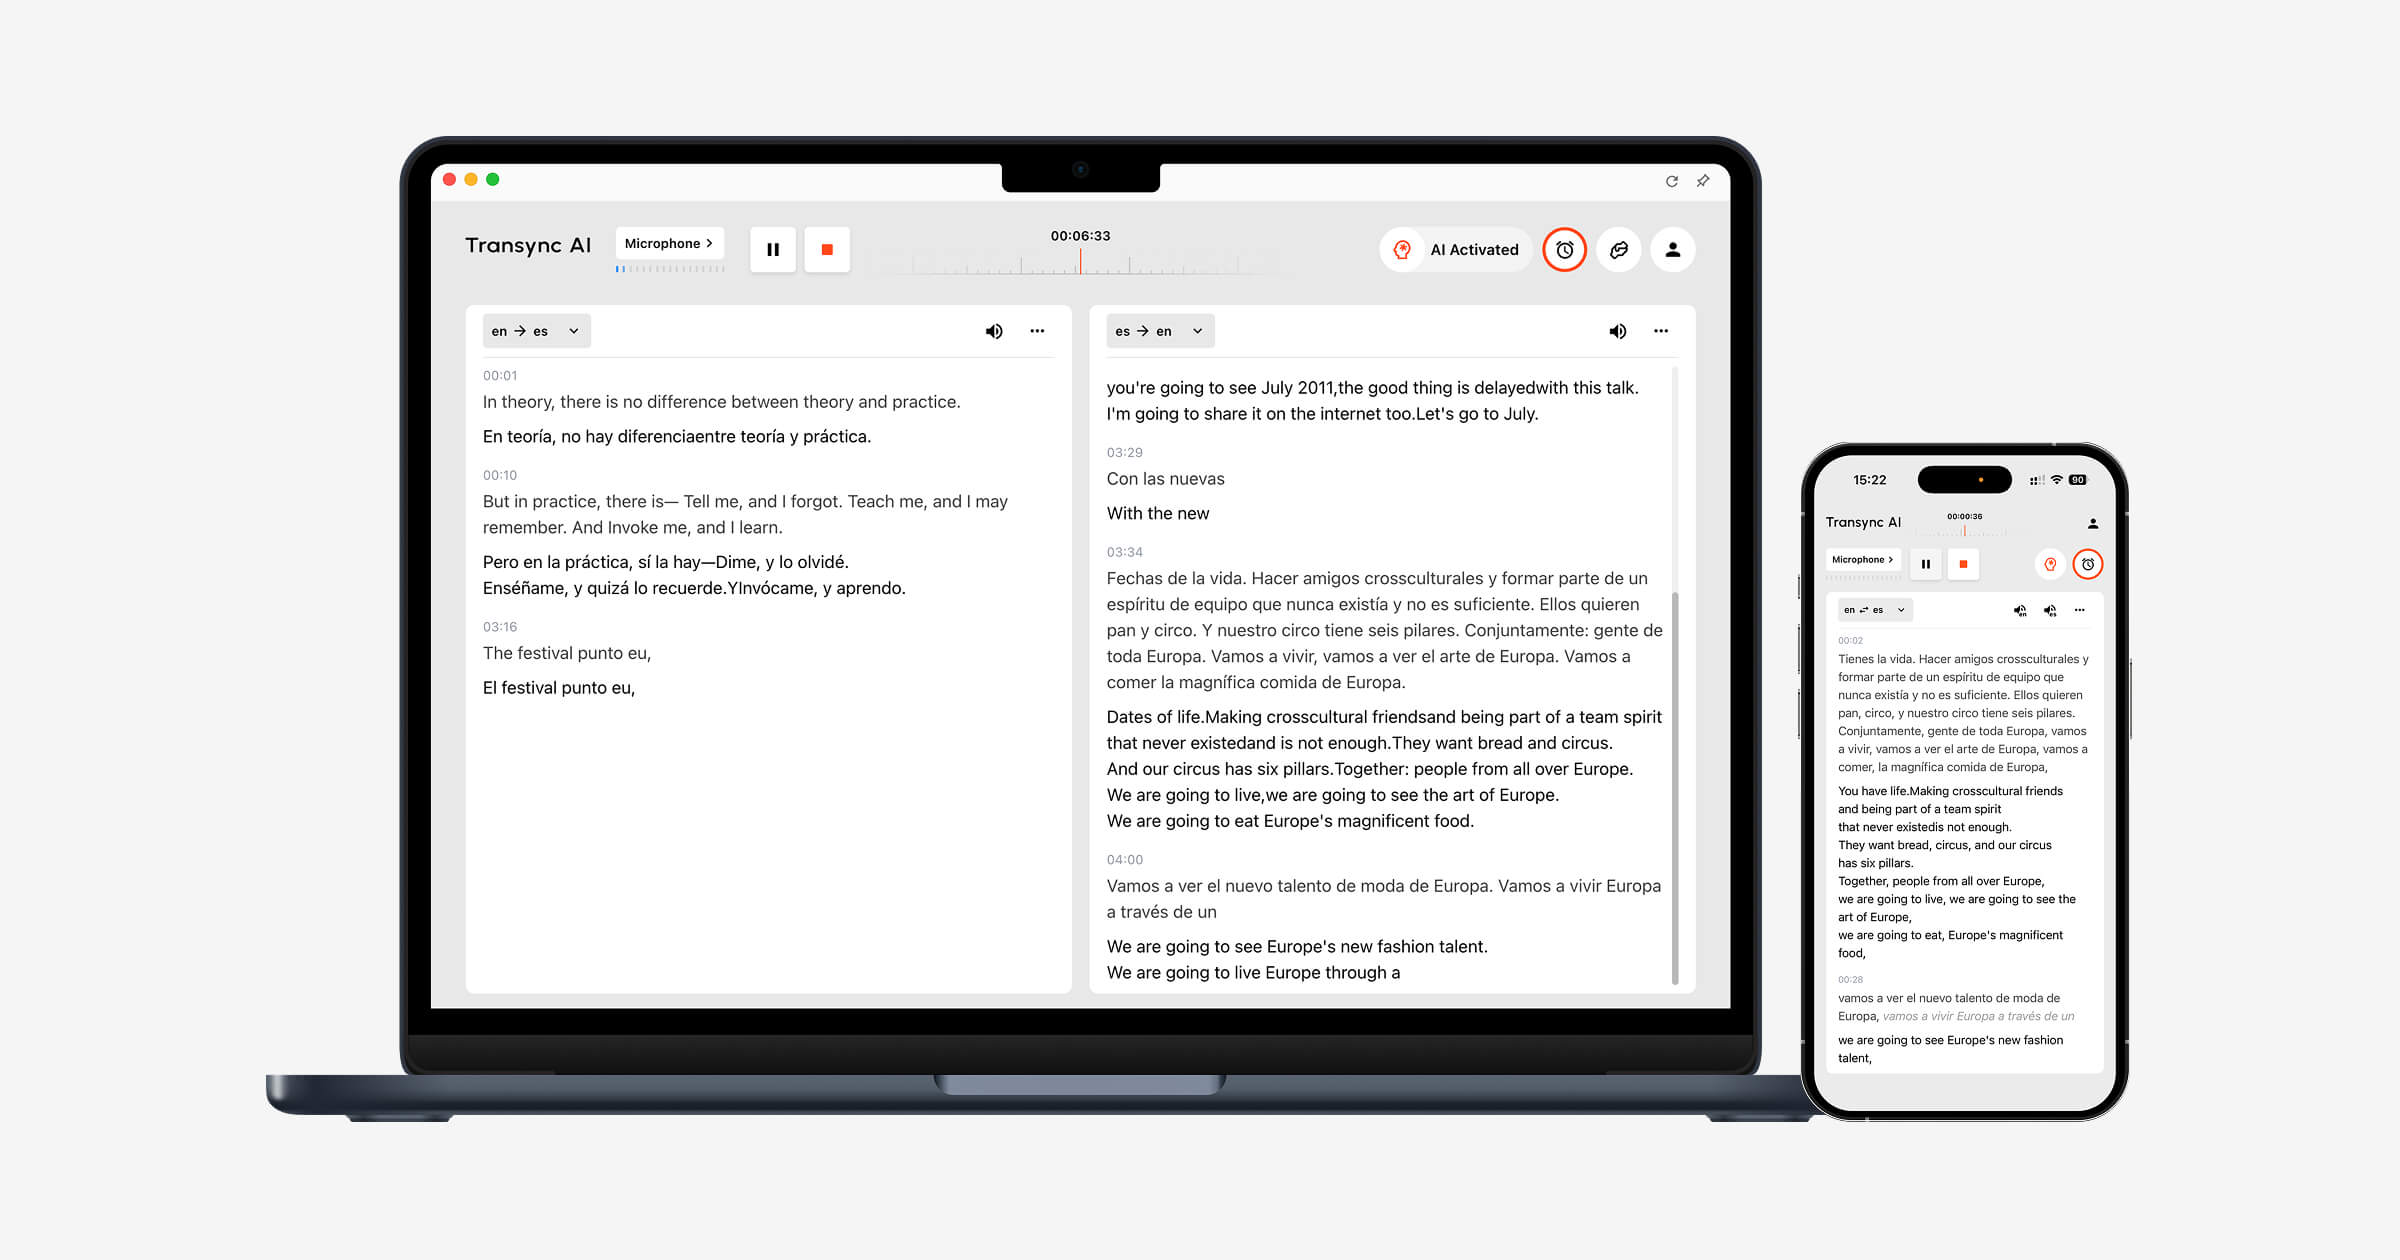
Transync AI Он не продается как универсальный API для преобразования речи в текст. Это готовый к использованию продукт для проведения совещаний и ведения разговоров, который сочетает распознавание речи с переводом. рабочий процесс перевода в реальном времени Поддерживает 60 языков и сохраняет оригинальную речь рядом с переведенным текстом, что помогает пользователям отличать ошибки распознавания от ошибок перевода.
Для онлайн-звонков это перевод онлайн-встреч может работать в различных средах для проведения конференций, используя выбранный микрофон или канал передачи звука с компьютера. Субтитры «картинка в картинке» Оставляйте двуязычный текст видимым над поддерживаемыми приложениями, вместо того чтобы заставлять пользователя просматривать отдельную вкладку с текстовой расшифровкой.
Перед звонком, Ключевые слова и контекст Можно подготовить имена, аббревиатуры, термины, относящиеся к продукту, и справочную информацию. После сессии стенограмма сохраняет исходный и переведенный текст, при этом Заметки о встрече ИИ Можно создавать резюме и пункты плана действий. В текущем руководстве по составлению стенограмм указано, что резюме совещаний можно создавать на 55 языках.
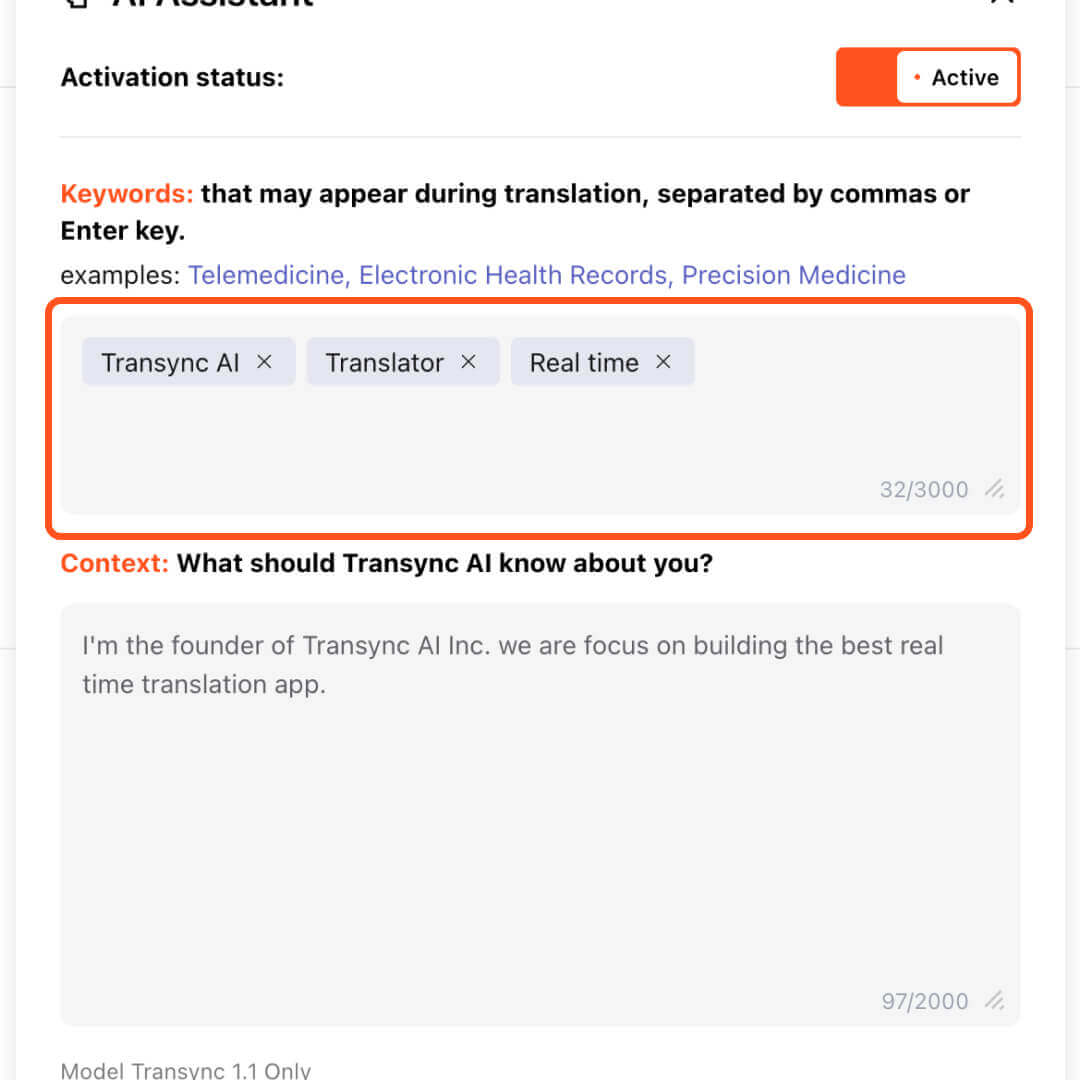
В интерфейсе Transync AI отображается панель активации ИИ-помощника с ключевыми словами ‘Transync AI’, ‘Переводчик’ и ‘В режиме реального времени’, показывающая, как вводить пользовательские ключевые слова для точного перевода.
Попробуйте Transync AI бесплатно
Выбирать Transync AI Когда целью бизнеса является понимание и реагирование на запросы на разных языках, выбирайте потоковый API, если команда разрабатывает собственного голосового агента, платформу анализа звонков, продукт для обеспечения доступности или встроенный интерфейс транскрипции.
Это ограничение важно: Transync AI Это не универсальный механизм диктовки в автономном режиме и не конечная точка STT для разработчиков. Маршрутизацию звука, качество сети, языковые пары, микрофоны и удаленную доставку следует проверить перед важным совещанием.
Вариант 2: Использование Deepgram, когда время поворота является частью продукта.
Дипграм Этот инструмент особенно полезен для разработчиков, поскольку в его документации разделяются промежуточные результаты, завершенные сегменты, обнаруженные конечные точки речи и события завершения высказывания. Такое разделение позволяет приложению решать, когда отображать текст, добавлять постоянный текст или запускать ответ.
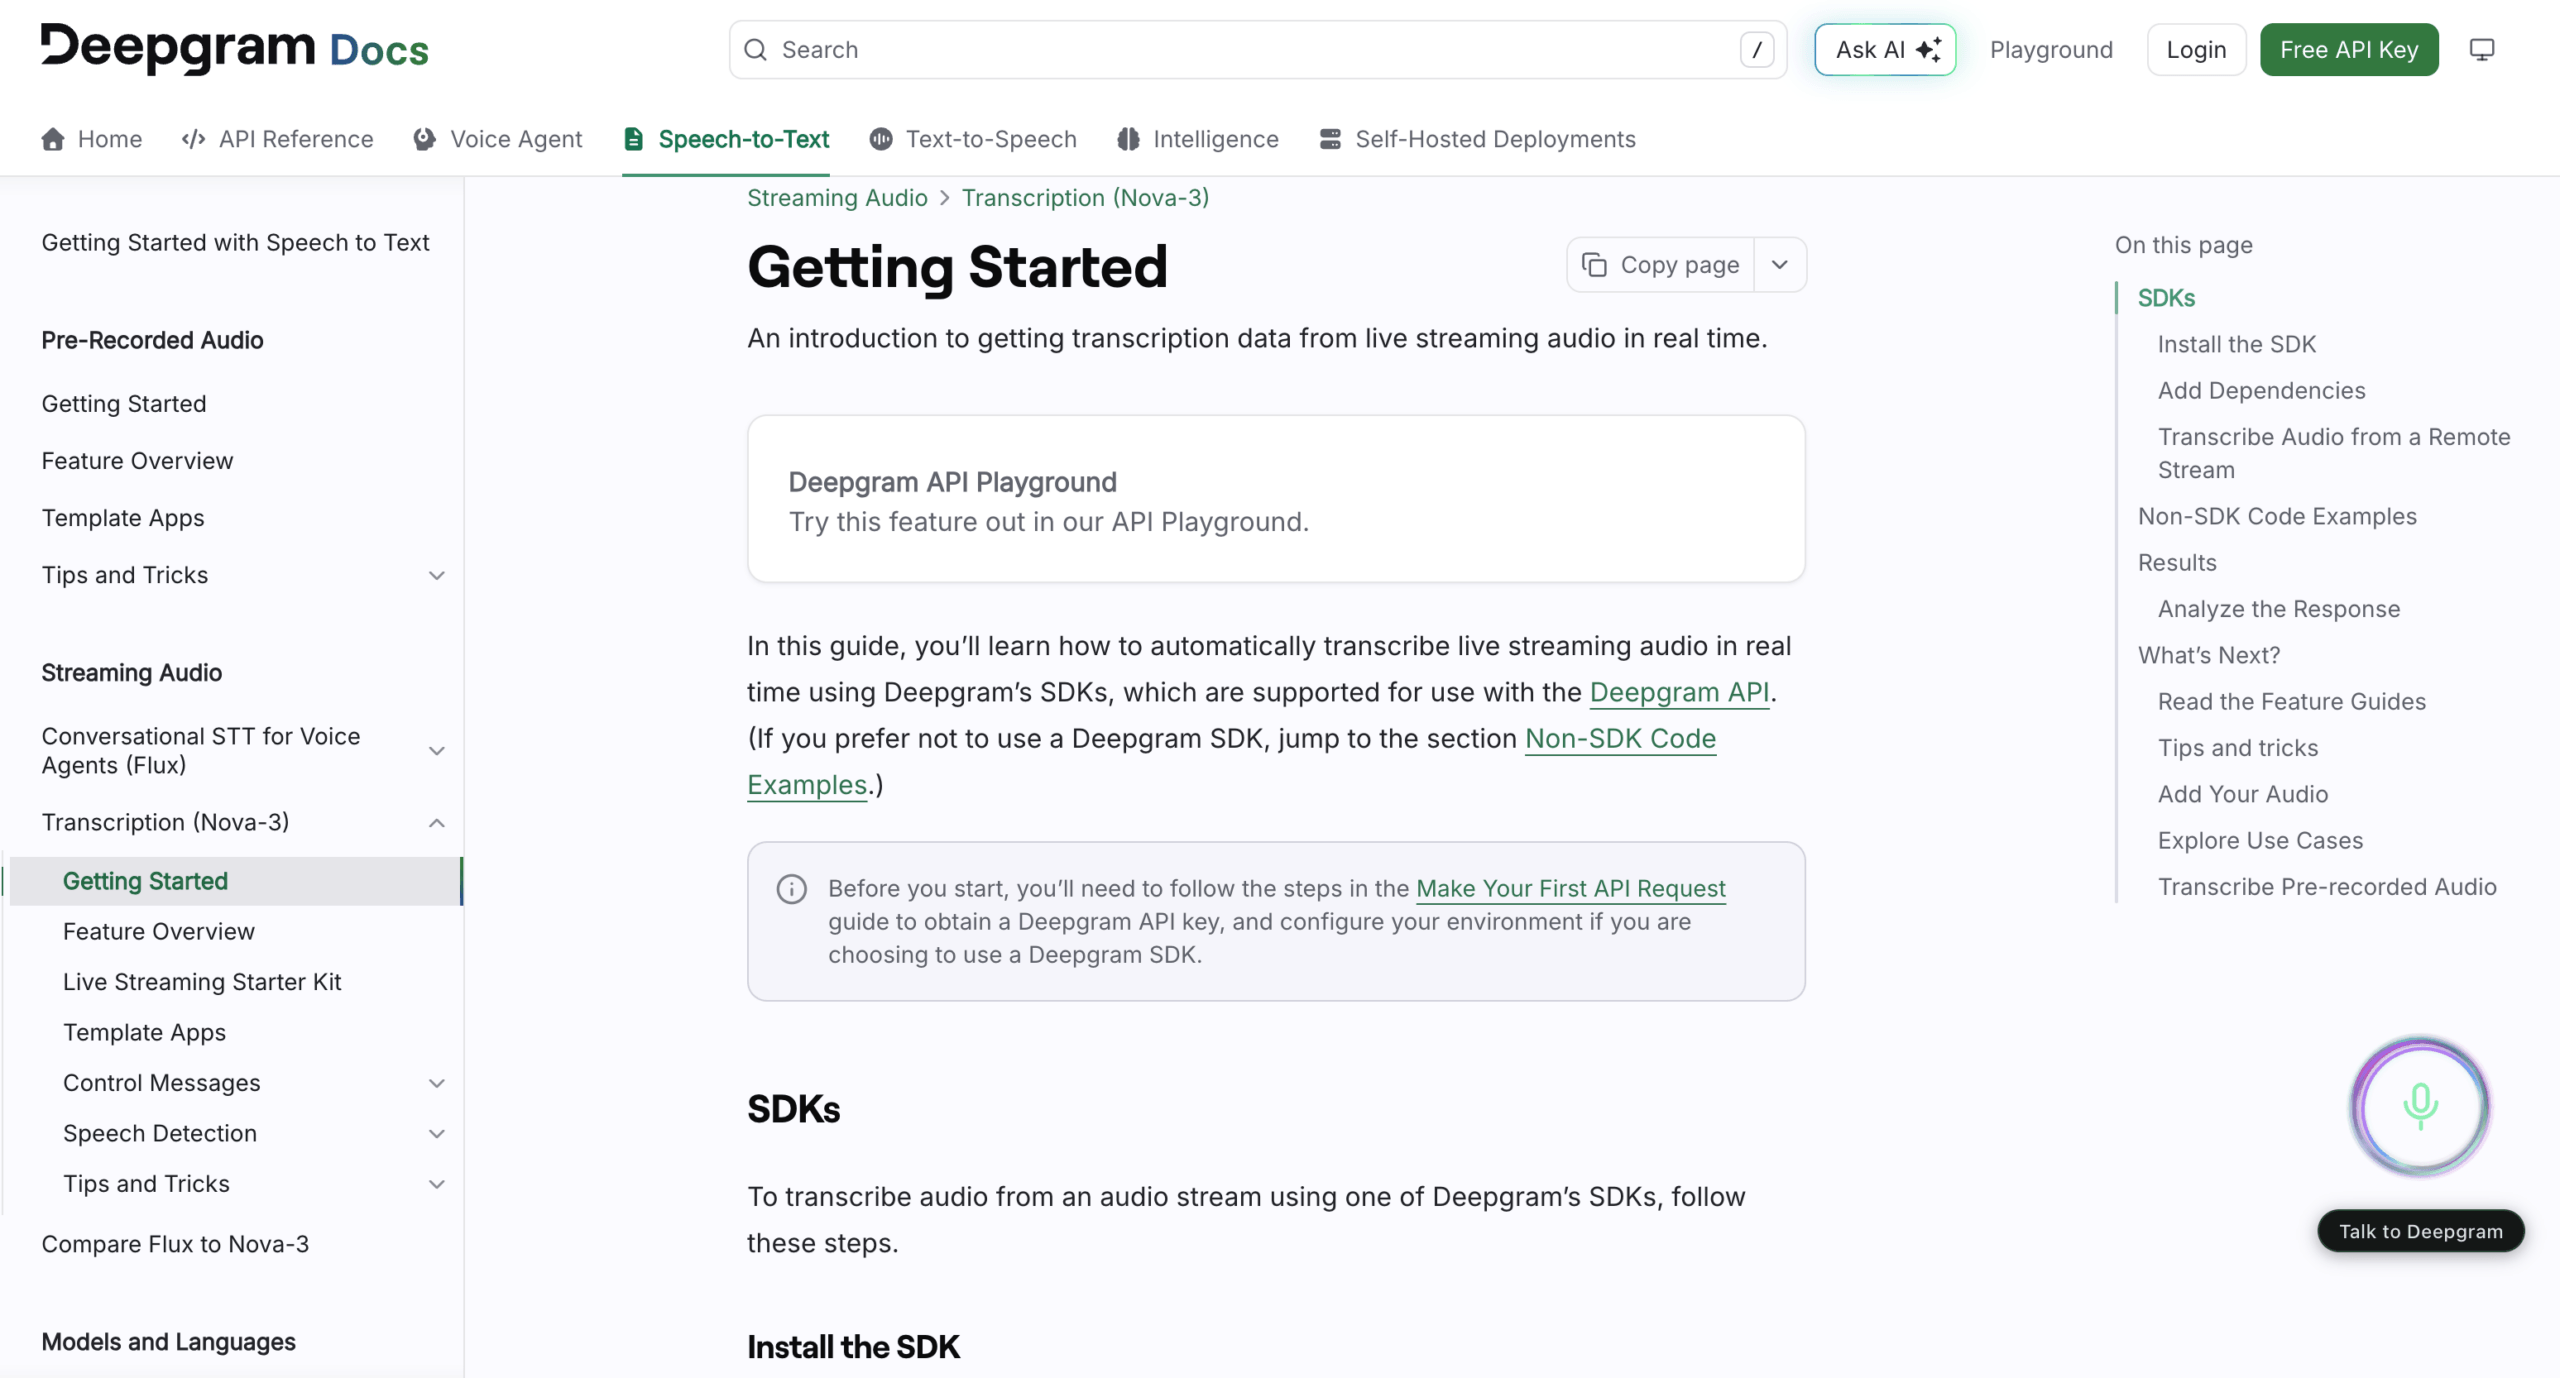
Изучите возможности потоковой передачи данных через Deepgram.
Использовать Дипграм Когда команде разработчиков продукта необходимо настроить поведение диалога, а не мириться с фиксированным интерфейсом субтитров. Команда по-прежнему отвечает за передачу звука, управление состоянием, частичное отображение текста, хранение данных, аутентификацию, разрешения, исправления и конечный пользовательский опыт.
Распространенная ошибка при реализации — сохранение только последнего ответа или ожидание только события завершения речи. В официальных рекомендациях поясняется, что длинная фраза может содержать несколько завершенных сегментов транскрипции до обнаруженного конца речи. Приложение должно корректно объединять заключительные сегменты.
Вариант 3: Используйте AssemblyAI, когда важны метки для транслируемых выступлений.
AssemblyAI Предоставляет потоковые модели с частичными и окончательными стенограммами, указанием конечных точек, подсказками по ключевым словам, временными метками слов и поддерживаемыми режимами диаризации речи говорящего. В документации также описываются события исправления речи говорящего: модель может исправлять ранее указанные метки говорящего по мере сбора дополнительных данных.
Такое поведение при внесении изменений имеет значение в интерфейсах, работающих в режиме реального времени. Если приложение слишком рано отображает “Speaker A” как постоянный элемент, последующие исправления могут никогда не попасть в сохраненную запись. Пользовательский интерфейс нуждается в продуманной стратегии для ожидающих изменений меток и правок.
Выбирать AssemblyAI Когда важны потоковая передача с учетом говорящего и управление на уровне приложения. Подтвердите точную модель, поддержку языков, поведение диаризации, медицинские опции и требования к данным для планируемого развертывания; функции различаются в зависимости от модели потоковой передачи.
Вариант 4: Использование Soniox для многоязычных потоковых API.
Сониокс Он объединяет транскрипцию и перевод в реальном времени через свой API WebSocket. Текущий интерфейс поддерживает подсказки языка, настройку контекста, диаризацию говорящих, конфигурацию перевода, временные метки на уровне токенов, уровень достоверности, финальность и информацию о языке.
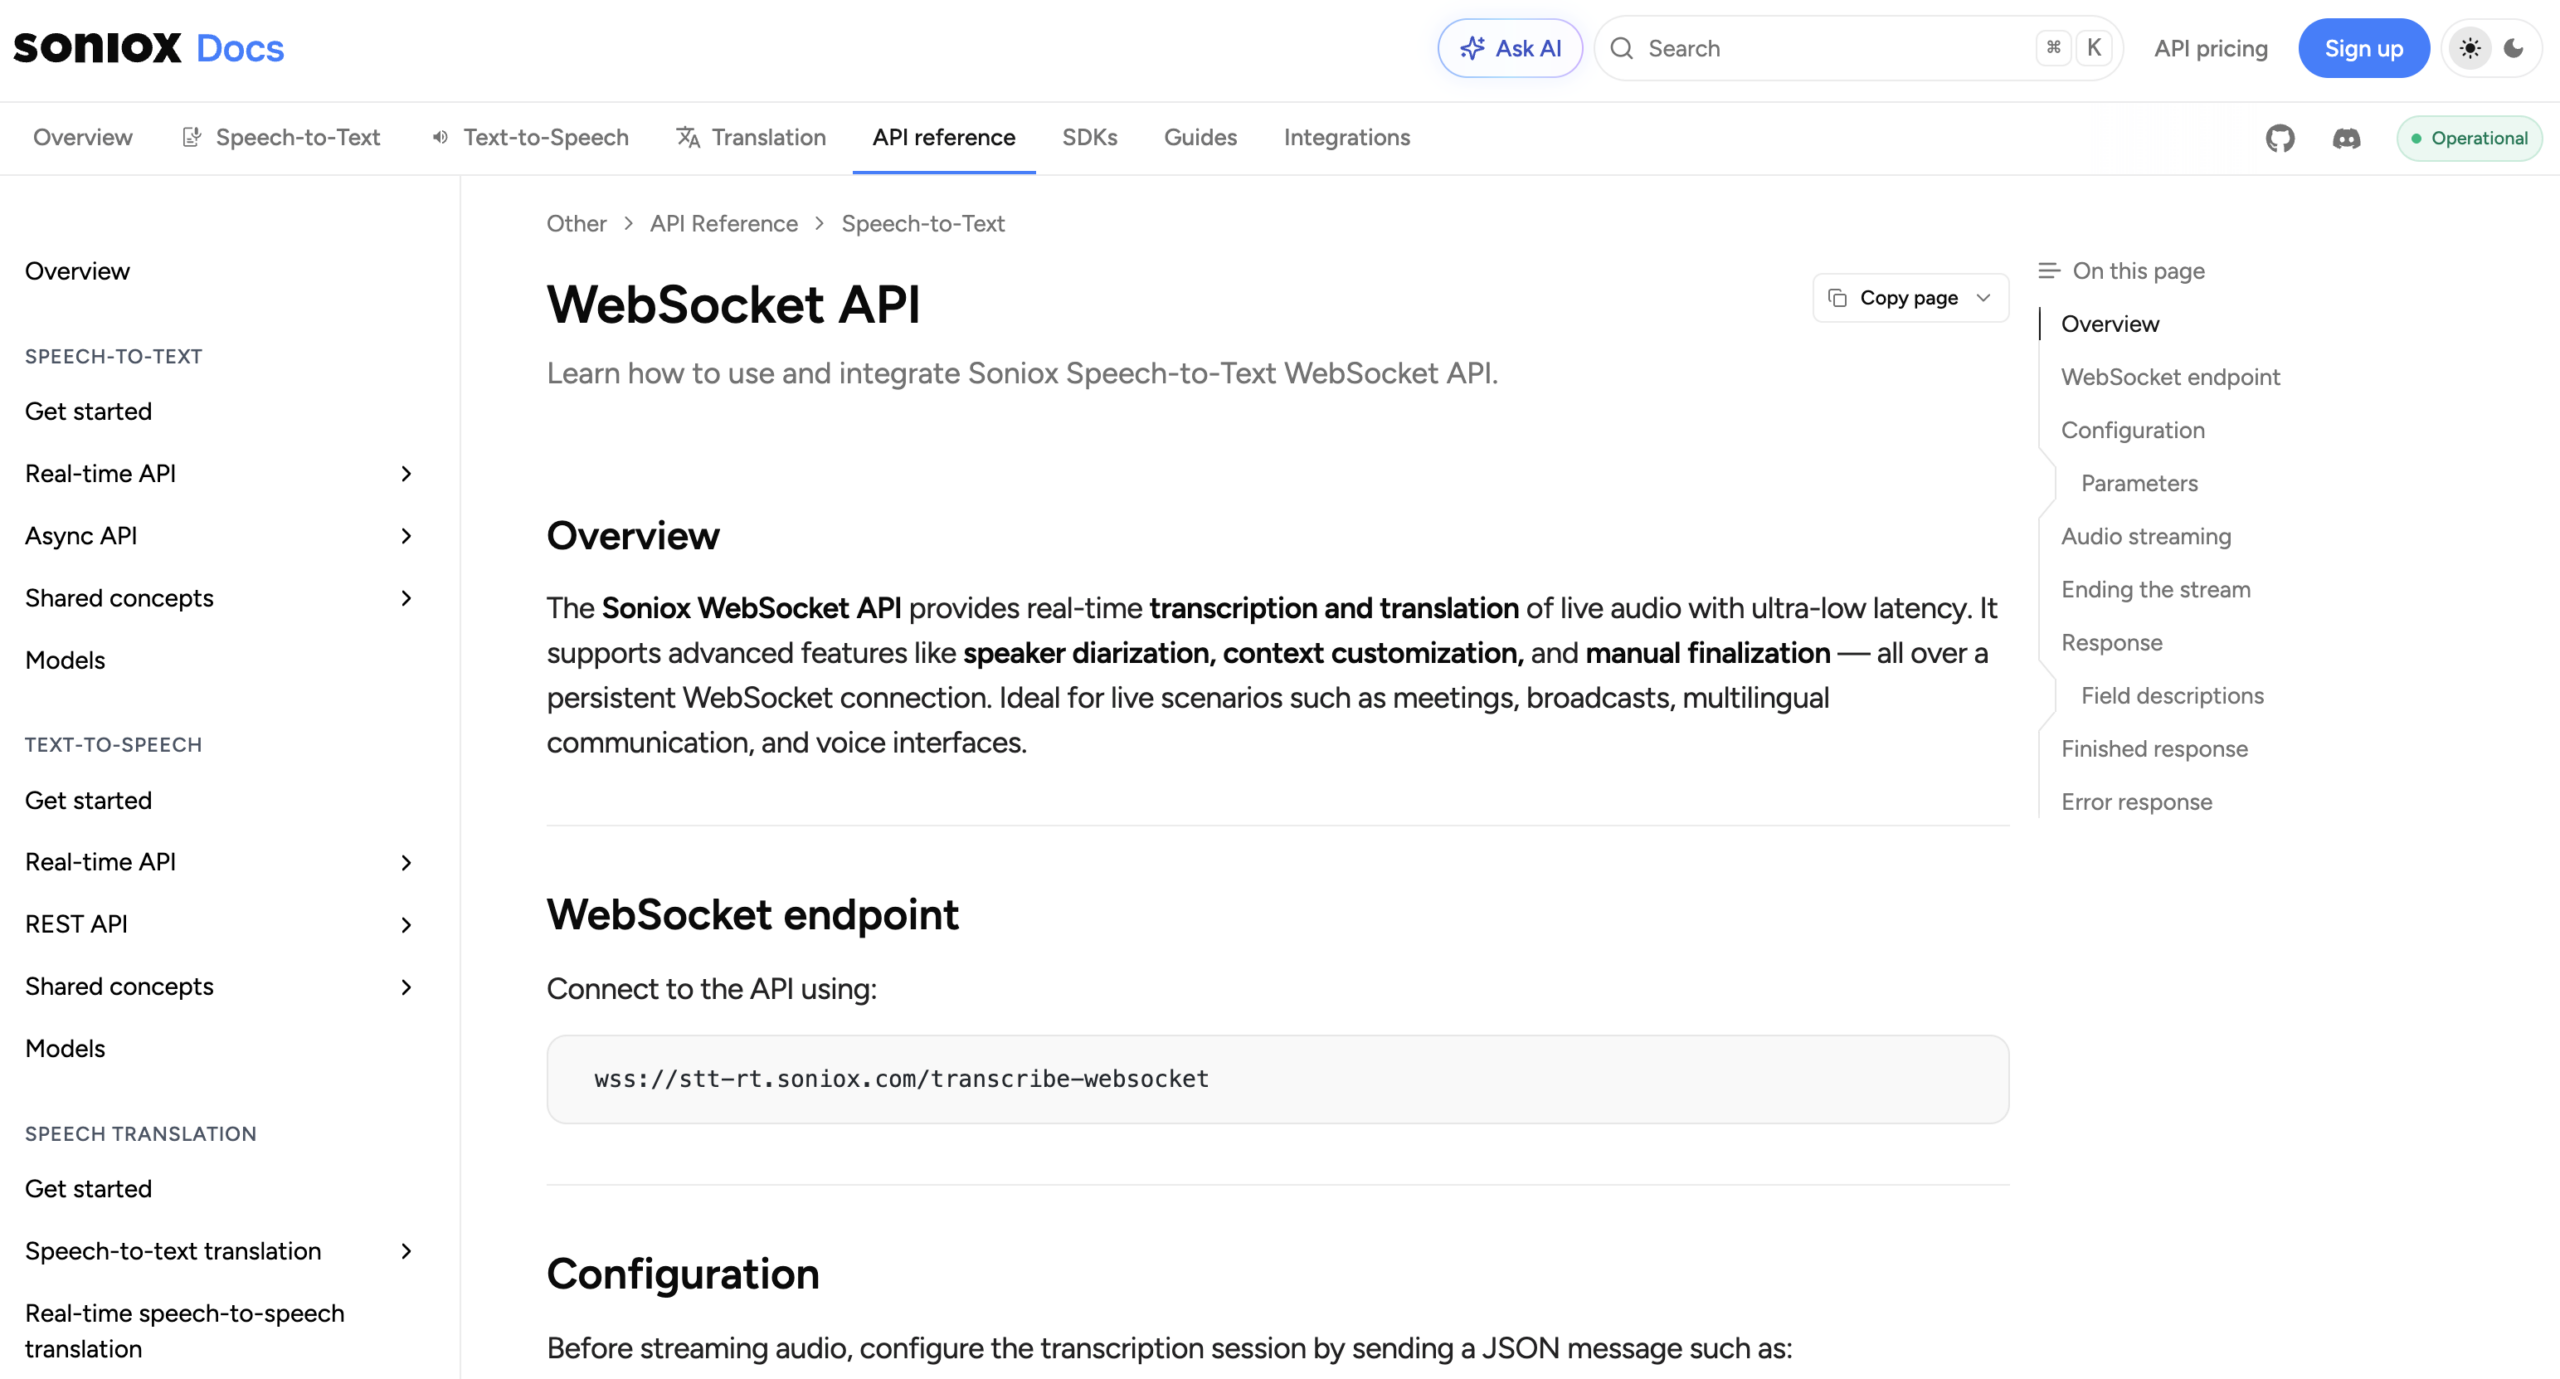
Ознакомьтесь с сервисом потокового вещания Soniox.
Это делает Сониокс актуально, когда разработчики хотят преобразование речи в текст в реальном времени и многоязычный вывод внутри собственного приложения. Конфигурация контекста может помочь с терминологией предметной области, но ее следует тестировать с использованием фиксированного скрипта терминологии, а не предполагать на основе названия функции.
Как и в случае с другими API, сервис возвращает базовые компоненты. Покупателю по-прежнему необходимо создавать доступ участников, вносить исправления, сохранять данные, экспортировать их, создавать сводки, осуществлять административный контроль, мониторинг, восстанавливать работоспособность при ошибках и оказывать поддержку.
Почему показателя частоты ошибок в словах недостаточно?
Показатель частоты ошибок в словах измеряет количество замен, удалений и вставок по сравнению с эталонной транскрипцией. Он полезен, но одно среднее значение может скрыть ошибки, которые имеют наибольшее значение.
Сравните эти две ошибки:
- “Мы можем осуществить доставку» Четверг”“ превращается в «Мы можем отправить» Вторник.”
- “Пожалуйста, откройте панель настроек”“ превращается в «Пожалуйста, откройте» панель настроек.”
Оба варианта могут учитываться одинаково, но первый меняет обязательство. Создайте реестр ошибок для:
- Имена и данные говорящего.
- Числа, валюты, даты и единицы измерения.
- Отрицания и условия.
- Названия продуктов и специализированная терминология.
- Переключение кодов и языковые изменения.
- Прерывания и самокоррекция.
- Пунктуация, изменяющая смысл.
Затем добавьте фактор времени. Правильно произнесенное слово после принятия решения может оказаться ошибочным с операционной точки зрения. Предварительная ошибка, исправленная позже, все же могла побудить голосового агента или участника к действию.
Право преобразование речи в текст в реальном времени Таким образом, оценка учитывает серьезность фактических ошибок, стабильность, своевременность реплик и манеру подачи информации, а не просто среднюю точность подбора слов.
Двухминутная запись правды
Используйте один источник записи, чтобы каждый кандидат получил идентичный звук. Не позволяйте каждому поставщику выбирать свою собственную демо-запись.
Сценарий
- “Здравствуйте, меня зовут Ниам О'Рурк, я из компании Aster-Q”.”
- “Рекомендуемый номер — BX-417, а не BX-471”.”
- “Выручка составила 15,05 млн трлн танзанийских шиллингов, что на 13,6 процента больше, чем в предыдущем году”.”
- “Не продлевайте договор, пока не будет подписано соглашение об уровне обслуживания”.”
- “Отправить пятнадцать — простите, пятьдесят — единиц в четверг”.”
- “API использует потоковую передачу WebSocket и конечную точку с интервалом в 300 миллисекунд”.”
- Сделайте паузу на 700 миллисекунд посреди условного предложения.
- Пусть второй человек прервет выступление, затем вернитесь к первому говорящему.
- Добавьте одно предложение на требуемом втором языке.
- Завершите тихим предложением, при этом должен быть слышен звук клавиатуры.
Лист захвата
| Измерение | Как это записать | Передайте условие для определения перед тестированием. |
|---|---|---|
| Время для первого сообщения | Начало аудиозаписи первой непустой гипотезы | Исходя из потребности пользователя в визуальной обратной связи. |
| Время для стабильного текста | Последнее произнесенное слово в заключительном неизменном тексте | Достаточно быстро, чтобы люди не вносили никаких изменений. |
| Задержка завершения хода | Завершение запланированного перехода к событию конечной точки или триггеру ответа | Не прерывает обычные паузы и не вызывает ощущения бездействия. |
| Количество правок | Количество видимых изменений гипотезы или изменений на уровне API | Интерфейс остается читаемым, а последующие действия ожидают завершения. |
| Критические фактические ошибки | Имена, цифры, отрицания, даты, единицы измерения и условия | В ходе пилотного проекта не было зафиксировано ни одной серьезной ошибки, не отмеченной как допущенная. |
| восстановление метки говорящего | Время и правильность после прерывания | Сохраненная стенограмма отражает исправленное указание авторства. |
| Завершение рабочего процесса | Завершение совещания для записи с возможностью поиска/экспорта или действия приложения | Соответствует оперативным срокам. |
Проведите десять испытаний, затем сообщите медианное значение, 95-й процентиль и наихудшие наблюдаемые результаты там, где это позволяет выборка. Один идеальный запуск не гарантирует надежности.
Семь типов отказов и первый способ их устранения
| Симптом | Вероятный слой | Первая полезная проверка |
|---|---|---|
| Текст появляется с задержкой после первого слова. | Захват, буферизация, кодирование, сеть или модель | Измерьте каждый скачок; уменьшите слишком большие аудиофрагменты. |
| Текст появляется быстро, но часто переписывается. | Промежуточное поведение гипотезы | Дождитесь окончательного подтверждения, прежде чем запускать действия; перепроектируйте предварительное отображение. |
| Система обрезает голоса тех, кто задумывается над происходящим. | Определение порогового значения конечной точки или обнаружение голосовой активности | Протестируйте более длительные паузы и настройте конечные точки там, где это возможно. |
| Система слишком долго ожидает после выполнения коротких команд. | Логика определения порогового значения конечной точки или логики переключения приложений | Протестируйте более низкий пороговый уровень или явно заданные параметры завершения хода. |
| Имена и коды постоянно дают сбой. | Акустическая неоднозначность и отсутствие контекста предметной области | Добавьте ключевые термины/контекст и улучшите качество микрофона. |
| Надписи на динамиках меняются после отображения. | Потоковая диаризация пересматривает кластеризацию. | Поддерживает ожидающие добавления меток и применяет события внесения изменений к записи. |
| Расшифровка происходит быстро, но после неё она становится непригодной для использования. | Отсутствует рабочий процесс продукта. | Добавьте функции исправления, хранения, поиска, управления правами доступа, экспорта и удаления — или выберите готовое приложение. |
Устранение неполадок преобразование речи в текст в реальном времени слева направо. Замена модели не исправит отключенный ввод, неправильную частоту дискретизации или пользовательский интерфейс, который сохраняет предварительный текст как окончательный.
Когда преобразование речи в текст не является конечной задачей
Транскрипция отвечает на вопрос: “Какие слова были распознаны?” Перевод отвечает на вопрос: “Что эти слова означают на другом языке?” Результат совещания также должен отвечать на вопрос: “Сможет ли другой участник понять, отреагировать и восстановить принятое решение позже?”
Если все говорят на одном языке и нуждаются в субтитрах, диктовке, поиске или аналитике, может быть достаточно специализированного API для транскрипции или продукта для транскрипции. Если участники используют разные языки, рабочий процесс должен включать дополнительные элементы управления:
- Исходный текст отображается рядом с переводом.
- Выбор языка или автоматическая обработка.
- Подготовка терминологии и контекста.
- Текст на целевом языке, используемый в ходе разговора.
- Возможность добавления голосового перевода при чтении непрактична.
- Записи и заметки, сохраняющие многоязычное обсуждение.
Вот где преобразование речи в текст в реальном времени становится одним из компонентов более крупного Transync AI скорее процесс работы, чем конечный продукт.
Часто задаваемые вопросы о преобразовании речи в текст в реальном времени
Что такое преобразование речи в текст в реальном времени?
Преобразование речи в текст в реальном времени Система преобразует потоковое аудио в предварительный и окончательный текст во время произнесения речи. Система может пересматривать первоначальные гипотезы по мере получения дополнительной информации, определения конца реплики, применения знаков препинания или улучшения идентификации говорящего.
Какая задержка считается задержкой в реальном времени?
Единого порогового значения не существует. Измеряйте время до появления первого текста, стабильного текста, завершения обработки и пригодности выходных данных рабочего процесса. Для оператора субтитров, голосового агента, участника совещания и рецензента после звонка допустимые задержки могут быть разными.
Почему текст в реальном времени постоянно меняется?
Системы распознавания речи в потоковом режиме публикуют предварительные гипотезы до того, как предложение будет полностью завершено. Позднее аудио может изменить наиболее вероятную формулировку, пунктуацию, язык или говорящего. Приложения должны различать предварительные результаты и окончательный текст.
Является ли преобразование речи в текст в реальном времени тем же самым, что и перевод в реальном времени?
Нет. Функция преобразования речи в текст распознает произнесенные слова на языке оригинала. Перевод в реальном времени добавляет еще одно языковое преобразование и может также включать переведенный голос. Transync AI Объединяет функции распознавания и перевода для многоязычных разговоров.
Какой API лучше всего подходит для преобразования речи в текст в реальном времени?
Единого победителя не существует. Дипграм предоставляет подробные средства управления конечными точками и состоянием результатов., AssemblyAI предлагает поддержку потоковой диаризации и редактирования, а также Сониокс Объединяет возможности многоязычной транскрипции и перевода. Протестируйте каждый вариант с идентичным аудиофайлом и точными требованиями к продукту.
Может ли функция преобразования речи в текст в реальном времени идентифицировать говорящего?
Некоторые модели поддерживают диаризацию или многоканальный ввод, но метки могут быть предварительными и изменяться по мере поступления новых аудиоданных. Проверьте наличие прерываний, похожих голосов, смену устройств и исправление сохраненных меток.
Что следует проверить в первую очередь компании?
Начните с фактического аудиоряда и двухминутного сценария, содержащего имена, числа, отрицания, исправления, паузы, прерывания, терминологию и необходимые языки. Измерьте время на всех четырех часах и проверьте сохраненную запись.
Окончательный вердикт
Самый быстрый преобразование речи в текст в реальном времени Система не обязательно та, которая отображает первое слово раньше всех. Надежная система балансирует четыре тактовых генератора:
первый текст → стабильный текст → завершенный ход → пригодная для использования запись
Выбирайте потоковый API, если разработчикам необходимо контролировать конечные точки, частичные результаты, правки докладчиков и поведение приложения. Выбирайте готовый продукт для проведения совещаний, если команде нужен полный цикл от аудио до субтитров, перевода, записей и заметок без необходимости создания собственной инфраструктуры.
Самое важное — протестируйте реальные входные данные и реальные последствия. Измерьте количество появляющихся слов, количество изменяющихся слов, количество завершающихся поворотов и то, насколько достоверным окажется полученный результат.