Realtime spraak-naar-tekst is meer dan alleen snelle ondertiteling. Let op 4 verborgen klokken, revisies, sprekerverwerking en geschiktheid voor meertalige vergaderingen voordat u een keuze maakt.
Spraak-naar-tekst in realtime kan er in een demo uitstekend uitzien, maar in een echt gesprek toch mislukken. De eerste woorden kunnen binnen 300 milliseconden verschijnen, terwijl de zin nog twee seconden lang kan veranderen. Een sprekerlabel kan verschijnen en vervolgens worden aangepast. Een gepolijst transcript kan snel klaar zijn, maar de ontkenning die de beslissing veranderde, kan ontbreken.
Daarom is "Hoe snel gaat het?" niet de juiste eerste vraag. Een nuttige evaluatie vereist vier tijdsmetingen: tijd tot de eerste tekst, tijd tot stabiele tekst, tijd tot een voltooide beurt en tijd tot een bruikbare registratie. Elke tijdsmeting beantwoordt aan een andere operationele behoefte.
Dit artikel behandelt Spraak-naar-tekst in realtime Het wordt gezien als een meetbare pipeline in plaats van een visueel effect. Het vergelijkt gespecialiseerde streaming-API's met een kant-en-klaar meertalig vergaderproduct, biedt een herhaalbaar testscript en legt uit wanneer transcriptie alleen onvoldoende is omdat deelnemers vertaling, spraakuitvoer of notities nodig hebben.
Het antwoord in 60 seconden
Spraak-naar-tekst in realtime Zet een live audiostream om in tekst terwijl de spreker nog spreekt. De weergegeven tekst is vaak voorlopig. De eerste woorden kunnen worden aangepast naarmate het model meer context ontvangt, een pauze detecteert, een spreker identificeert, leestekens toevoegt of een uitspraak afmaakt.
De vier klokken zijn:
- Latentie bij eerste tekst: Hoe lang duurt het voordat er een hypothese verschijnt?
- Stabiliteitslatentie: Hoe lang duurt het nog voordat de woorden niet meer veranderen?
- Vertraging bij het voltooien van een beurt: Hoe lang duurt het voordat het systeem besluit dat een spreekbeurt of uitspraak is afgelopen?
- Werkstroomlatentie: Hoe lang duurt het voordat het transcript bruikbaar is voor zoekopdrachten, notities, acties, vertalingen of een reactie op een aanvraag?
Een spraakassistent kan prioriteit geven aan het moment waarop een gesprek wordt afgerond, omdat deze moet bepalen wanneer er antwoord moet worden gegeven. Toegankelijke ondertiteling kan prioriteit geven aan snelle, leesbare gedeeltelijke tekst. Een vergaderingsverslag kan een iets tragere weergave tolereren als namen, nummers en sprekeraanduiding betrouwbaarder worden. Een meertalige vergadering voegt na de herkenning nog een extra stap toe: de vertaling moet snel genoeg binnenkomen zodat iemand kan reageren.
Realtime spraak-naar-tekst is een hypothese die nog in ontwikkeling is.
Een live transcriptie wordt niet in één stap gemaakt:
microfoon of systeemaudio → codering en transport → spraakdetectie → voorlopige herkenning → revisie → finalisering → sprekerlabeling en -opmaak → applicatieactie
Het scherm toont meestal alleen het middelste gedeelte. Dat creëert een veelvoorkomende illusie: omdat de tekst direct verschijnt, gaan gebruikers ervan uit dat het resultaat klaar is. In werkelijkheid kan de engine nog steeds bezig zijn met het heroverwegen van woordgrenzen, leestekens, taal of de identiteit van de spreker.
Specialistische API's maken dit onderscheid expliciet. Deepgram Het systeem retourneert tussentijdse en definitieve resultaten afzonderlijk. De documentatie legt uit dat de voorlopige tekst kan veranderen, terwijl de definitieve segmenten moeten worden samengevoegd om een volledige spraakuiting te reconstrueren. Een apart signaal voor het einde van de spraak geeft aan dat het systeem een eindpunt heeft gedetecteerd, zoals een pauze.
Soniox Geeft via een permanente streamingverbinding de definitieve en niet-definitieve tokens, tijdstempels, betrouwbaarheid, taalinformatie, optionele sprekerlabels en de voortgang van de verwerking weer. AssemblyAI Het biedt eveneens gedeeltelijke en definitieve transcripties, eindmarkering, tijdstempels op woordniveau, prompts voor sleuteltermen en streaming sprekerdiarisatie in ondersteunde modellen.
Die controlemechanismen zijn nuttig voor ontwikkelaars. Ze laten ook zien waarom een eindgebruiker niet zou moeten oordelen. Spraak-naar-tekst in realtime aan de hand van de eerste zichtbare lijn alleen al.
Klok 1: Tijd tot eerste bericht
De eerste klok begint te lopen wanneer spraak het systeem bereikt en stopt wanneer de eerste niet-lege hypothese zichtbaar of beschikbaar komt voor de applicatie.
Deze meting omvat meer dan alleen modelinferentie:
- Microfoon- of vergaderingsaudio-opname.
- Buffergrootte en audiochunking.
- Hersampling of codering.
- Netwerktransport.
- Serververwerking.
- Retourtransport.
- Interfaceweergave.
Meeteenheid Spraak-naar-tekst in realtime De gegevens worden rechtstreeks van het apparaat van de gebruiker verkregen, niet van een API-dashboard. Een serverwaarde van een leverancier kan vertragingen als gevolg van audiobuffering, netwerkverkeer aan de clientzijde, browserrendering en het vergaderplatform zelf uitsluiten.
Snelle eerste tekst is waardevol wanneer gebruikers de bevestiging nodig hebben dat het systeem luistert. Het is minder nuttig wanneer de interface hen aanmoedigt om te reageren op onzekere woorden. Een goed ontwerp van de ondertiteling onderscheidt voorlopige tekst visueel zonder deze onleesbaar te maken.
Hoe test je de eerste klok?
Neem dezelfde audio en het scherm op met 60 beelden per seconde. Klap één keer in je handen en zeg dan: "De verlenging is niet goedgekeurd." Markeer het beeld waar de golfvorm of het geklap de invoer bereikt en het beeld waar de eerste tekst verschijnt. Herhaal dit tien keer en rapporteer het gemiddelde en het langzaamste resultaat, niet de snelste poging.
Test Spraak-naar-tekst in realtime Onder normale wifi-omstandigheden, een overbelast netwerk, een laptop met ruisonderdrukking en de daadwerkelijke headset of kamermicrofoon, is de snelheid waarmee eerste berichten worden verzonden, die onder normale belasting verdwijnt, geen betrouwbaar productkenmerk.
Klok 2: Tijd om de tekst stabiel te maken
De tweede klok stopt wanneer een stuk tekst niet meer verandert. Dit is de klok die in de meeste marketingdemonstraties verborgen wordt gehouden.
Neem de volgende gesproken zin in overweging:
“"Verzend vijftien—sorry, vijftig—eenheden op donderdag."”
De weergave kan doorlopen via "verzending 15", vervolgens "verzending 50", en dan een correctie met leestekens. De eerste versie arriveerde snel, maar alleen de definitieve versie kan veilig in een bestelling worden opgenomen.
Stabiliteit is belangrijk omdat downstream-systemen te vroeg kunnen reageren. Een live-samenvatting, verkoopassistent, compliance-trigger, vertaallaag of spraakagent kan een voorlopige fout overnemen. In een Spraak-naar-tekst in realtime In de workflow zouden ontwikkelaars de finaliteitssignalen van de engine moeten verwerken in plaats van elke gedeeltelijke update als een voltooide instructie te beschouwen.
Meet de revisieafstand, niet alleen de vertraging.
Voor elke testzin, registreer het volgende:
- Aantal voorlopige versies.
- Aantal woorden dat is vervangen of verwijderd.
- De tijd tussen het laatst gesproken woord en de stabiele tekst.
- Of het uiteindelijk opgeslagen transcript overeenkomt met de stabiele weergave.
- Of er vóór de stabiliteit een vervolgactie werd geactiveerd.
Een iets langzamere Spraak-naar-tekst in realtime Een systeem kan veiliger zijn als het minder ingrijpend wordt herzien. De juiste afweging hangt af van of gebruikers aan het lezen, dicteren, software aansturen of onderhandelen zijn.
Klok 3: Tijd tot een voltooide beurt
Woorden kunnen definitief zijn, terwijl de spreekbeurt dat niet is. Iemand kan even pauzeren om na te denken, adem te halen, naar een figuur te zoeken of een onderbreking af te wachten. Als het systeem de spreekbeurt te vroeg beëindigt, kan een spraakassistent de gebruiker onderbreken. Als het te lang wacht, voelt het gesprek onresponsief aan.
Het einde van een gesprek wordt doorgaans aangegeven door stilte of spraakactiviteit. Deepgram documenteert configureerbare eindpuntinstellingen en aparte is_final En speech_final De richtlijnen geven aan dat korte drempelwaarden geschikt kunnen zijn voor korte antwoorden van chatbots, terwijl langere gesprekspauzes honderden milliseconden kunnen duren voordat een beurt als voltooid wordt beschouwd.
Er bestaat geen universele instelling die voor elke spreker werkt. Een snel gesproken tekst in een callcenter, een aarzelend medisch dossier, een college en een tweetalige onderhandeling hebben verschillende pauzepatronen. Het moment waarop iemand zijn of haar beurt afsluit, is daarom cruciaal. Spraak-naar-tekst in realtime een meting, niet zomaar een API-instelling.
Voer de aarzelingstest uit.
Gebruik deze vier regels:
- “Mijn rekeningnummer is … 4172.”
- “Ik ga akkoord… als de leverdatum vrijdag blijft.”
- “De dosering is vijftien – nee, vijftig – milligram.”
- “'Ana, kun je—' waarna een tweede spreker onderbrak.
Tel het aantal valse wendingen, late eindpunten, onderbrekingen en afgekapte woorden. Pas de drempelwaarde voor eindpunten alleen aan als de applicatie deze weergeeft. Als het product een voltooide app is, observeer dan het gedrag en bepaal of het geschikt is voor de taak.
Deze klok bevindt zich waar Spraak-naar-tekst in realtime Het wordt meer conversatietechniek dan gewone transcriptie.
Klok 4: Tijd voor een bruikbare registratie
De vierde klok is de belangrijkste voor teams. Deze eindigt wanneer de output de volgende actie kan ondersteunen.
“"Bruikbaar" kan betekenen:
- De ondertiteling blijft tijdens de sessie leesbaar.
- De sprekers zijn herkenbaar.
- Namen, getallen en terminologie kunnen worden gecorrigeerd.
- Een volledig transcript kan worden gekopieerd of geëxporteerd.
- Het dossier is doorzoekbaar en vereist toegangsrechten.
- Er wordt een samenvatting en een aantal actiepunten gegenereerd.
- De brontekst en de vertaalde tekst blijven aan elkaar gekoppeld.
- Behoud en verwijdering zijn bekend.
Een systeem kan de eerste drie rondes winnen en de vierde verliezen. Ruwe streaming JSON is geen vergaderingsverslag. Snel verdwijnende ondertitels zijn geen bewijs. Een mooie samenvatting zonder traceerbaar transcript kan herkenningsfouten verbergen. Dit is waarom Spraak-naar-tekst in realtime Bij de inkoop moet zowel de voltooide workflow als het streamingmodel worden gemeten.
Spraak-naar-tekst in realtime De evaluatie moet daarom plaatsvinden op het moment van gebruik, niet op het moment van creatie. Vraag de deelnemer, beoordelaar, ontwikkelaar en beheerder om dezelfde sessie vanuit hun eigen perspectief te testen.
Vier routes vergeleken aan de hand van de vier klokken
| Product | Producttype | Eerste tekst | Stabiliteits- en finaliteitscontroles | Sprekerafhandeling | Meertalige rol | Werkstroom voor bruikbare records | Beste pasvorm |
|---|---|---|---|---|---|---|---|
| Transync AI | Kant-en-klare app voor het vertalen van vergaderingen | Live tweetalige weergave | Beheerd door het product zelf in plaats van beschikbaar gesteld als API-parameters. | Onderscheidt automatisch het geselecteerde taalpaar; beoordeling in originele en vertaalde tekst. | 60 talen, tweetalige ondertitels, vertaalde stemmen | Vertalingsverslag, transcriptie en samenvatting van de AI-vergadering | Individuen en teams die live communicatie in meerdere talen nodig hebben zonder een app te hoeven ontwikkelen. |
| Deepgram | Streaming spraak-naar-tekst API | Tussentijdse resultaten kunnen worden ingeschakeld | Geeft inzicht in tussentijdse/eindresultaten, eindpunten, gebeurtenissen aan het einde van de spraak, bedieningselementen aan het einde van de uiting en handmatige finalisatie. | Diarisatie- en multikanaalopties zijn afhankelijk van de configuratie/het model. | Taal- en modelopties voor streaming; vertaling is een aparte workflowbeslissing. | De klant moet de opslag, bewerking, machtigingen, samenvattingen en gebruikersinterface bouwen. | Ontwikkelaars die spraakassistenten, ondertiteling, gespreksanalyse of aangepaste transcriptieproducten bouwen |
| AssemblyAI | Streaming spraak-naar-tekst API | Gedeeltelijke transcripties worden via een streamingverbinding geretourneerd. | Intelligente eindpuntbepaling en onveranderlijke, definitieve transcripten; modelspecifiek gedrag is van toepassing. | Streaming van dialoogopnames en sprekersrevisies zijn beschikbaar in ondersteunde modellen. | Het meertalige streamingmodel ondersteunt een gepubliceerde set talen. | De klant bouwt de uiteindelijke applicatie en registreert de levenscyclus. | Productteams die behoefte hebben aan streamingherkenning met diarisatie en downstream-intelligentie. |
| Soniox | Realtime spraak-AI-API | Niet-definitieve tokenstroom met lage latentie | Vlaggen voor het laatste token, handmatige finalisatie, tijdstempels van het token en voortgang van de verwerking | Optionele luidsprekerdiarisatie | Realtime meertalige transcriptie en vertaling via API-configuratie | De klant bouwt de interface, persistentie, beoordeling en governance. | Ontwikkelaars die meertalige vergaderingen, uitzendingen, assistenten of spraakinterfaces bouwen. |
De mogelijkheden zijn gecontroleerd aan de hand van de officiële productdocumentatie op 3 oktober 2026. Modellen, talen, beperkingen en prijzen kunnen wijzigen.
De tabel wijst niet één universele winnaar aan. Hij onderscheidt twee aankoopbeslissingen: een product bouwen rond een streaming-API of een kant-en-klare workflow gebruiken. De beste Spraak-naar-tekst in realtime De route hangt af van wie verantwoordelijk is voor audio-opname, interfaceontwerp, correcties, opslag en ondersteuning.
Route 1: Gebruik Transync AI wanneer spraak meerdere talen moet overbruggen.
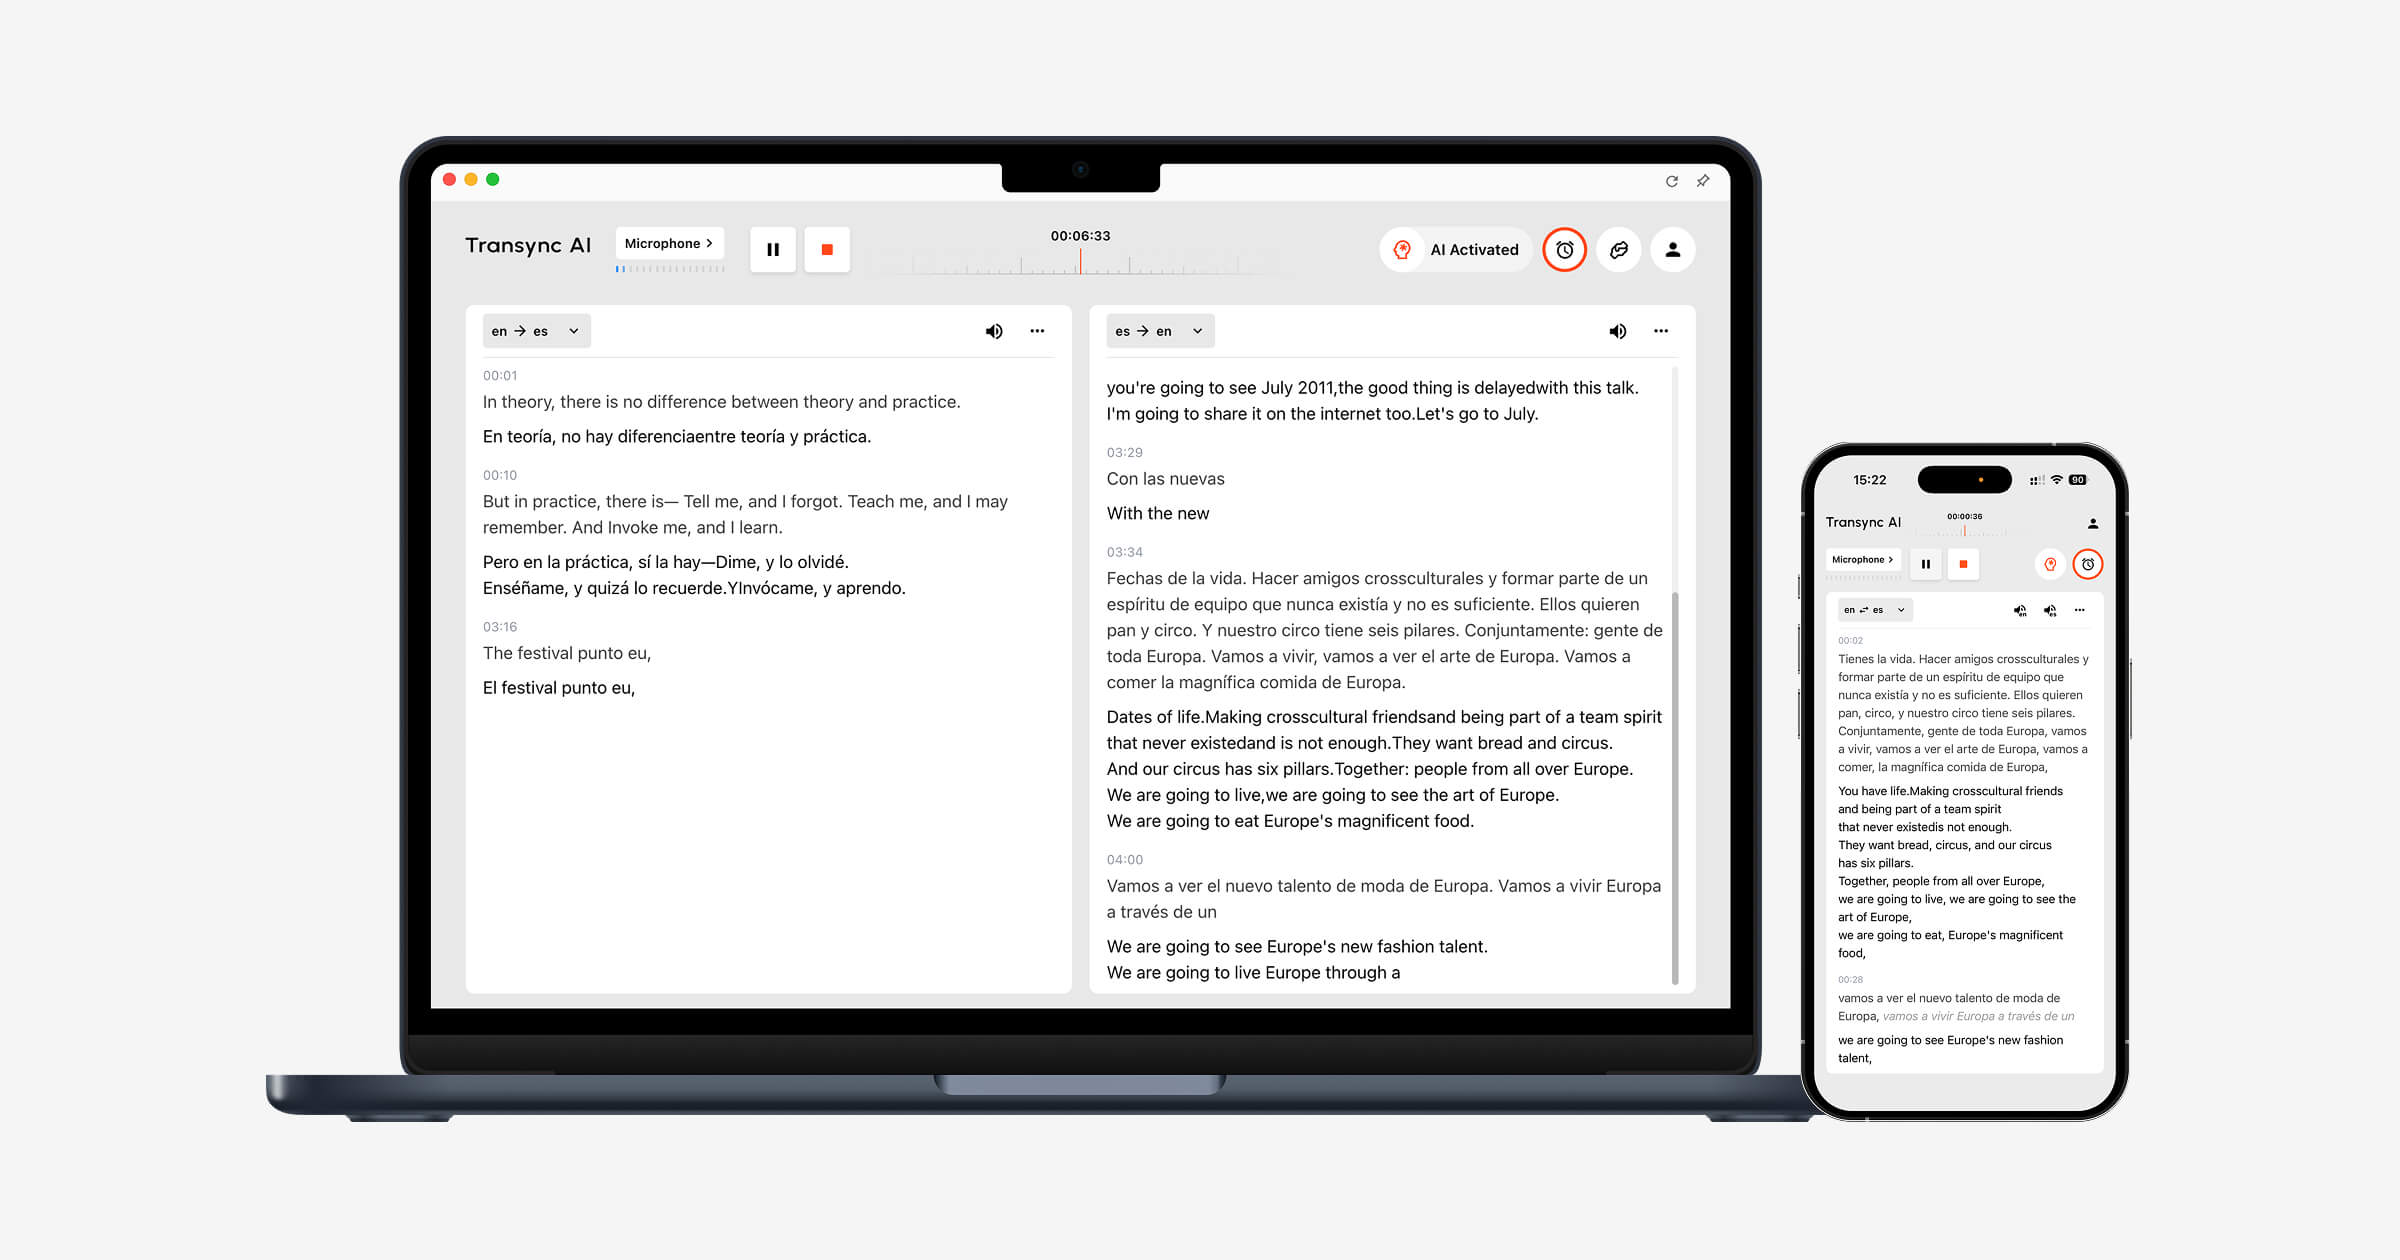
Transync AI Het wordt niet verkocht als een algemene spraak-naar-tekst-API. Het is een gebruiksklaar product voor vergaderingen en gesprekken dat spraakherkenning combineert met vertaling. realtime vertaalworkflow Het programma ondersteunt 60 talen en toont de originele spraak naast de vertaalde tekst, waardoor gebruikers herkenningsfouten van vertaalfouten kunnen onderscheiden.
Voor online gesprekken is het live vergadering vertaling Kan samenwerken met verschillende vergaderomgevingen via de geselecteerde microfoon- of computeraudioverbinding. Picture-in-Picture ondertitels Houd de tweetalige tekst zichtbaar boven de ondersteunde applicaties in plaats van de gebruiker te dwingen een apart tabblad met de transcriptie te bekijken.
Voor een telefoongesprek, Trefwoorden en context Namen, afkortingen, producttermen en achtergrondinformatie kunnen worden voorbereid. Na de sessie bewaart het transcript de originele en vertaalde tekst. AI-vergadernotities Kan samenvattingen en actiepunten genereren. De huidige transcriptiehandleiding vermeldt dat vergaderingssamenvattingen in 55 talen kunnen worden gegenereerd.
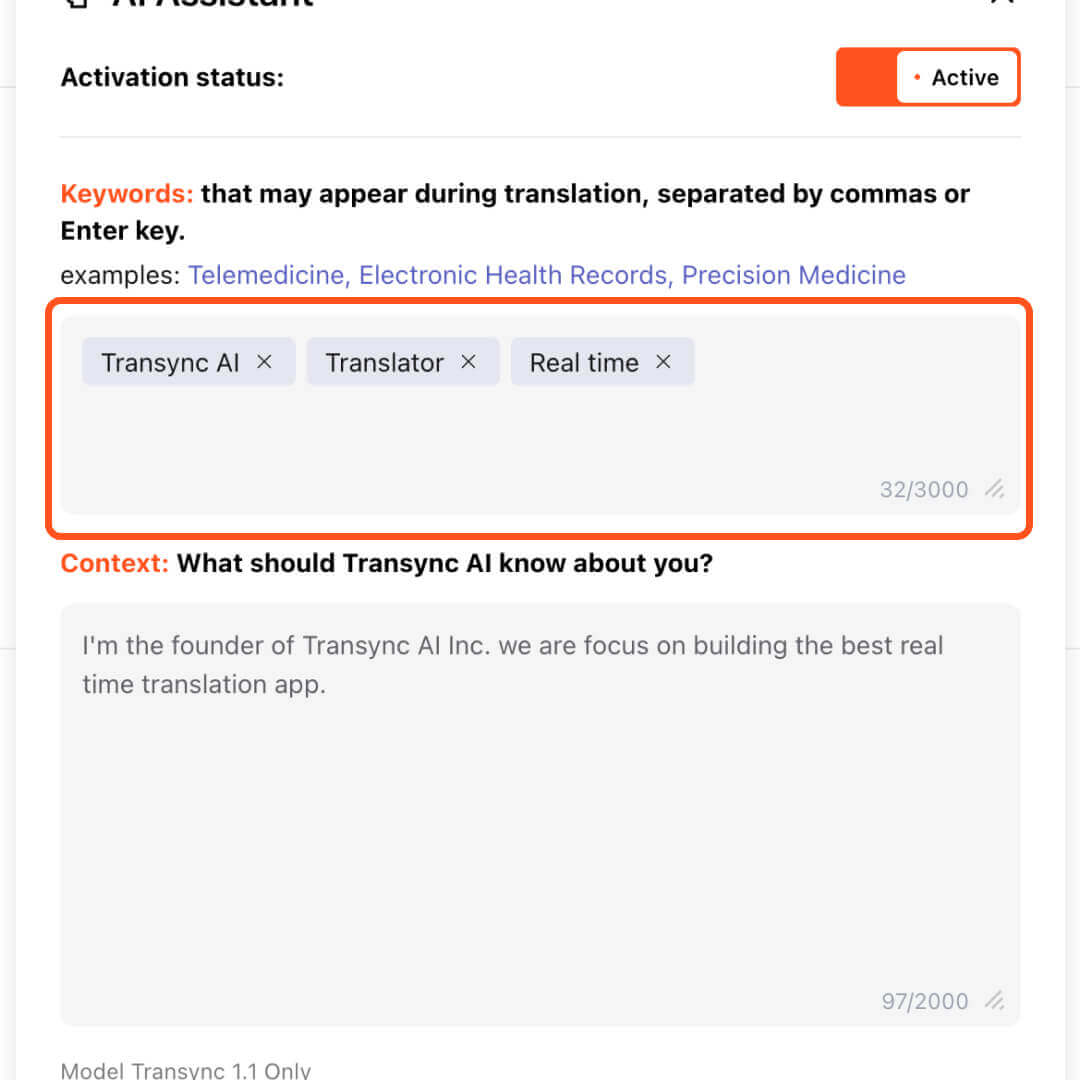
De Transync AI-interface toont het activeringspaneel van de AI-assistent met de trefwoorden 'Transync AI', 'Vertaler' en 'Realtime', waarmee wordt uitgelegd hoe aangepaste trefwoorden kunnen worden ingevoerd voor nauwkeurige vertalingen.
Kiezen Transync AI Kies een streaming-API wanneer het bedrijfsdoel is om communicatie in verschillende talen te begrijpen en erop te reageren. Kies in plaats daarvan voor een streaming-API wanneer het team een eigen spraakagent, een platform voor gespreksanalyse, een toegankelijkheidsproduct of een geïntegreerde transcriptie-interface ontwikkelt.
De beperking is belangrijk: Transync AI Dit is geen generieke offline dicteerengine of STT-eindpunt voor ontwikkelaars. Audioroutering, netwerkkwaliteit, taalcombinaties, microfoons en levering op afstand moeten worden getest vóór een belangrijke vergadering.
Route 2: Gebruik Deepgram wanneer de timing van de bochten onderdeel is van het product.
Deepgram Dit is met name leerzaam voor ontwikkelaars omdat de documentatie tussentijdse resultaten, voltooide segmenten, gedetecteerde spraakeindpunten en gebeurtenissen die het einde van een uiting aangeven, van elkaar scheidt. Dankzij deze scheiding kan een applicatie bepalen wanneer tekst moet worden weergegeven, stabiele tekst moet worden toegevoegd of een reactie moet worden geactiveerd.
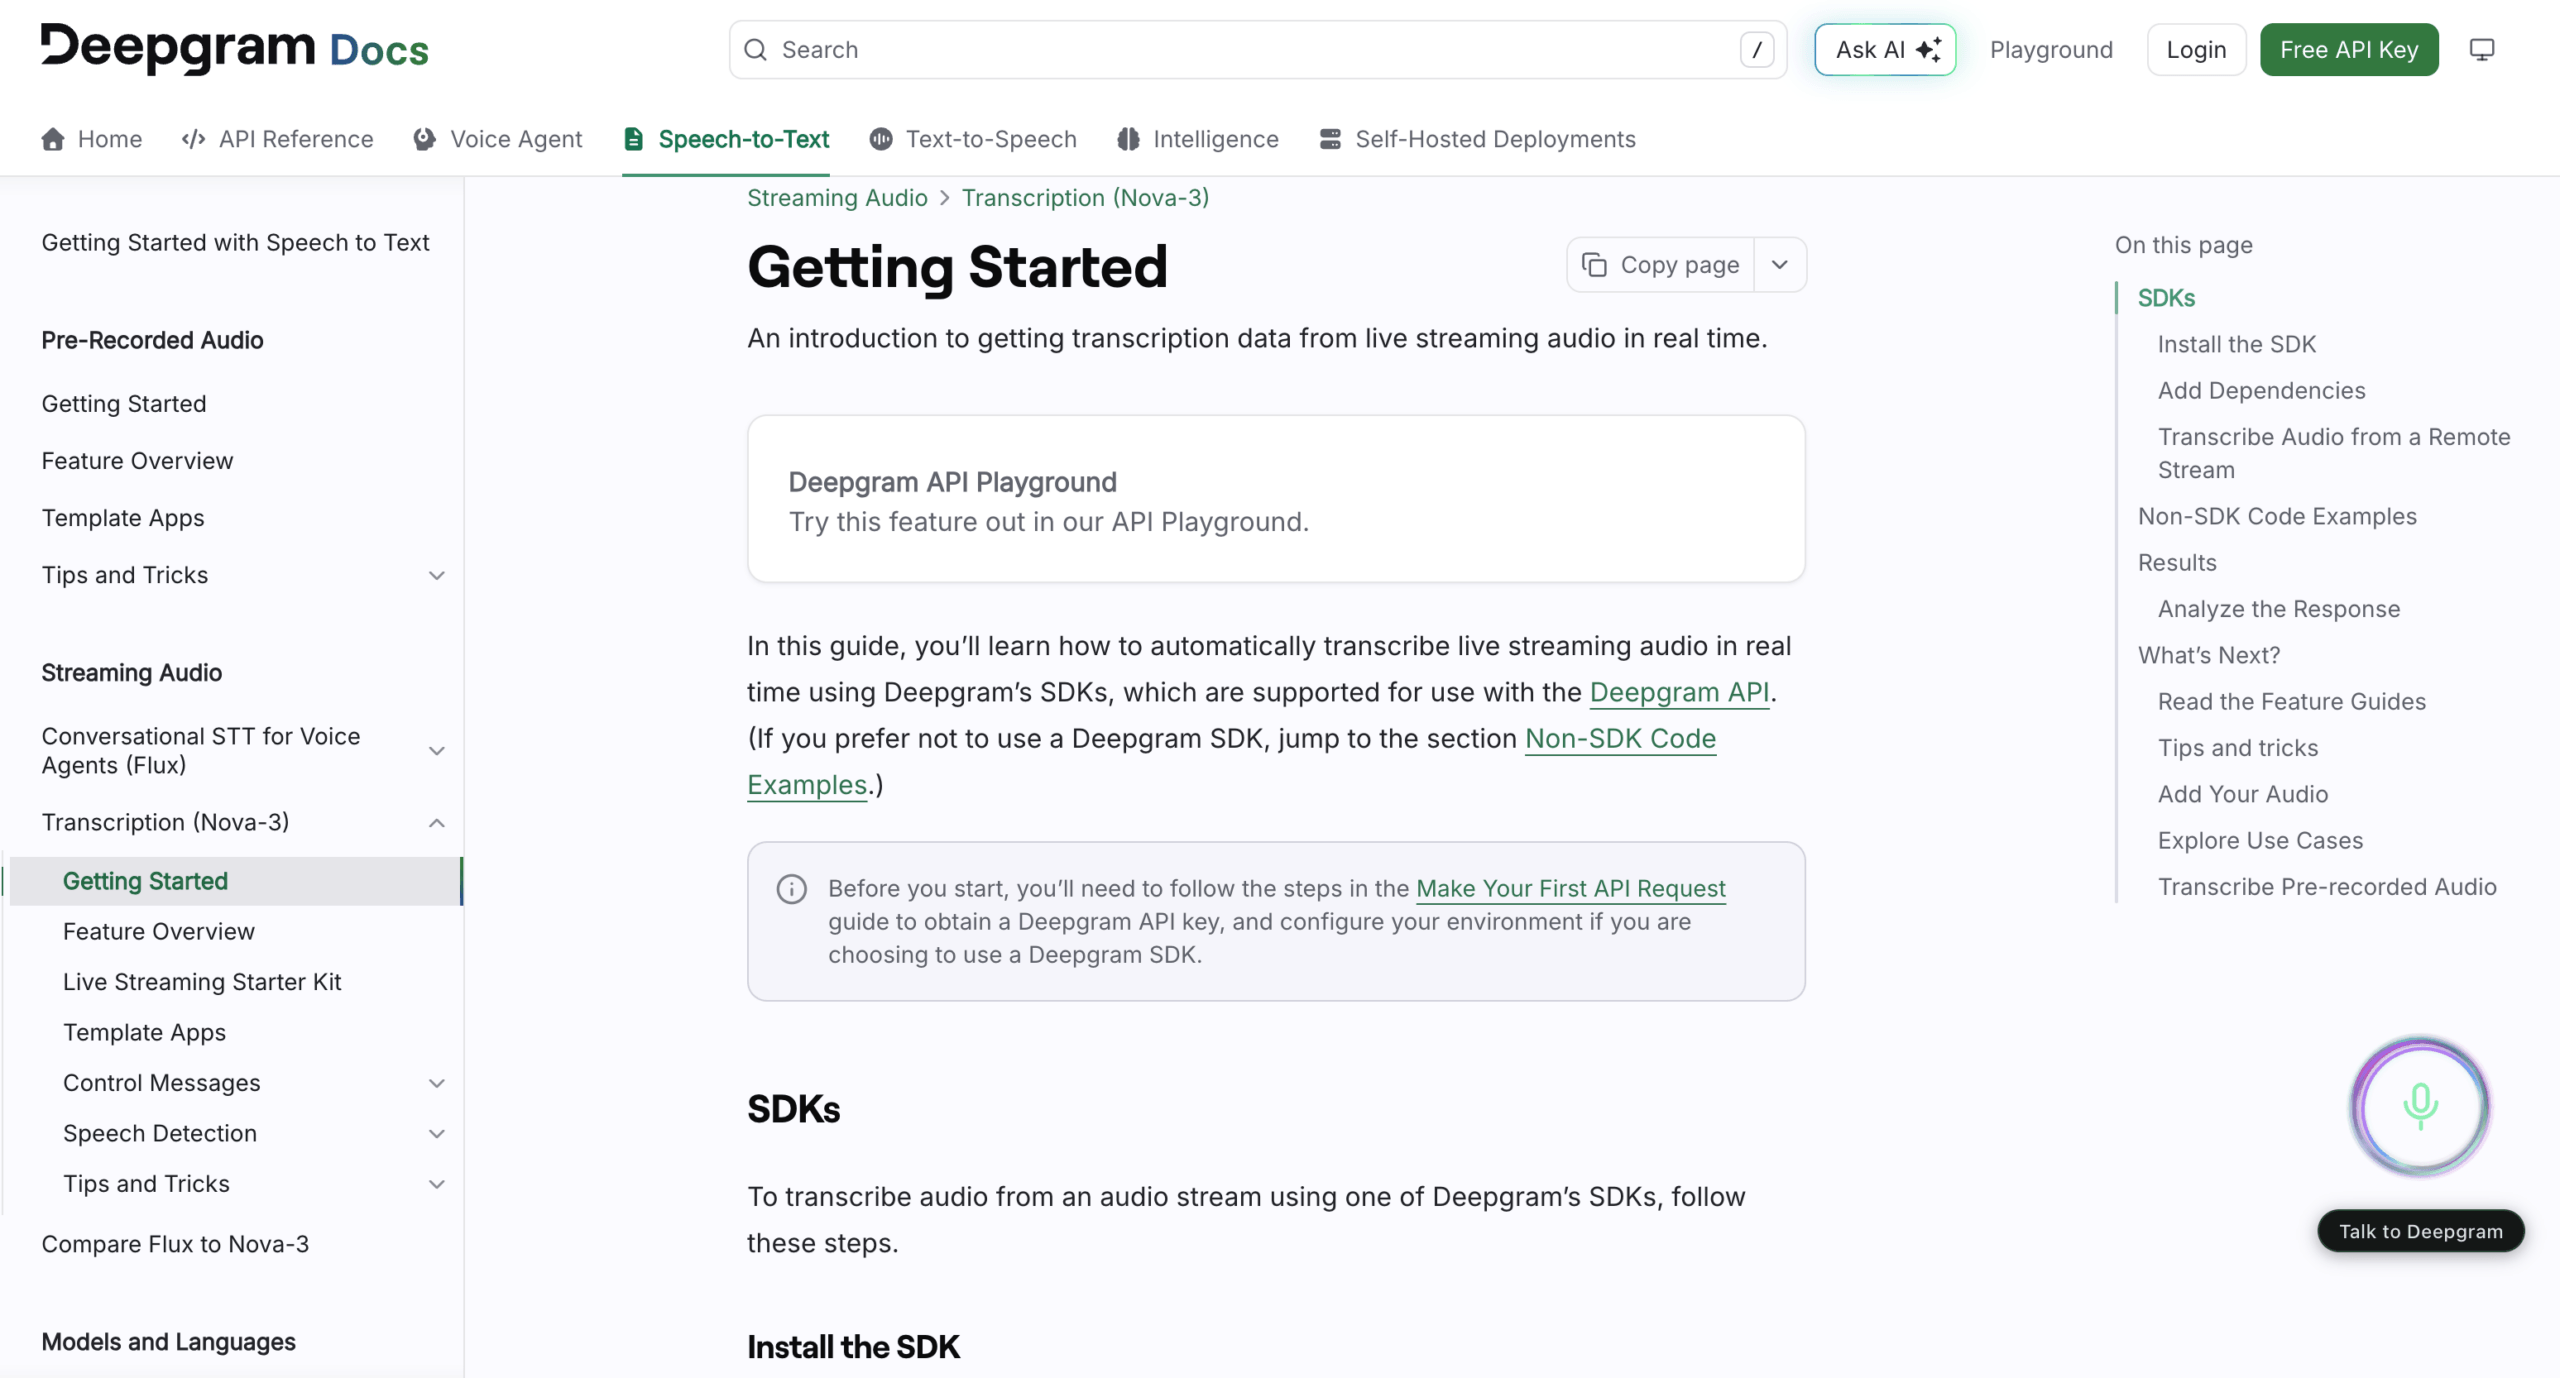
Gebruik Deepgram Wanneer het productteam de conversatie-eigenschappen moet aanpassen in plaats van een vaste ondertitelingsinterface te accepteren, blijft het team verantwoordelijk voor audiotransport, statusbeheer, weergave van gedeeltelijke tekst, opslag, authenticatie, machtigingen, correcties en de uiteindelijke gebruikerservaring.
Een veelgemaakte implementatiefout is om alleen het laatste antwoord op te slaan of alleen te wachten op een gebeurtenis die het einde van de spraak aangeeft. De officiële richtlijnen leggen uit dat een lange spraakuiting meerdere afgeronde transcriptsegmenten kan bevatten voordat het einde van de spraak wordt gedetecteerd. De applicatie moet de laatste segmenten correct samenvoegen.
Route 3: Gebruik AssemblyAI wanneer luidsprekerlabels belangrijk zijn bij streaming.
AssemblyAI Het model biedt streamingmodellen met gedeeltelijke en volledige transcripties, eindpunten, prompts voor sleuteltermen, woordtijdstempels en ondersteunde sprekerdiarisatiemodi. De documentatie beschrijft ook gebeurtenissen voor sprekerrevisie: het model kan eerdere sprekerlabels corrigeren naarmate er meer bewijsmateriaal wordt verzameld.
Dat revisiegedrag is belangrijk in live-interfaces. Als een applicatie "Spreker A" te vroeg als permanent markeert, bereiken latere correcties mogelijk nooit het opgeslagen record. De gebruikersinterface heeft een weloverwogen strategie nodig voor labels en revisies die nog in behandeling zijn.
Kiezen AssemblyAI Wanneer sprekerbewuste streaming en applicatiebeheer belangrijk zijn. Bevestig het exacte model, de taalondersteuning, het diarizatiegedrag, de medische opties en de gegevensvereisten voor de geplande implementatie; de functies variëren per streamingmodel.
Route 4: Gebruik Soniox voor API's voor meertalige streaming.
Soniox Het combineert realtime transcriptie en vertaling via de WebSocket API. De huidige interface ondersteunt taalhints, contextaanpassing, sprekerdiarisatie, vertaalconfiguratie, tijdstempels op tokenniveau, betrouwbaarheid, finaliteit en taalinformatie.
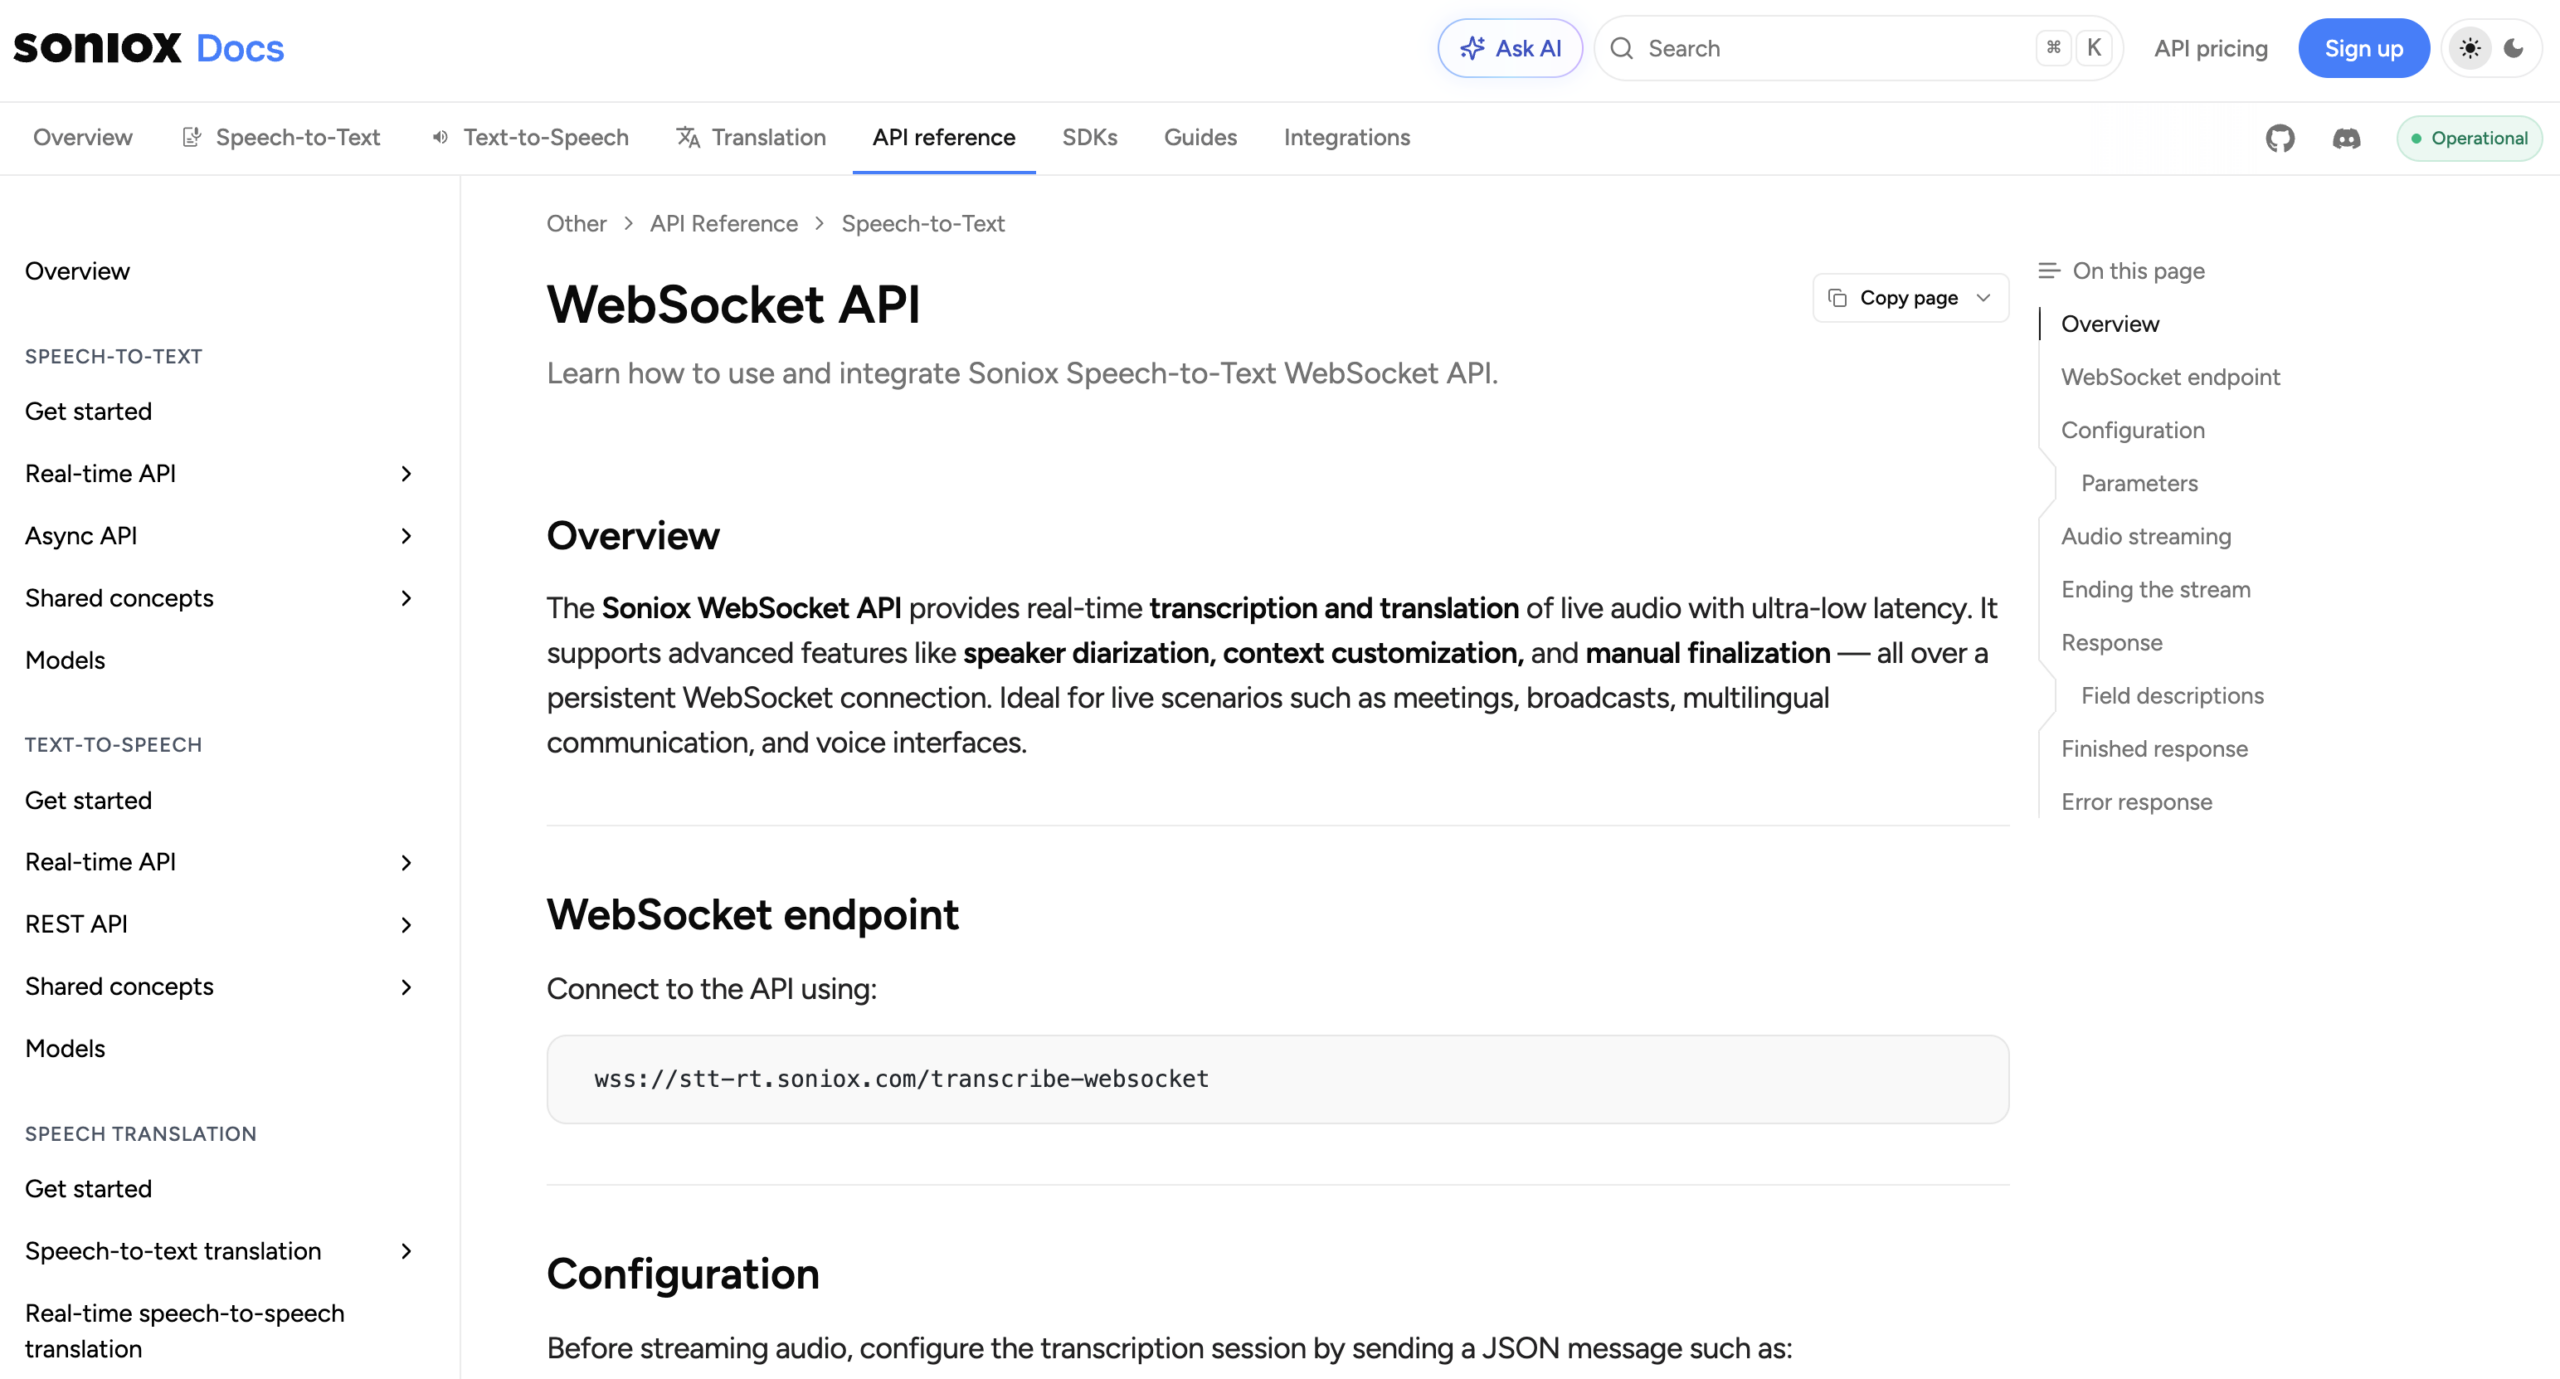
Dit maakt Soniox relevant wanneer ontwikkelaars willen Spraak-naar-tekst in realtime en meertalige uitvoer binnen hun eigen applicatie. Contextconfiguratie kan helpen bij domeintermen, maar dit moet worden getest met een vast terminologiescript in plaats van te worden afgeleid van de functienaam.
Net als bij de andere API's levert de service bouwstenen terug. De koper moet nog steeds de toegang voor deelnemers, correcties, gegevensbewaring, exportmogelijkheden, samenvattingen, beheerdersfuncties, monitoring, foutcorrectie en ondersteuning configureren.
Waarom het woordfoutpercentage niet genoeg is
Het woordfoutpercentage meet vervangingen, verwijderingen en invoegingen ten opzichte van een referentietranscriptie. Het is nuttig, maar een enkel gemiddelde kan de belangrijkste fouten maskeren.
Vergelijk deze twee fouten:
- “We kunnen verzenden op Donderdag” wordt “We kunnen verzenden op Dinsdag.”
- “"Open alstublieft de instellingenpaneel” wordt “Openen een instellingenpaneel.”
Beide kunnen op dezelfde manier meetellen, maar de eerste wijzigt een verplichting. Maak een foutenregister aan voor:
- Namen en sprekeridentificatie.
- Getallen, valuta, datums en eenheden.
- Ontkenningen en voorwaarden.
- Productnamen en vakterminologie.
- Code-switching en taalwisselingen.
- Onderbrekingen en zelfcorrecties.
- Interpunctie die de betekenis verandert.
Voeg daar timing aan toe. Een correct woord dat wordt uitgesproken nadat de beslissing is genomen, kan operationeel onjuist zijn. Een voorlopige fout die later wordt gecorrigeerd, kan er nog steeds toe hebben geleid dat een spraakagent of deelnemer actie ondernam.
Het recht Spraak-naar-tekst in realtime De score combineert daarom de ernst van feitelijke fouten, de stabiliteit, de timing van de beurt en de voordracht – en niet alleen de gemiddelde woordnauwkeurigheid.
De Twee Minuten Waarheid Tape
Gebruik één opgenomen bron, zodat elke kandidaat identieke audio te horen krijgt. Laat niet elke leverancier zijn eigen demo kiezen.
Script
- “Hallo, ik ben Niamh O'Rourke van Aster-Q.”
- “Het betreft BX-417, niet BX-471.”
- “"De omzet bedroeg 15,05 miljoen, een stijging van 13,6 procent."”
- “"Niet verlengen tenzij de serviceovereenkomst is ondertekend."”
- “"Verzend vijftien—sorry, vijftig—eenheden op donderdag."”
- “"De API maakt gebruik van WebSocket-streaming en een eindpunt met een responstijd van 300 milliseconden."”
- Pauzeer 700 milliseconden midden in een voorwaardelijke zin.
- Laat een tweede persoon onderbreken en ga daarna weer verder met de eerste spreker.
- Voeg één zin toe in de gevraagde tweede taal.
- Eindig met een rustige zin terwijl het toetsenbord hoorbaar is.
Vastleggingsblad
| meting | Hoe neem je het op? | Geef een voorwaarde door die u definieert voordat u gaat testen. |
|---|---|---|
| Tijd voor het eerste bericht | Audio start bij eerste niet-lege hypothese | Gebaseerd op de behoefte van de gebruiker aan visuele feedback. |
| Tijd voor stabiele tekst | Het laatst gesproken woord in de definitieve, onveranderlijke tekst. | Het gaat zo snel dat mensen niet reageren op de herzieningen. |
| Vertraging bij het afronden van een beurt | Einde van de beoogde beurt naar eindpuntgebeurtenis of reactietrigger | Onderbreekt normale pauzes niet en voelt niet onresponsief aan. |
| Revisieaantal | Aantal zichtbare of API-niveau hypothesewijzigingen | De interface blijft leesbaar en vervolgacties wachten op afronding. |
| Kritieke feitelijke fouten | Namen, cijfers, ontkenningen, data, eenheden en voorwaarden | Geen ongemelde, ernstige fouten in de pilot. |
| Herstel van het sprekerlabel | Tijd en correctheid na onderbreking | Het opgeslagen transcript weerspiegelt de gecorrigeerde toewijzing. |
| Voltooiing van de workflow | Einde van de actie voor het doorzoekbare/exporteerbare record of de applicatie | Voldoet aan de operationele deadline. |
Voer tien proeven uit en rapporteer vervolgens de mediaan, het 95e percentiel en de slechtst waargenomen resultaten, voor zover de steekproef dit toelaat. Eén perfecte meting is geen garantie voor betrouwbaarheid.
Zeven soorten storingen en de eerste oplossing
| Symptoom | Waarschijnlijke laag | Eerste nuttige controle |
|---|---|---|
| De tekst verschijnt pas laat na het eerste woord. | Vastleggen, bufferen, coderen, netwerk of model | Meet elke stap; verklein te grote audiofragmenten. |
| De tekst verschijnt snel, maar wordt vervolgens uitgebreid herschreven. | Tussentijds hypothesegedrag | Wacht op definitieve informatie voordat je acties uitvoert; herontwerp de voorlopige weergave. |
| Het systeem schakelt doordachte sprekers uit. | Eindpuntdrempel of spraakactiviteitsdetectie | Test langere pauzes en pas de eindpuntinstellingen aan waar mogelijk. |
| Het systeem wacht te lang na korte commando's. | Eindpuntdrempel of applicatie-uitschakellogica | Test kortere drempelwaarden of expliciete eindcontroles. |
| Namen en codes werken herhaaldelijk niet. | Akoestische ambiguïteit en ontbrekende domeincontext | Voeg belangrijke termen/context toe en verbeter de microfoonkwaliteit. |
| Luidsprekerlabels veranderen na weergave | Streaming diarization is het herzien van clusters. | Ondersteun lopende labels en pas revisiegebeurtenissen toe op de registratie. |
| Het transcript wordt snel gemaakt, maar is daarna onbruikbaar. | Ontbrekende productworkflow | Voeg correctie-, opslag-, zoek-, machtigings-, export- en verwijderingsfuncties toe, of kies een kant-en-klare app. |
Problemen oplossen Spraak-naar-tekst in realtime Van links naar rechts. Het vervangen van het model lost geen problemen op met een gedempte invoer, een onjuiste samplefrequentie of een gebruikersinterface die voorlopige tekst als definitief opslaat.
Wanneer spraak-naar-tekst niet de uiteindelijke oplossing is
Transcriptie beantwoordt de vraag: "Welke woorden werden herkend?" Vertaling beantwoordt de vraag: "Wat betekenen die woorden in een andere taal?" Een vergaderproduct moet ook de vraag beantwoorden: "Kan de andere persoon het begrijpen, erop reageren en de beslissing later terughalen?"“
Als iedereen dezelfde taal spreekt en behoefte heeft aan ondertiteling, dicteren, zoeken of analyses, kan een speciale STT API of transcriptieproduct volstaan. Als deelnemers verschillende talen spreken, vereist de workflow extra controlemogelijkheden:
- De brontekst is zichtbaar naast de vertaling.
- Taalselectie of automatische afhandeling.
- Terminologie en contextvoorbereiding.
- Tekst in de doeltaal die tijdens het gesprek wordt voorgelezen.
- Optionele vertaalde spraakweergave voor het geval voorlezen niet mogelijk is.
- Verslagen en aantekeningen die de meertalige discussie vastleggen.
Dit is het punt waar Spraak-naar-tekst in realtime wordt een onderdeel van het grotere geheel Transync AI het werkproces in plaats van het eindproduct.
Veelgestelde vragen over realtime spraak-naar-tekst
Wat is realtime spraak-naar-tekst?
Spraak-naar-tekst in realtime Het systeem zet streaming audio om in voorlopige en definitieve tekst terwijl er gesproken wordt. Het kan eerdere hypothesen herzien naarmate er meer context beschikbaar komt, het einde van een beurt wordt gedetecteerd, leestekens worden toegevoegd of de spreker beter wordt toegewezen.
Hoeveel vertraging telt als realtime?
Er is geen eenduidige drempelwaarde. Meet de tijd tot de eerste tekst, stabiele tekst, definitieve afhandeling en bruikbare workflow-output. Een ondertitelaar, spraakassistent, deelnemer aan een vergadering en iemand die het gesprek achteraf beoordeelt, hanteren verschillende acceptabele vertragingen.
Waarom verandert de live tekst steeds?
Spraakherkenners publiceren gedeeltelijke hypothesen voordat een zin compleet is. Latere audio kan de meest waarschijnlijke formulering, interpunctie, taal of spreker veranderen. Toepassingen moeten voorlopige resultaten onderscheiden van de definitieve tekst.
Is spraak-naar-tekst in realtime hetzelfde als live vertaling?
Nee. Spraak-naar-tekst herkent gesproken woorden in de brontaal. Livevertaling voegt daar nog een taaltransformatie aan toe en kan ook vertaalde spraak toevoegen. Transync AI Combineert spraakherkenning en vertaling voor meertalige gesprekken.
Welke API is het meest geschikt voor realtime spraak-naar-tekstconversie?
Er is geen universele winnaar. Deepgram biedt gedetailleerde eindpunt- en resultaatstatuscontroles., AssemblyAI biedt ondersteuning voor streamingdiarisatie en revisiegedrag, en Soniox Combineert meertalige transcriptie- en vertaalopties. Test ze elk met identieke audio en de exacte productvereisten.
Kan spraak-naar-tekst in realtime de sprekers identificeren?
Sommige modellen ondersteunen diarizatie of meerkanaals invoer, maar labels kunnen voorlopig zijn en veranderen naarmate er meer audio binnenkomt. Test onderbrekingen, vergelijkbare stemmen, apparaatwisselingen en correcties van opgeslagen labels.
Wat moet een bedrijf als eerste testen?
Begin met de daadwerkelijke audio-opname en een script van twee minuten met namen, getallen, negaties, correcties, pauzes, onderbrekingen, terminologie en de vereiste talen. Meet alle vier de klokken en controleer de opgeslagen opname.
Eindconclusie
De snelste Spraak-naar-tekst in realtime Een systeem is niet per se het systeem dat het eerste woord het vroegst weergeeft. Een betrouwbaar systeem balanceert vier klokken:
eerste tekst → stabiele tekst → voltooide beurt → bruikbaar record
Kies een streaming-API wanneer ontwikkelaars de eindpunten, gedeeltelijke resultaten, sprekerrevisies en het gedrag van de applicatie moeten kunnen beheren. Kies een kant-en-klaar vergaderproduct wanneer het team het volledige traject van audio tot ondertiteling, vertaling, opnames en notities nodig heeft zonder zelf die infrastructuur te hoeven bouwen.
Het allerbelangrijkste is om de daadwerkelijke invoer en het daadwerkelijke gevolg te testen. Meet het woord dat verschijnt, het woord dat verandert, de beurt die eindigt en de registratie die iemand daarna kan vertrouwen.