La conversione da parlato a testo in tempo reale è molto più di una semplice sottotitolazione rapida. Prima di scegliere, valuta 4 orologi nascosti, le revisioni, la gestione dell'oratore e l'idoneità alle riunioni multilingue.
La conversione da parlato a testo in tempo reale può apparire eccellente in una demo, ma risultare comunque inefficace in una conversazione. Le prime parole potrebbero comparire in 300 millisecondi, ma la frase potrebbe continuare a cambiare per due secondi. L'etichetta dell'oratore potrebbe arrivare e poi essere modificata. Una trascrizione rifinita potrebbe essere pronta rapidamente, ma omettere la negazione che ha modificato la decisione.
Ecco perché la domanda "Quanto è veloce?" è la prima domanda sbagliata. Una valutazione utile richiede quattro indicatori: tempo di visualizzazione del primo testo, tempo di visualizzazione di un testo stabile, tempo di completamento di un turno e tempo di visualizzazione di un record utilizzabile. Ciascun indicatore risponde a un'esigenza operativa diversa.
Questo articolo tratta conversione del parlato in testo in tempo reale Si tratta di un flusso di lavoro misurabile, non di un effetto visivo. Confronta API di streaming specializzate con un prodotto per riunioni multilingue pronto all'uso, fornisce uno script di test ripetibile e spiega quando la sola trascrizione non è sufficiente perché i partecipanti necessitano di traduzione, output vocale o appunti.
La risposta in 60 secondi
Conversione vocale in tempo reale in testo Converte un flusso audio in tempo reale in testo mentre l'oratore sta ancora parlando. Il testo visualizzato è spesso provvisorio. Le prime parole possono essere modificate man mano che il modello riceve più contesto, rileva una pausa, identifica chi parla, applica la punteggiatura o finalizza un'espressione.
I quattro orologi sono:
- Latenza del primo messaggio: Quanto tempo passerà prima che emerga un'ipotesi?
- Latenza di stabilità: Quanto tempo passerà prima che le parole smettano di cambiare?
- Latenza di finalizzazione del turno: Quanto tempo impiega il sistema a stabilire che un turno di parola o un'espressione sono terminati?
- Latenza del flusso di lavoro: Quanto tempo prima che la trascrizione sia utilizzabile per la ricerca, le note, le azioni, la traduzione o per una risposta alla candidatura?
Un agente vocale potrebbe dare priorità alla finalità del turno perché deve decidere quando rispondere. I sottotitoli per l'accessibilità potrebbero dare priorità a testi parziali veloci e leggibili. Una registrazione di riunione potrebbe tollerare una visualizzazione leggermente più lenta se nomi, numeri e attribuzione dei relatori diventassero più affidabili. Una riunione multilingue aggiunge un'ulteriore fase dopo il riconoscimento: la traduzione deve arrivare abbastanza presto da permettere a qualcuno di rispondere.
La conversione del parlato in testo in tempo reale è un'ipotesi in continua evoluzione.
Una trascrizione in tempo reale non viene prodotta in un solo passaggio:
microfono o audio di sistema → codifica e trasporto → rilevamento vocale → riconoscimento provvisorio → revisione → finalizzazione → etichettatura e formattazione dell'oratore → azione dell'applicazione
Lo schermo di solito mostra solo la parte centrale. Questo crea un'illusione comune: poiché il testo appare immediatamente, gli utenti presumono che il risultato sia definitivo. In realtà, il motore di elaborazione potrebbe essere ancora impegnato a riconsiderare i confini delle parole, la punteggiatura, la lingua o l'identità di chi parla.
Le API specializzate rendono esplicita questa distinzione. Deepgram Il sistema restituisce separatamente i risultati intermedi e quelli definitivi. La documentazione spiega che il testo preliminare può subire modifiche, mentre i segmenti definitivi devono essere aggiunti per ricostruire un'espressione completa. Un segnale separato di fine discorso indica che il sistema ha rilevato un punto finale, come ad esempio una pausa.
Sonox Espone token finali e non finali, timestamp, livello di confidenza, informazioni sulla lingua, etichette facoltative del parlante e stato di avanzamento dell'elaborazione tramite una connessione di streaming persistente. AssemblyAI Allo stesso modo offre trascrizioni parziali e finali, indicazione dei punti finali, timestamp a livello di parola, suggerimenti per termini chiave e diarizzazione in streaming dell'oratore nei modelli supportati.
Questi controlli sono utili per gli sviluppatori. Rivelano anche perché un utente finale non dovrebbe giudicare conversione del parlato in testo in tempo reale dalla sola prima linea visibile.
Orologio 1: Tempo al primo messaggio
Il primo orologio inizia quando il parlato raggiunge il sistema e si ferma quando la prima ipotesi non vuota diventa visibile o disponibile per l'applicazione.
Questa misurazione include più della semplice inferenza del modello:
- Registrazione audio da microfono o da riunione.
- Dimensione del buffer e suddivisione dei file audio in blocchi.
- Ricampionamento o codifica.
- Trasporto di rete.
- Elaborazione da parte del server.
- Trasporto di ritorno.
- Rendering dell'interfaccia.
Misura conversione del parlato in testo in tempo reale dal dispositivo effettivo dell'utente, non da una dashboard API. Il dato lato server fornito da un fornitore può escludere il buffering audio, la rete client, il rendering del browser e il ritardo della piattaforma di riunione stessa.
Il testo iniziale rapido è utile quando gli utenti hanno bisogno di rassicurazioni sul fatto che il sistema li stia ascoltando. È meno utile quando l'interfaccia li incoraggia ad agire sulla base di parole incerte. Un buon design delle didascalie distingue visivamente il testo provvisorio senza renderlo illeggibile.
Come testare il primo orologio
Registra lo stesso audio e lo schermo a 60 fotogrammi al secondo. Batti le mani una volta, poi dì: "Il rinnovo non è approvato". Segna il fotogramma in cui la forma d'onda o il battito di mani raggiungono l'input e il fotogramma in cui appare il primo testo. Ripeti dieci volte e riporta il risultato mediano e quello più lento, non la migliore esecuzione.
Test conversione del parlato in testo in tempo reale In condizioni di Wi-Fi normale, rete congestionata, laptop con soppressione del rumore attiva e con le cuffie o il microfono ambientale, la velocità di risposta del primo messaggio che scompare sotto carico normale non è una caratteristica affidabile del prodotto.
Orologio 2: Tempo per un testo stabile
Il secondo orologio si ferma quando un blocco di testo non subisce ulteriori modifiche. Questo è l'orologio che la maggior parte delle presentazioni di marketing tende a nascondere.
Considera la frase pronunciata:
“Spedite quindici... scusate, cinquanta unità giovedì.”
La visualizzazione potrebbe passare da "spedizione 15" a "spedizione 50", quindi a una correzione punteggiata. La prima versione è arrivata rapidamente, ma solo la versione finale è sicura da copiare in un ordine.
La stabilità è importante perché i sistemi a valle potrebbero reagire troppo presto. Un riepilogo in tempo reale, un assistente alle vendite, un trigger di conformità, un livello di traduzione o un agente vocale possono ereditare un errore provvisorio. In un conversione del parlato in testo in tempo reale Nel flusso di lavoro, gli sviluppatori dovrebbero elaborare i segnali di finalità del motore anziché trattare ogni aggiornamento parziale come un'istruzione completata.
Misurare la distanza di revisione, non solo il ritardo.
Per ogni frase di prova, registra:
- Numero di versioni provvisorie.
- Numero di parole sostituite o rimosse.
- Tempo intercorso tra l'ultima parola pronunciata e la comparsa di testo stabile.
- Se la trascrizione finale memorizzata corrisponde alla visualizzazione stabile.
- Se un'azione a valle sia stata innescata prima del raggiungimento della stabilità.
Un po' più lento conversione del parlato in testo in tempo reale Il sistema può essere più sicuro se le revisioni sono meno aggressive. Il giusto compromesso dipende dal fatto che gli utenti stiano leggendo, dettando, controllando un software o conducendo una negoziazione.
Orologio 3: Tempo per completare un turno
Le parole possono essere definitive, ma il turno di parola non lo è ancora. Una persona può fare una pausa per pensare, respirare, cercare una cifra o attendere che si verifichi un'interruzione. Se il sistema dichiara il turno terminato troppo presto, un assistente vocale potrebbe parlare sopra l'utente. Se invece aspetta troppo a lungo, la conversazione risulterà poco reattiva.
In genere, la tecnica del endpointing si basa sul silenzio o sull'attività vocale per dedurre che il discorso è terminato. Deepgram documenti endpoint configurabili e separati è_finale E discorso_finale afferma. Le sue linee guida notano che soglie brevi possono essere adatte a risposte concise dei chatbot, mentre pause di conversazione più lunghe possono richiedere centinaia di millisecondi prima che un turno sia considerato completato.
Non esiste un'impostazione universale adatta a tutti gli interlocutori. Un copione veloce per un call center, un'anamnesi medica esitante, una lezione in aula e una negoziazione bilingue hanno schemi di pausa diversi. La finalità del turno è quindi fondamentale conversione del parlato in testo in tempo reale misurazione, non semplicemente un'impostazione API.
Eseguire il test di esitazione
Utilizza queste quattro righe:
- “Il mio numero di conto è … 4172.”
- “Sono d'accordo… se la data di consegna rimane venerdì.”
- “Il dosaggio è di quindici... no, cinquanta milligrammi.”
- “Ana, puoi—” seguito da una seconda voce che interrompe.
Conta le false terminazioni di svolta, i punti finali in ritardo, le interruzioni e le parole troncate. Quindi regola la soglia dei punti finali solo se l'applicazione lo prevede. Se il prodotto è un'app completa, osserva il comportamento e decidi se è adatto allo scopo.
Questo orologio è dove conversione del parlato in testo in tempo reale Diventa ingegneria della conversazione piuttosto che semplice trascrizione.
Orologio 4: Tempo necessario per ottenere una registrazione utilizzabile
Il quarto ciclo di clock è il più importante per i team. Termina quando i risultati ottenuti sono sufficienti a supportare l'azione successiva.
“Utilizzabile” può significare:
- I sottotitoli rimangono leggibili durante la sessione.
- Gli oratori sono identificabili.
- Nomi, numeri e terminologia sono correggibili.
- È possibile copiare o esportare la trascrizione completa.
- Il record è ricercabile e l'accesso è consentito solo previa autorizzazione.
- Vengono generati un riepilogo e le relative azioni da intraprendere.
- Il testo originale e quello tradotto rimangono abbinati.
- I concetti di conservazione ed eliminazione sono sottintesi.
Un sistema può vincere i primi tre orologi e perdere il quarto. Lo streaming JSON grezzo non è un verbale di riunione. I sottotitoli veloci che scompaiono non sono prove. Un bel riassunto senza una trascrizione tracciabile può nascondere errori di riconoscimento. Ecco perché conversione del parlato in testo in tempo reale L'ufficio acquisti deve valutare sia il flusso di lavoro completato che il modello di streaming.
Conversione vocale in tempo reale in testo La valutazione dovrebbe quindi essere effettuata nel momento dell'utilizzo, non nel momento della generazione. Chiedete al partecipante, al revisore, allo sviluppatore e all'amministratore di testare la stessa sessione dal proprio punto di vista.
Quattro percorsi confrontati dai quattro orologi
| strumenti | Tipo di prodotto | Primo testo | Controlli di stabilità e finalità | Gestione degli altoparlanti | ruolo multilingue | Flusso di lavoro dei record utilizzabili | Migliore vestibilità |
|---|---|---|---|---|---|---|---|
| Transync AI | Applicazione di traduzione per riunioni pronta all'uso | Spettacolo bilingue dal vivo | Gestito dal prodotto anziché esposto come parametri API | Rileva automaticamente la coppia di lingue selezionata; revisione in originale e in testo tradotto | 60 lingue, sottotitoli bilingue, voce tradotta | Registro delle traduzioni, trascrizione e riepilogo della riunione sull'IA | Persone e team che necessitano di comunicare in tempo reale in diverse lingue senza dover sviluppare un'app. |
| Deepgram | API per lo streaming di parlato in testo | È possibile abilitare i risultati intermedi | Espone risultati intermedi/finali, terminazione, eventi di fine parlato, controlli di fine enunciato e finalizzazione manuale. | Le opzioni di diarizzazione e multicanale dipendono dalla configurazione/modello | Opzioni di lingua e modello per lo streaming; la traduzione è una decisione separata relativa al flusso di lavoro. | Il cliente deve creare archiviazione, modifica, autorizzazioni, riepiloghi e interfaccia utente | Sviluppatori che creano agenti vocali, sottotitoli, analisi delle chiamate o prodotti di trascrizione personalizzati |
| AssemblyAI | API per lo streaming di parlato in testo | Trascrizioni parziali restituite tramite connessione streaming | Finalizzazione intelligente e trascrizioni immutabili; si applica il comportamento specifico del modello. | Nei modelli supportati sono disponibili la registrazione in streaming e gli eventi di revisione da parte del relatore. | Il modello di streaming multilingue supporta un set di lingue pubblicato | Il cliente crea l'applicazione finale e registra il ciclo di vita | I team di prodotto necessitano di riconoscimento in streaming con diarizzazione e analisi a valle |
| Sonox | API di intelligenza artificiale per il riconoscimento vocale in tempo reale | Flusso di token non finali a bassa latenza | Flag del token finale, finalizzazione manuale, timestamp del token e stato di avanzamento dell'elaborazione | Diarizzazione opzionale degli oratori | Trascrizione e traduzione multilingue in tempo reale tramite configurazione API | Il cliente crea interfaccia, persistenza, revisione e governance | Sviluppatori che creano riunioni multilingue, trasmissioni, assistenti o interfacce vocali |
Le funzionalità sono state verificate rispetto alla documentazione ufficiale del prodotto il 3 ottobre 2026. Modelli, lingue, limiti e prezzi possono subire variazioni.
La tabella non classifica un vincitore universale. Separa due decisioni di acquisto: costruire un prodotto attorno a un'API di streaming o utilizzare un flusso di lavoro finito. Il migliore conversione del parlato in testo in tempo reale Il percorso dipende da chi si occupa dell'acquisizione audio, della progettazione dell'interfaccia, delle correzioni, dell'archiviazione e dell'assistenza.
Percorso 1: Utilizzare l'IA Transync quando il parlato deve attraversare le lingue
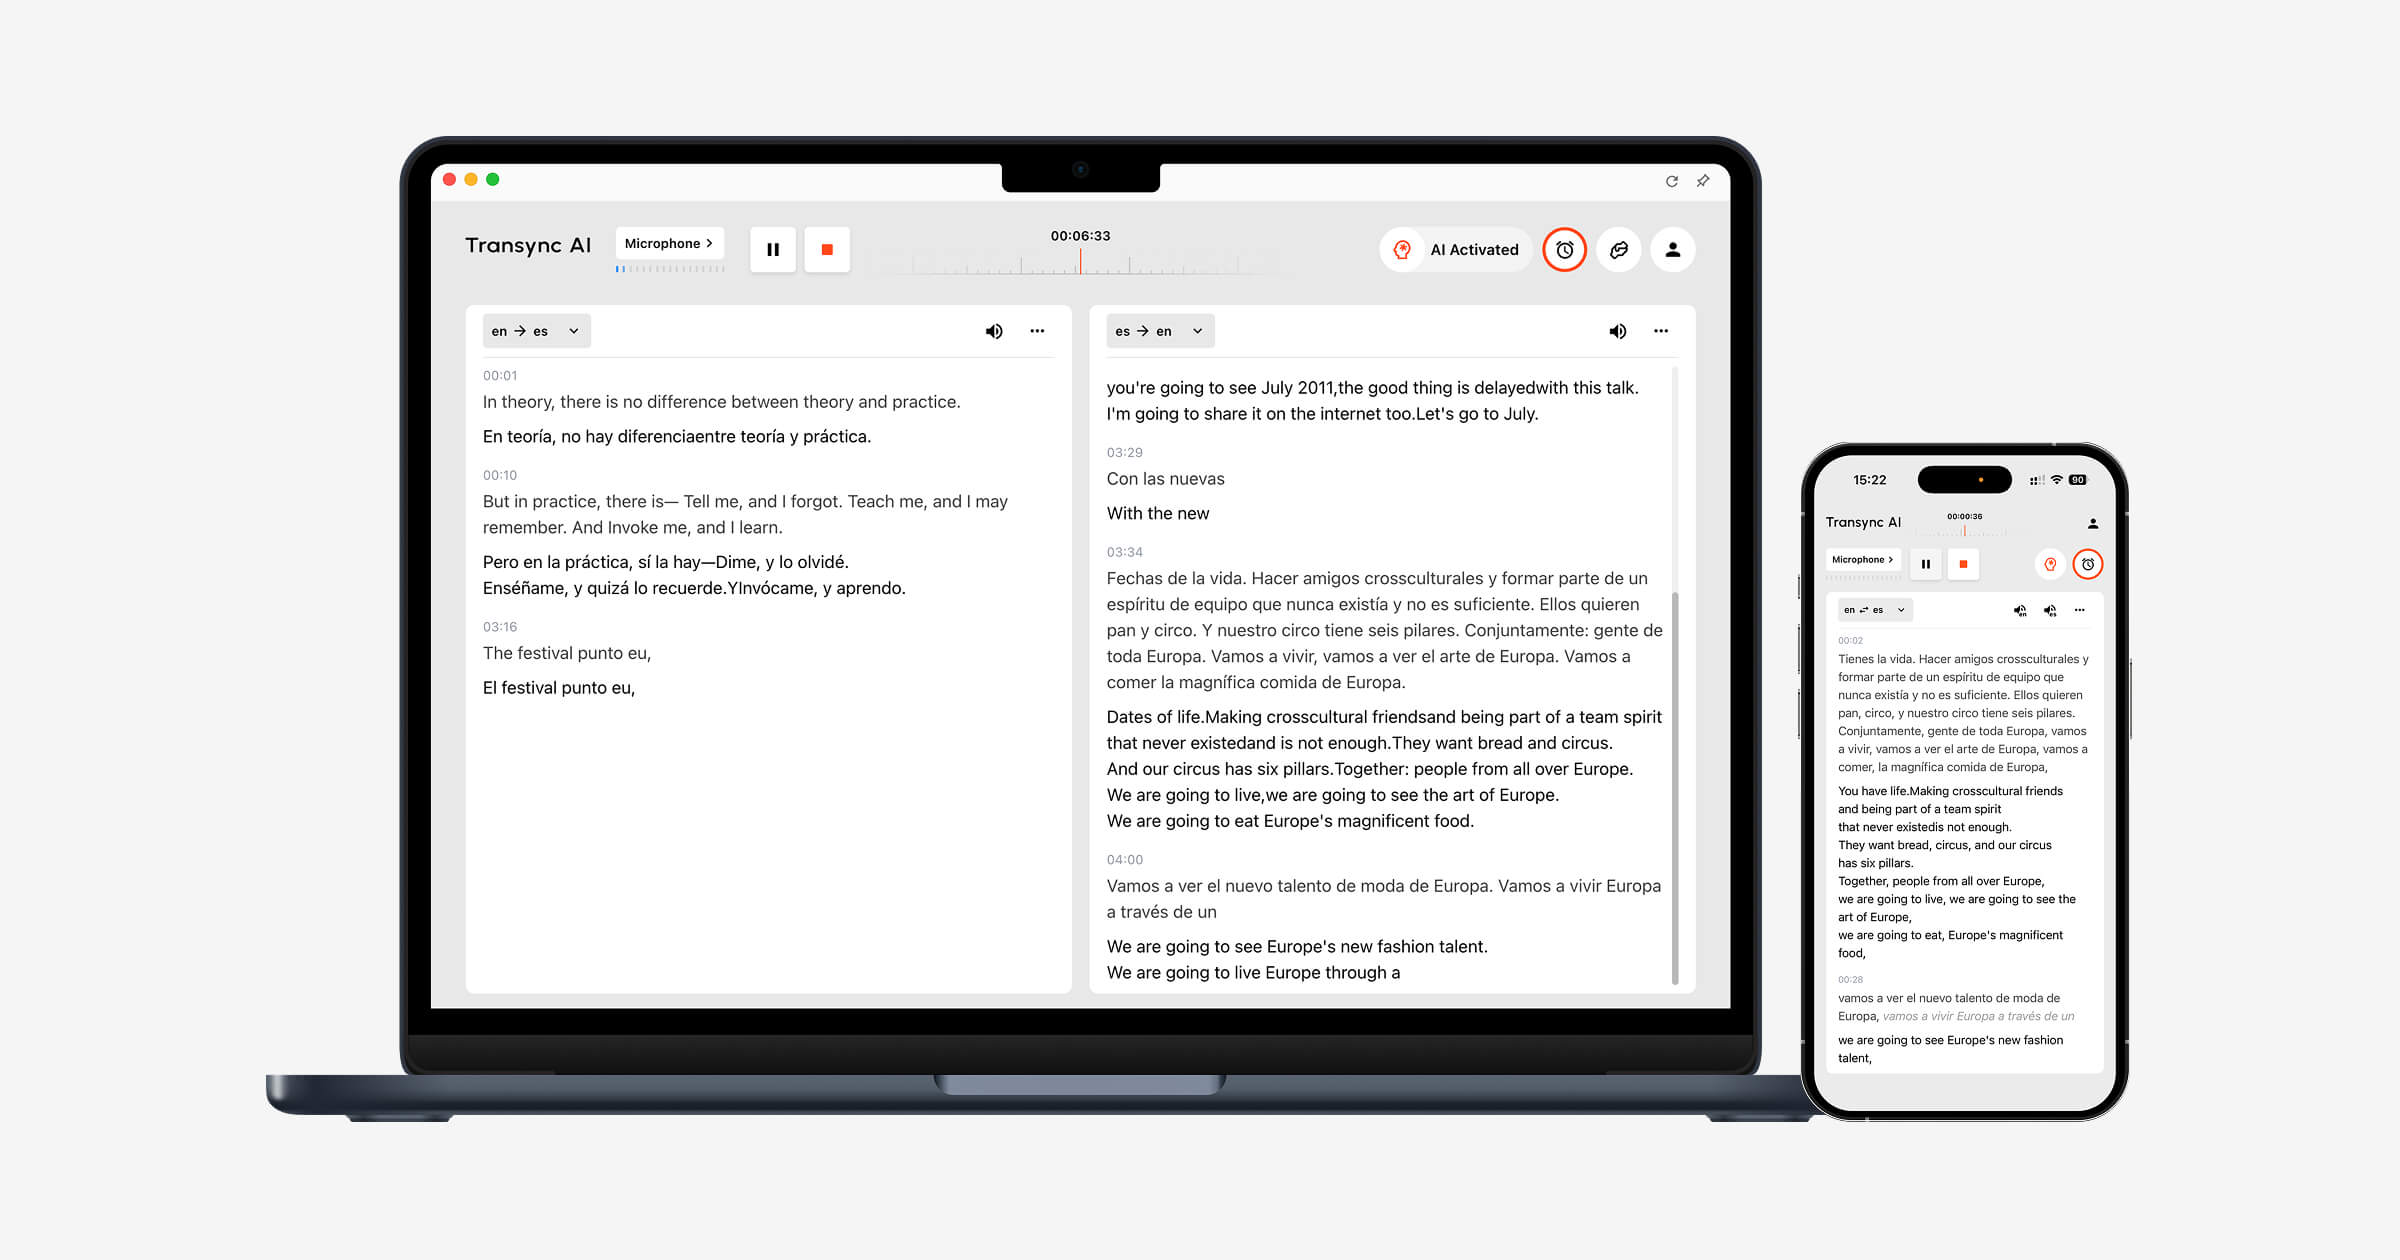
Transync AI Non viene venduto come un'API di conversione da parlato a testo per uso generale. È un prodotto per riunioni e conversazioni pronto all'uso che combina il riconoscimento con la traduzione. flusso di lavoro di traduzione in tempo reale Supporta 60 lingue e mantiene il parlato originale accanto al testo tradotto, aiutando gli utenti a distinguere gli errori di riconoscimento da quelli di traduzione.
Per le chiamate online, il suo traduzione di riunioni in diretta Può funzionare con diversi ambienti di videoconferenza tramite il microfono selezionato o il percorso audio del computer. Sottotitoli Picture-in-Picture Mantenere il testo bilingue visibile sopra le applicazioni supportate, anziché costringere l'utente a visualizzare una scheda di trascrizione separata.
Prima di una chiamata, Parole chiave e contesto può preparare nomi, acronimi, termini di prodotto e informazioni di base. Dopo la sessione, la trascrizione conserva il testo originale e tradotto, mentre Appunti della riunione di intelligenza artificiale È possibile generare riepiloghi e azioni da intraprendere. La guida attuale per la trascrizione afferma che i riepiloghi delle riunioni possono essere generati in 55 lingue.
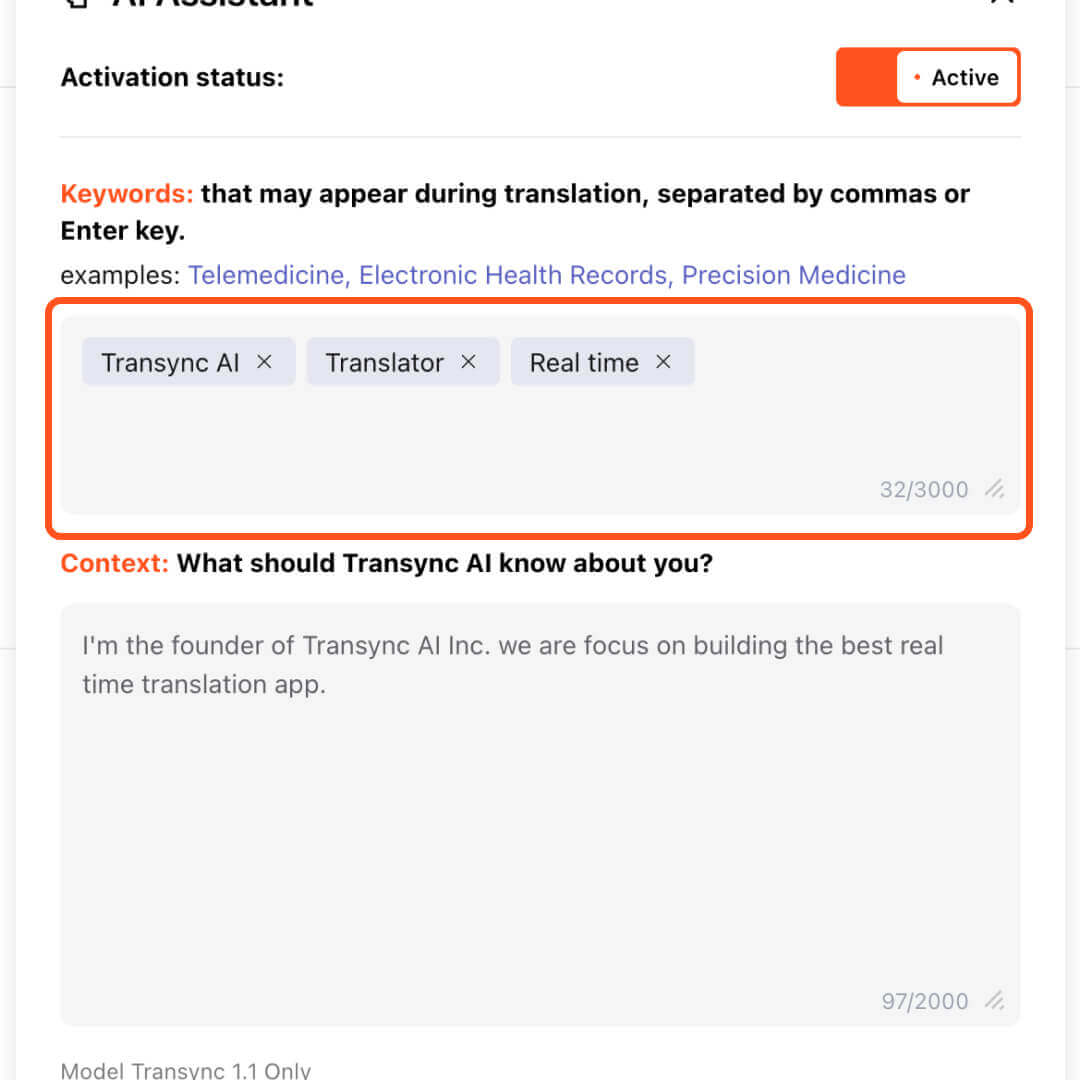
L'interfaccia Transync AI evidenzia il pannello di attivazione dell'assistente AI con le parole chiave 'Transync AI', 'Traduttore' e 'Tempo reale', mostrando come inserire parole chiave personalizzate per traduzioni accurate.
Prova Transync AI gratuitamente
Scegliere Transync AI Quando l'obiettivo aziendale è comprendere e rispondere in diverse lingue, è preferibile optare per un'API di streaming quando il team sta sviluppando un proprio agente vocale, una piattaforma di analisi delle chiamate, un prodotto per l'accessibilità o un'interfaccia di trascrizione integrata.
La limitazione è importante: Transync AI Non si tratta di un motore di dettatura offline generico o di un endpoint STT per sviluppatori. Il routing audio, la qualità della rete, le coppie di lingue, i microfoni e la trasmissione remota devono essere testati prima di una riunione importante.
Percorso 2: Utilizzare Deepgram quando la tempistica di svolta è parte integrante del prodotto
Deepgram È particolarmente utile per gli sviluppatori perché la sua documentazione separa i risultati intermedi, i segmenti finali, i punti finali del parlato rilevati e gli eventi di fine enunciato. Questa separazione consente a un'applicazione di decidere quando visualizzare il testo, aggiungere testo stabile o attivare una risposta.
Utilizzo Deepgram quando il team di prodotto ha bisogno di ottimizzare il comportamento conversazionale anziché accettare un'interfaccia di sottotitoli fissa. Il team rimane comunque responsabile del trasporto audio, della gestione dello stato, del rendering parziale del testo, dell'archiviazione, dell'autenticazione, delle autorizzazioni, delle correzioni e dell'esperienza utente finale.
Un errore di implementazione comune è quello di salvare solo l'ultima risposta o di attendere solo l'evento di fine del discorso. Le linee guida ufficiali spiegano che un'espressione lunga può contenere più segmenti di trascrizione finali prima della fine del discorso rilevata. L'applicazione deve concatenare correttamente i segmenti finali.
Percorso 3: Utilizzare AssemblyAI quando si trasmette in streaming: le etichette degli altoparlanti sono importanti
AssemblyAI Fornisce modelli di streaming con trascrizioni parziali e finali, indicazione dei punti finali, suggerimenti per termini chiave, timestamp delle parole e modalità di diarizzazione del parlante supportate. La sua documentazione descrive anche gli eventi di revisione del parlante: il modello può correggere le etichette del parlante precedenti man mano che raccoglie ulteriori prove.
Esplora lo streaming di AssemblyAI
Il comportamento relativo alle revisioni è fondamentale nelle interfacce in tempo reale. Se un'applicazione contrassegna "Speaker A" come permanente troppo presto, le correzioni successive potrebbero non essere mai registrate. L'interfaccia utente necessita di una strategia ben definita per la gestione di etichette e revisioni in sospeso.
Scegliere AssemblyAI Quando lo streaming con riconoscimento dell'oratore e il controllo a livello di applicazione sono importanti. Confermare il modello esatto, il supporto linguistico, il comportamento di diarizzazione, le opzioni mediche e i requisiti dati per l'implementazione prevista; le funzionalità variano a seconda del modello di streaming.
Percorso 4: Utilizzare Sonoox per le API di streaming multilingue
Sonox Integra la trascrizione e la traduzione in tempo reale tramite la sua API WebSocket. L'interfaccia attuale supporta suggerimenti linguistici, personalizzazione del contesto, diarizzazione del parlante, configurazione della traduzione, timestamp a livello di token, livello di confidenza, finalità e informazioni sulla lingua.
Questo fa Sonox rilevante quando gli sviluppatori vogliono conversione del parlato in testo in tempo reale e output multilingue all'interno della propria applicazione. La configurazione del contesto può aiutare con i termini di dominio, ma dovrebbe essere testata con uno script di terminologia fissa piuttosto che essere dedotta dal nome della funzionalità.
Come per le altre API, il servizio restituisce dei componenti di base. L'acquirente deve comunque creare l'accesso dei partecipanti, le correzioni, la conservazione dei dati, le esportazioni, i riepiloghi, i controlli amministrativi, il monitoraggio, il ripristino in caso di errore e l'assistenza.
Perché il tasso di errore di parola non è sufficiente
Il tasso di errore di parola misura le sostituzioni, le cancellazioni e le inserzioni rispetto a una trascrizione di riferimento. È utile, ma una singola media può nascondere gli errori più importanti.
Confronta questi due errori:
- “Possiamo spedire su Giovedì”" diventa "Possiamo spedire su Martedì.”
- “Per favore apri il pannello delle impostazioni”" diventa "Per favore apri un pannello delle impostazioni.”
Entrambi possono avere un peso simile, ma il primo modifica un impegno. Crea un registro degli errori per:
- Nomi e identità di chi parla.
- Numeri, valute, date e unità di misura.
- Negazioni e condizioni.
- Nomi dei prodotti e terminologia specialistica.
- Commutazione di codice e cambiamenti di lingua.
- Interruzioni e autocorrezioni.
- Punteggiatura che cambia significato.
Aggiungiamo poi la questione dei tempi. Una parola corretta pronunciata dopo che la decisione è stata presa potrebbe essere operativamente errata. Un errore provvisorio corretto in seguito potrebbe comunque aver indotto un operatore vocale o un partecipante ad agire.
Il diritto conversione del parlato in testo in tempo reale Il punteggio, pertanto, combina la gravità degli errori fattuali, la stabilità, la tempistica dei turni e la fluidità di espressione, e non si limita alla semplice accuratezza media delle parole.
Il nastro della verità di due minuti
Utilizzate un'unica sorgente audio registrata, in modo che ogni candidato riceva un audio identico. Non permettete a ciascun fornitore di scegliere la propria demo.
Sceneggiatura
- “"Salve, sono Niamh O'Rourke di Aster-Q."”
- “Il codice di riferimento è BX-417, non BX-471.”
- “Il fatturato è stato di 15,05 milioni di TP5T, in aumento del 13,6%.”
- “Non rinnovate il contratto se non viene firmato l'accordo sui livelli di servizio.”
- “Spedite quindici... scusate, cinquanta unità giovedì.”
- “"L'API utilizza lo streaming WebSocket e un endpoint da 300 millisecondi."”
- Fai una pausa di 700 millisecondi nel mezzo di una frase condizionale.
- Lasciate che una seconda persona intervenga, poi riprendete a parlare con il primo interlocutore.
- Aggiungi una frase nella seconda lingua richiesta.
- Concludi con una frase a bassa voce mentre si sente il suono di una tastiera.
Foglio di acquisizione
| Misurazione | Come registrarlo | Condizione di superamento da definire prima del test |
|---|---|---|
| È ora del primo messaggio | Inizio audio alla prima ipotesi non vuota | In base alla necessità dell'utente di un feedback visivo |
| Tempo per un testo stabile | Ultima parola pronunciata al testo finale immutabile. | Abbastanza veloce da non permettere alle persone di agire sulle revisioni |
| Ritardo di finalità del turno | Fine della svolta prevista verso l'evento finale o il trigger di risposta | Non interrompe le normali pause e non dà l'impressione di non rispondere. |
| Conteggio delle revisioni | Numero di modifiche di ipotesi visibili o a livello API | L'interfaccia rimane leggibile e le azioni successive attendono la conclusione. |
| Errori di fatto cruciali | Nomi, cifre, negazioni, date, unità e condizioni | Nessun errore di elevata gravità non segnalato nel progetto pilota |
| Recupero dell'etichetta del relatore | Tempo e correttezza dopo l'interruzione | La trascrizione memorizzata riflette l'attribuzione corretta |
| Completamento del flusso di lavoro | Fine della riunione per record ricercabili/esportabili o azione applicativa | Rispetta la scadenza operativa |
Eseguire dieci prove, quindi riportare la mediana, il 95° percentile e il risultato peggiore osservato, laddove il campione lo consenta. Una singola prova perfetta non è sufficiente a stabilire l'affidabilità.
Sette modalità di guasto e la prima soluzione
| Sintomo | Strato probabile | Primo controllo utile |
|---|---|---|
| Il testo appare in ritardo rispetto alla prima parola | Cattura, buffering, codifica, rete o modello | Misura ogni salto; riduci i frammenti audio di dimensioni eccessive |
| Il testo appare rapidamente ma viene riscritto pesantemente | comportamento ipotizzato provvisorio | Attendi la definitività prima di intraprendere azioni; riprogetta la visualizzazione provvisoria |
| Il sistema interrompe chi parla in modo riflessivo | Rilevamento della soglia finale o dell'attività vocale | Prova pause più lunghe e regola la fine del ciclo, ove possibile. |
| Il sistema attende troppo a lungo dopo comandi brevi | Soglia dell'endpoint o logica di svolta dell'applicazione | Provare soglie più brevi o controlli espliciti di fine turno |
| Nomi e codici falliscono ripetutamente | Ambiguità acustica e contesto di dominio mancante | Aggiungi termini/contesto chiave e migliora la qualità del microfono. |
| Le etichette degli altoparlanti cambiano dopo la visualizzazione | La diarizzazione in streaming sta rivedendo i cluster | Gestire le etichette in sospeso e applicare gli eventi di revisione al record. |
| La trascrizione è veloce ma inutilizzabile in seguito | Flusso di lavoro del prodotto mancante | Aggiungi correzione, archiviazione, ricerca, autorizzazioni, esportazione ed eliminazione oppure scegli un'app completa |
Risoluzione dei problemi conversione del parlato in testo in tempo reale Da sinistra a destra. La sostituzione del modello non risolverà un problema di input disattivato, una frequenza di campionamento errata o un'interfaccia utente che salva il testo provvisorio come definitivo.
Quando la conversione da parlato a testo non è il lavoro finale
La trascrizione risponde alla domanda: "Quali parole sono state riconosciute?". La traduzione risponde alla domanda: "Qual è il significato di queste parole in un'altra lingua?". Il risultato di una riunione deve inoltre rispondere alla domanda: "L'altra persona è in grado di comprendere, rispondere e recuperare la decisione in un secondo momento?".“
Se tutti i partecipanti parlano la stessa lingua e necessitano di sottotitoli, dettatura, ricerca o analisi per facilitare l'accesso, un'API STT dedicata o un prodotto di trascrizione potrebbero essere sufficienti. Se i partecipanti utilizzano lingue diverse, il flusso di lavoro richiede controlli aggiuntivi:
- Il testo originale è visibile accanto alla traduzione.
- Selezione della lingua o gestione automatica.
- Preparazione della terminologia e del contesto.
- Testo nella lingua di destinazione fornito durante la conversazione.
- La traduzione vocale opzionale durante la lettura non è pratica.
- Documenti e appunti che conservano la discussione multilingue.
Questo è il punto in cui conversione del parlato in testo in tempo reale diventa una componente del più grande Transync AI flusso di lavoro piuttosto che il prodotto finale.
Domande frequenti sulla conversione da parlato a testo in tempo reale
Che cos'è la conversione da parlato a testo in tempo reale?
Conversione vocale in tempo reale in testo Il sistema converte l'audio in streaming in testo provvisorio e definitivo mentre il parlato è in corso. Il sistema può rivedere le ipotesi iniziali man mano che riceve più contesto, rileva la fine di un turno, applica la punteggiatura o migliora l'attribuzione dell'oratore.
Quanto ritardo viene considerato tempo reale?
Non esiste una soglia univoca. Misurare il tempo di visualizzazione del primo testo, del testo stabile, della finalità del turno e dell'output utilizzabile del flusso di lavoro. Un lettore di sottotitoli, un operatore vocale, un partecipante alla riunione e un revisore post-chiamata hanno ritardi accettabili diversi.
Perché il testo in tempo reale continua a cambiare?
I sistemi di riconoscimento in streaming pubblicano ipotesi parziali prima che una frase sia completa. L'audio successivo può modificare la formulazione, la punteggiatura, la lingua o l'oratore più probabili. Le applicazioni dovrebbero distinguere i risultati provvisori dal testo definitivo.
La conversione del parlato in testo in tempo reale è la stessa cosa della traduzione simultanea?
No. La conversione da parlato a testo riconosce le parole pronunciate nella lingua di origine. La traduzione in tempo reale aggiunge un'ulteriore trasformazione linguistica e può anche aggiungere la voce tradotta. Transync AI Combina riconoscimento e traduzione per conversazioni multilingue.
Qual è la migliore API per la conversione in testo del parlato in tempo reale?
Non esiste un vincitore universale. Deepgram offre controlli dettagliati su endpoint e stato dei risultati, AssemblyAI offre supporto per la diarizzazione in streaming e il comportamento di revisione, e Sonox Combina opzioni di trascrizione e traduzione multilingue. Testa ciascuna opzione con audio identico e con i requisiti di prodotto esatti.
È possibile identificare chi parla in tempo reale tramite la conversione da parlato a testo?
Alcuni modelli supportano la diarizzazione o l'input multicanale, ma le etichette potrebbero essere provvisorie e soggette a modifiche man mano che arrivano altri file audio. Testare interruzioni, voci simili, cambi di dispositivo e correzioni delle etichette memorizzate.
Cosa dovrebbe testare per prima un'azienda?
Iniziate con il percorso audio effettivo e uno script di due minuti contenente nomi, numeri, negazioni, correzioni, pause, interruzioni, terminologia e le lingue richieste. Misurate tutti e quattro gli orologi e controllate la registrazione salvata.
Verdetto finale
Il più veloce conversione del parlato in testo in tempo reale Il sistema non è necessariamente quello che mostra la prima parola prima. Un sistema affidabile bilancia quattro orologi:
primo testo → testo stabile → turno completato → record utilizzabile
Scegli un'API di streaming quando gli sviluppatori devono controllare gli endpoint, i risultati parziali, le revisioni dei relatori e il comportamento dell'applicazione. Scegli un prodotto per riunioni completo quando il team necessita del percorso completo dall'audio ai sottotitoli, alla traduzione, alle registrazioni e alle note, senza dover creare l'infrastruttura necessaria.
La cosa più importante è testare l'input reale e la conseguenza reale. Misura la parola che appare, la parola che cambia, il turno che termina e la registrazione di cui qualcuno si fiderà in seguito.