La conversión de voz a texto en tiempo real es más que subtítulos rápidos. Antes de elegir, tenga en cuenta 4 relojes ocultos, revisiones, gestión de interlocutores y compatibilidad con reuniones multilingües.
La conversión de voz a texto en tiempo real puede verse excelente en una demostración, pero fallar en una conversación. Las primeras palabras pueden aparecer en 300 milisegundos, pero la frase puede seguir cambiando durante dos segundos. Puede aparecer una etiqueta de hablante y luego ser modificada. Una transcripción pulida puede estar lista rápidamente, pero omitir la negación que cambió la decisión.
Por eso, la pregunta "¿Qué tan rápido es?" no es la correcta para empezar. Una evaluación útil requiere cuatro indicadores: tiempo hasta el primer texto, tiempo hasta un texto estable, tiempo hasta completar un turno y tiempo hasta un registro utilizable. Cada indicador responde a una necesidad operativa diferente.
Este artículo trata Conversión de voz a texto en tiempo real Se trata de un proceso cuantificable en lugar de un efecto visual. Compara las API de transmisión especializadas con un producto de reuniones multilingüe listo para usar, proporciona un guion de prueba repetible y explica cuándo la transcripción por sí sola es insuficiente porque los participantes necesitan traducción, audio o notas.
La respuesta en 60 segundos
Conversión de voz a texto en tiempo real Convierte una transmisión de audio en directo en texto mientras el hablante sigue hablando. El texto que se muestra suele ser provisional. Las primeras palabras se pueden revisar a medida que el modelo recibe más contexto, detecta una pausa, identifica al hablante, aplica la puntuación o finaliza una frase.
Los cuatro relojes son:
- Latencia del primer texto: ¿Cuánto tiempo pasará hasta que aparezca alguna hipótesis?
- Latencia de estabilidad: ¿Cuánto tiempo pasará hasta que las palabras dejen de cambiar?
- Latencia de finalización de turno: ¿Cuánto tarda el sistema en determinar que un turno de palabra o una intervención ha finalizado?
- Latencia del flujo de trabajo: ¿Cuánto tiempo transcurre hasta que la transcripción esté lista para ser utilizada para búsquedas, notas, acciones, traducción o para responder a una solicitud?
Un agente de voz puede priorizar la finalización de la intervención porque debe decidir cuándo responder. Los subtítulos de accesibilidad pueden priorizar la lectura rápida de textos parciales. Un registro de reunión puede tolerar una visualización ligeramente más lenta si los nombres, los números y la atribución de los oradores se vuelven más fiables. Una reunión multilingüe añade una etapa adicional después del reconocimiento: la traducción debe llegar con la suficiente antelación para que alguien pueda responder.
La conversión de voz a texto en tiempo real es una hipótesis en constante evolución.
La transcripción en directo no se genera en un solo paso:
micrófono o audio del sistema → codificación y transporte → detección de voz → reconocimiento provisional → revisión → finalización → etiquetado y formato del hablante → acción de la aplicación
La pantalla suele mostrar solo la parte central. Esto crea una ilusión común: como el texto aparece de inmediato, los usuarios asumen que el resultado está terminado. En realidad, el motor aún puede estar revisando los límites de las palabras, la puntuación, el idioma o la identidad del hablante.
Las API especializadas dejan clara esta distinción. Deepgram Devuelve los resultados provisionales y definitivos por separado. Su documentación explica que el texto preliminar puede cambiar, mientras que los segmentos definitivos deben añadirse para reconstruir una locución completa. Una señal de finalización de voz independiente indica que el sistema ha detectado un punto final, como una pausa.
Soniox Muestra tokens finales y no finales, marcas de tiempo, nivel de confianza, información de idioma, etiquetas de hablante opcionales y progreso del procesamiento a través de una conexión de transmisión persistente. EnsamblajeAI De forma similar, ofrece transcripciones parciales y finales, puntos finales, marcas de tiempo a nivel de palabra, sugerencias de términos clave y diarización de hablantes en tiempo real en los modelos compatibles.
Esos controles son útiles para los desarrolladores. También revelan por qué un usuario final no debería juzgar. Conversión de voz a texto en tiempo real Solo por la primera línea visible.
Reloj 1: Tiempo hasta el primer texto
El primer contador se pone en marcha cuando la voz llega al sistema y se detiene cuando la primera hipótesis no vacía se hace visible o está disponible para la aplicación.
Esta medición incluye más que la inferencia del modelo:
- Micrófono o captura de audio de la reunión.
- Tamaño del búfer y segmentación del audio.
- Remuestreo o codificación.
- Transporte en red.
- Procesamiento del servidor.
- Transporte de regreso.
- Renderizado de la interfaz.
Medida Conversión de voz a texto en tiempo real Desde el dispositivo del usuario, no desde un panel de control de API. El valor del servidor del proveedor puede excluir el almacenamiento en búfer de audio, la red del cliente, la renderización del navegador y el retardo propio de la plataforma de reuniones.
El texto inicial rápido es valioso cuando los usuarios necesitan la seguridad de que el sistema está escuchando. Es menos útil cuando la interfaz los incita a actuar basándose en palabras inestables. Un buen diseño de subtítulos distingue visualmente el texto provisional sin hacerlo ilegible.
Cómo probar el primer reloj
Graba el mismo audio y la pantalla a 60 fotogramas por segundo. Da una palmada y di: “La renovación no está aprobada”. Marca el fotograma donde la onda sonora o la palmada llega a la entrada y el fotograma donde aparece el primer texto. Repite el proceso diez veces e informa la mediana y el resultado más lento, no el mejor.
Prueba Conversión de voz a texto en tiempo real En condiciones normales de Wi-Fi, en una red congestionada, con un portátil con cancelación de ruido y con los auriculares o el micrófono de la habitación, la velocidad de primera respuesta que disminuye con la carga normal no es una característica fiable del producto.
Reloj 2: Tiempo para texto estable
El segundo reloj se detiene cuando un fragmento de texto deja de cambiar. Este es el reloj que suelen ocultar la mayoría de las demostraciones de marketing.
Consideremos la frase hablada:
“Enviaremos quince —perdón, cincuenta— unidades el jueves.”
La pantalla puede mostrar “envío 15”, luego “envío 50” y, finalmente, una corrección con puntuación. La primera versión llegó rápidamente, pero solo la versión final es segura para copiar en un pedido.
La estabilidad importa porque los sistemas posteriores pueden reaccionar demasiado pronto. Un resumen en vivo, un asistente de ventas, un activador de cumplimiento, una capa de traducción o un agente de voz pueden heredar un error provisional. En un Conversión de voz a texto en tiempo real En cuanto al flujo de trabajo, los desarrolladores deberían procesar las señales de finalización del motor en lugar de tratar cada actualización parcial como una instrucción completa.
Mide la distancia de revisión, no solo el retraso.
Para cada oración de prueba, registre:
- Número de versiones provisionales.
- Número de palabras reemplazadas o eliminadas.
- Tiempo transcurrido entre la última palabra hablada y el texto estable.
- Si la transcripción final almacenada coincide con la visualización estable.
- Si se desencadenó alguna acción posterior antes de que se alcanzara la estabilidad.
Un poco más lento Conversión de voz a texto en tiempo real El sistema puede ser más seguro si se revisa con menos frecuencia. El equilibrio adecuado depende de si los usuarios están leyendo, dictando, controlando el software o negociando.
Reloj 3: Tiempo para completar un turno
Las palabras pueden ser definitivas, pero el turno de palabra no lo es. Una persona puede hacer una pausa para pensar, respirar, buscar una figura o esperar a que pase una interrupción. Si el sistema declara que el turno ha terminado demasiado pronto, un agente de voz puede interrumpir al usuario. Si espera demasiado, la conversación se percibe como inactiva.
El sistema de detección de puntos finales suele utilizar el silencio o la actividad de voz para inferir que el habla ha terminado. Deepgram documentos configurables de endpointing y separados es_final y discurso_final estados. Sus directrices señalan que los umbrales cortos pueden ser adecuados para respuestas breves de chatbots, mientras que las pausas conversacionales más largas pueden requerir cientos de milisegundos antes de que se considere que un turno ha finalizado.
No existe una configuración universal que funcione para todos los hablantes. Un guion rápido de un centro de llamadas, un historial médico vacilante, una clase magistral y una negociación bilingüe tienen patrones de pausa diferentes. Por lo tanto, la finalización del turno es fundamental. Conversión de voz a texto en tiempo real medición, no simplemente una configuración de API.
Realiza la prueba de vacilación.
Utilice estas cuatro líneas:
- “Mi número de cuenta es… 4172.”
- “Estoy de acuerdo… si la fecha de entrega sigue siendo el viernes.”
- “La dosis es de quince, no, cincuenta miligramos.”
- “Ana, ¿puedes…?” seguido de una segunda persona que interrumpió.
Contabiliza los finales de giro falsos, los puntos finales tardíos, las interrupciones y las palabras recortadas. Luego, ajusta el umbral del punto final solo si la aplicación lo permite. Si se trata de una aplicación terminada, observa su comportamiento y decide si cumple con los requisitos.
Este reloj es donde Conversión de voz a texto en tiempo real se convierte en ingeniería de conversaciones en lugar de transcripción ordinaria.
Reloj 4: Tiempo para un registro utilizable
El cuarto reloj es el más importante para los equipos. Finaliza cuando el resultado permite llevar a cabo la siguiente acción.
“Utilizable” puede significar:
- Los subtítulos permanecen legibles durante toda la sesión.
- Los oradores son identificables.
- Los nombres, los números y la terminología son corregibles.
- Se puede copiar o exportar la transcripción completa.
- El registro es consultable y requiere permisos de acceso.
- Se genera un resumen y una lista de acciones a seguir.
- El texto original y el texto traducido permanecen emparejados.
- Se entienden los conceptos de retención y eliminación.
Un sistema puede ganar los tres primeros relojes y perder el cuarto. El JSON de transmisión sin procesar no es un registro de reunión. Los subtítulos rápidos que desaparecen no son evidencia. Un resumen hermoso sin una transcripción rastreable puede ocultar errores de reconocimiento. Por eso Conversión de voz a texto en tiempo real El departamento de compras debe medir tanto el flujo de trabajo finalizado como el modelo de transmisión.
Conversión de voz a texto en tiempo real Por lo tanto, debe evaluarse en el momento de su uso, no en el de su generación. Pida al participante, al revisor, al desarrollador y al administrador que prueben la misma sesión desde su propia perspectiva.
Cuatro rutas comparadas por cuatro relojes
| herramientas | Tipo de producto | Primer texto | Controles de estabilidad y finalidad | Manejo de altavoces | Puesto multilingüe | Flujo de trabajo de registro utilizable | Mejor ajuste |
|---|---|---|---|---|---|---|---|
| Transync AI | Aplicación de traducción de reuniones lista para usar | Visualización bilingüe en directo | Gestionado por el producto en lugar de expuesto como parámetros de API. | Distingue automáticamente el par de idiomas seleccionado; revisión en texto original y traducido. | 60 idiomas, subtítulos bilingües, doblaje | Registro de traducción, transcripción y resumen de la reunión de IA | Personas y equipos que necesitan comunicación multilingüe en tiempo real sin necesidad de crear una aplicación. |
| Deepgram | API de conversión de voz a texto en tiempo real | Se pueden habilitar los resultados provisionales. | Muestra resultados intermedios/finales, puntos finales, eventos de finalización del habla, controles de final de enunciado y finalización manual. | Las opciones de diarización y multicanal dependen de la configuración/modelo. | Opciones de idioma y modelo de transmisión; la traducción es una decisión de flujo de trabajo independiente. | El cliente debe crear el almacenamiento, la edición, los permisos, los resúmenes y la interfaz de usuario. | Desarrolladores que crean agentes de voz, subtítulos, inteligencia de llamadas o productos de transcripción personalizados. |
| EnsamblajeAI | API de conversión de voz a texto en tiempo real | Transcripciones parciales devueltas a través de la conexión de transmisión. | Puntos finales inteligentes y transcripciones finalizadas inmutables; se aplica un comportamiento específico del modelo. | La función de registro en tiempo real y los eventos de revisión del orador están disponibles en los modelos compatibles. | El modelo de transmisión multilingüe admite un conjunto de idiomas publicado. | El cliente crea la aplicación final y el ciclo de vida del registro. | Equipos de producto que necesitan reconocimiento de transmisión con diarización e inteligencia descendente |
| Soniox | API de IA de voz en tiempo real | Transmisión de tokens no finales con baja latencia. | Indicadores de token final, finalización manual, marcas de tiempo de los tokens y progreso del procesamiento. | Diarización de oradores opcional | Transcripción y traducción multilingüe en tiempo real mediante configuración API | El cliente crea la interfaz, la persistencia, la revisión y la gobernanza. | Desarrolladores que crean reuniones, transmisiones, asistentes o interfaces de voz multilingües. |
Las funcionalidades se verificaron con la documentación oficial del producto el 3 de octubre de 2026. Los modelos, idiomas, límites y precios pueden cambiar.
La tabla no clasifica a un ganador universal. Separa dos decisiones de compra: construir un producto en torno a una API de streaming o utilizar un flujo de trabajo terminado. El mejor Conversión de voz a texto en tiempo real La ruta depende de quién sea el propietario de la captura de audio, el diseño de la interfaz, las correcciones, el almacenamiento y el soporte.
Ruta 1: Utilice la IA Transync cuando la comunicación de voz deba transmitirse entre varios idiomas.
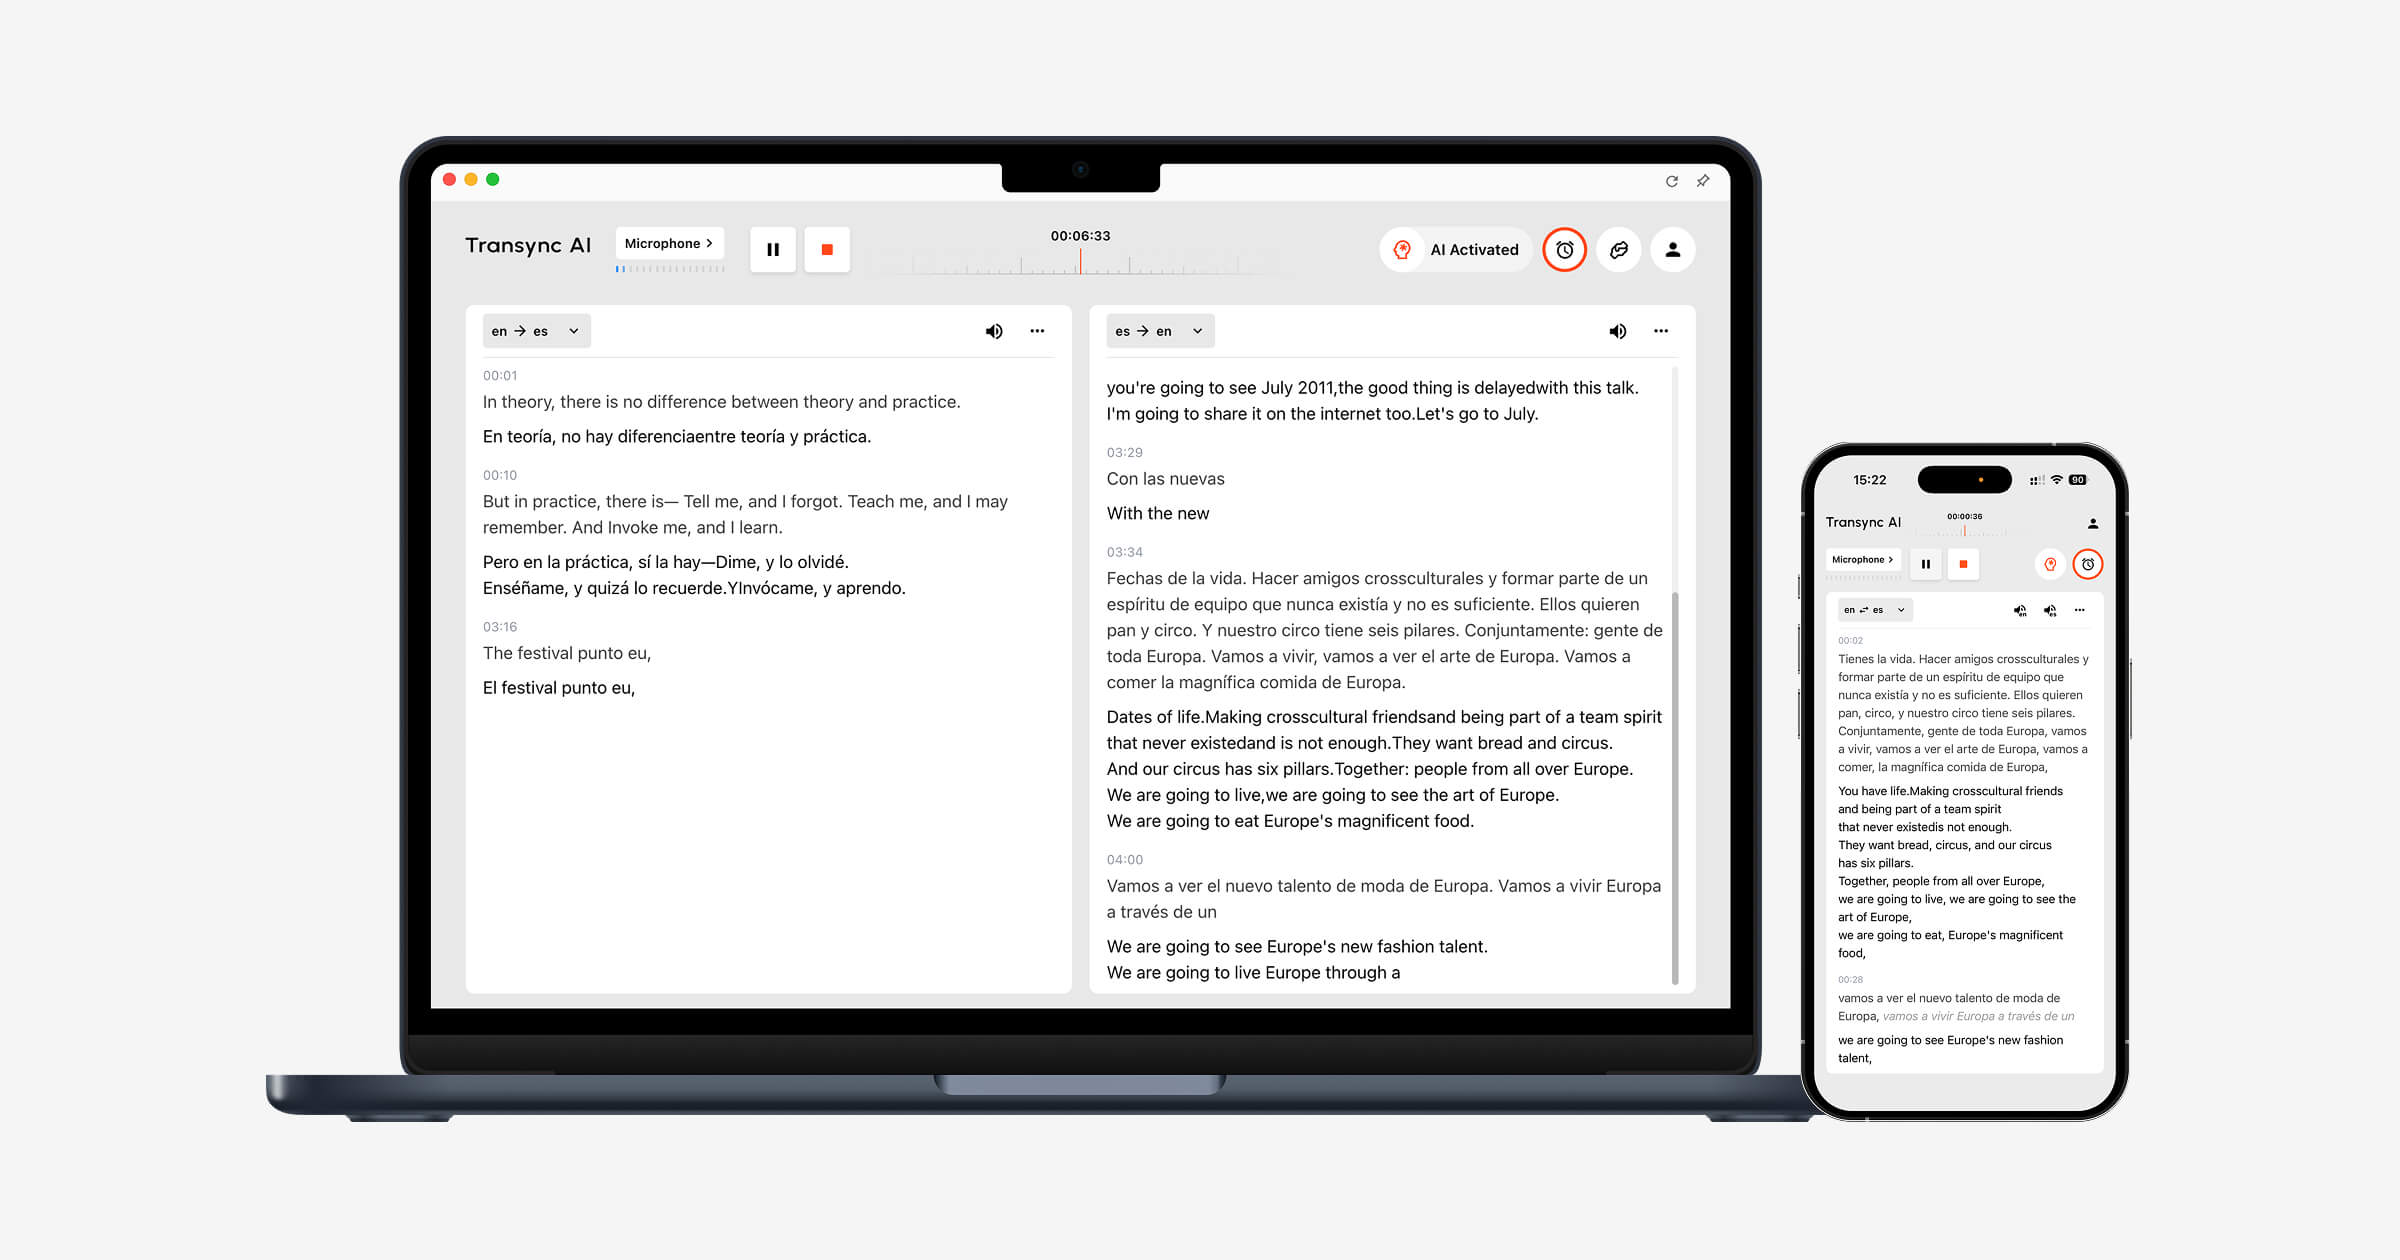
Transync AI No se vende como una API de conversión de voz a texto de propósito general. Es un producto listo para usar para reuniones y conversaciones que combina reconocimiento con traducción. flujo de trabajo de traducción en tiempo real Admite 60 idiomas y mantiene el audio original junto al texto traducido, lo que ayuda a los usuarios a diferenciar los errores de reconocimiento de los errores de traducción.
Para llamadas en línea, su traducción de reuniones en vivo Puede funcionar junto con diferentes entornos de videoconferencia a través del micrófono seleccionado o la ruta de audio del ordenador. Subtítulos en modo imagen dentro de imagen Mantenga el texto bilingüe visible encima de las aplicaciones compatibles en lugar de obligar al usuario a consultar una pestaña de transcripción aparte.
Antes de una llamada, Palabras clave y contexto puede preparar nombres, acrónimos, términos de productos y antecedentes. Después de la sesión, la transcripción conserva el texto original y traducido, mientras que Notas de la reunión de IA Puede generar resúmenes y elementos de acción. La guía de transcripción actual indica que los resúmenes de reuniones se pueden generar en 55 idiomas.
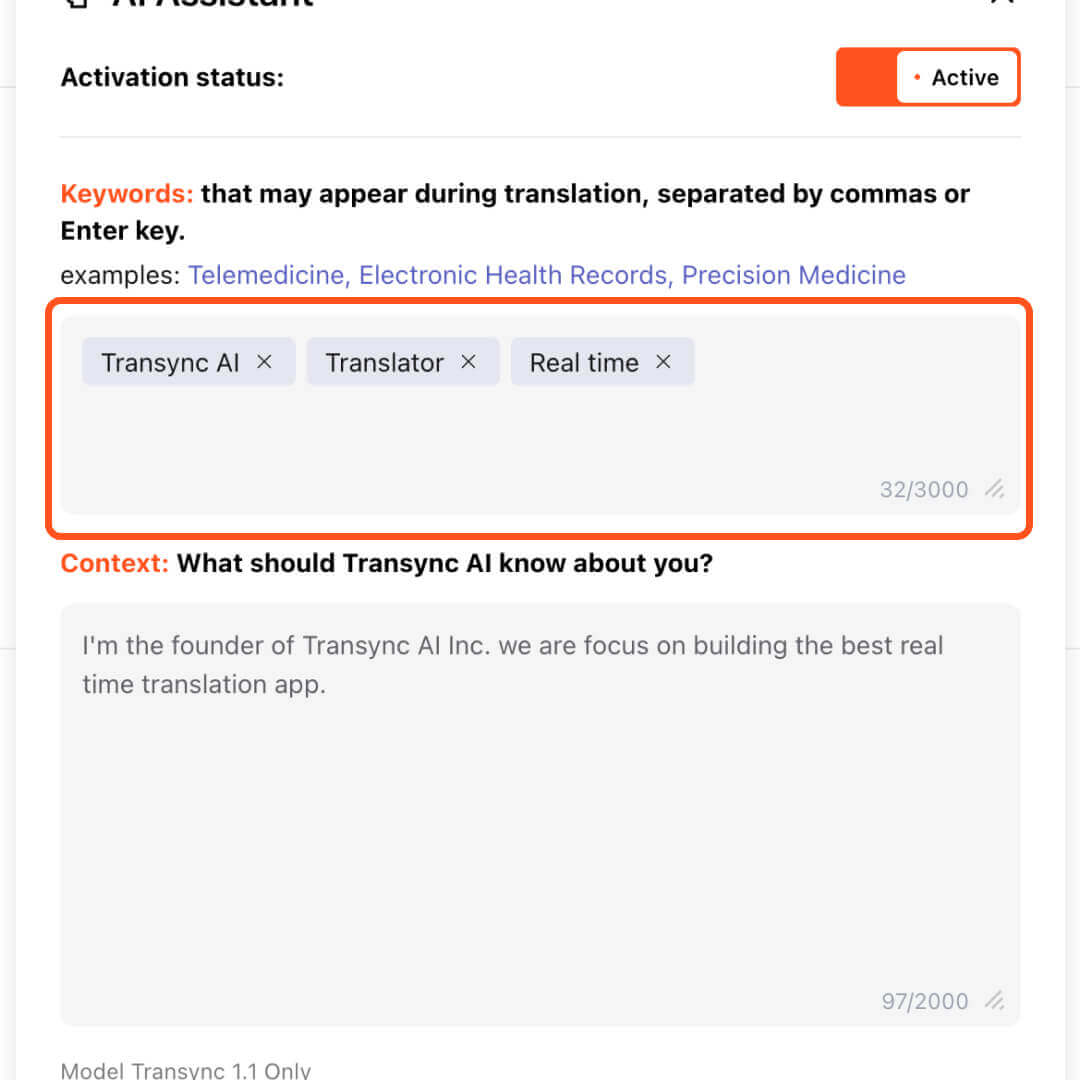
La interfaz de IA de Transync resalta el panel de activación del asistente de IA con las palabras clave "Transync AI", "Traductor" y "Tiempo real", mostrando cómo introducir palabras clave personalizadas para obtener traducciones precisas.
Elegir Transync AI Cuando el objetivo comercial es comprender y responder en diferentes idiomas, se recomienda usar una API de transmisión. En cambio, cuando el equipo esté desarrollando su propio agente de voz, plataforma de análisis de llamadas, producto de accesibilidad o interfaz de transcripción integrada, se debe optar por una API de transmisión.
La limitación es importante: Transync AI No se trata de un motor de dictado sin conexión genérico ni de un punto final STT para desarrolladores. El enrutamiento de audio, la calidad de la red, los pares de idiomas, los micrófonos y la entrega remota deben probarse antes de una reunión importante.
Ruta 2: Utilice Deepgram cuando la sincronización de los giros forme parte del producto.
Deepgram Resulta especialmente instructivo para los desarrolladores porque su documentación separa los resultados intermedios, los segmentos finalizados, los puntos finales de voz detectados y los eventos de finalización de la locución. Esta separación permite que una aplicación decida cuándo mostrar texto, añadir texto estable o activar una respuesta.
Explorar la transmisión de Deepgram
Usar Deepgram Cuando el equipo de producto necesita ajustar el comportamiento conversacional en lugar de aceptar una interfaz de subtítulos fija, el equipo sigue siendo responsable del transporte de audio, la gestión del estado, la representación parcial del texto, el almacenamiento, la autenticación, los permisos, las correcciones y la experiencia final del usuario.
Un error común en la implementación consiste en guardar solo la última respuesta o esperar únicamente al final del discurso. Las directrices oficiales explican que una locución larga puede contener varios segmentos de transcripción finalizados antes de que se detecte el final del discurso. La aplicación debe concatenar correctamente los segmentos finales.
Ruta 3: Utilice AssemblyAI cuando las etiquetas de los oradores en la transmisión sean importantes.
EnsamblajeAI Proporciona modelos de transmisión con transcripciones parciales y finales, puntos finales, sugerencias de términos clave, marcas de tiempo de palabras y modos de diarización de hablantes compatibles. Su documentación también describe eventos de revisión de hablantes: el modelo puede corregir etiquetas de hablantes anteriores a medida que recopila más información.
El comportamiento de las revisiones es crucial en las interfaces en tiempo real. Si una aplicación marca a "Orador A" como permanente demasiado pronto, las correcciones posteriores podrían no llegar al registro guardado. La interfaz de usuario necesita una estrategia bien definida para las etiquetas y revisiones pendientes.
Elegir EnsamblajeAI Cuando la transmisión con reconocimiento de voz y el control a nivel de aplicación son importantes, confirme el modelo exacto, la compatibilidad con idiomas, el comportamiento de la diarización, las opciones médicas y los requisitos de datos para la implementación prevista; las características varían según el modelo de transmisión.
Ruta 4: Utilice Soniox para API de transmisión multilingüe
Soniox Combina la transcripción y traducción en tiempo real a través de su API WebSocket. La interfaz actual admite sugerencias de idioma, personalización del contexto, registro de hablantes, configuración de traducción, marcas de tiempo a nivel de token, nivel de confianza, estado de finalización e información de idioma.
Esto hace que Soniox relevante cuando los desarrolladores quieren Conversión de voz a texto en tiempo real y salida multilingüe dentro de su propia aplicación. La configuración del contexto puede ayudar con los términos de dominio, pero debe probarse con un script de terminología fijo en lugar de asumirlo a partir del nombre de la función.
Al igual que con las demás API, el servicio devuelve componentes básicos. El comprador debe seguir configurando el acceso de los participantes, las correcciones, la retención, las exportaciones, los resúmenes, los controles administrativos, la monitorización, la recuperación de errores y el soporte.
Por qué la tasa de error de palabras no es suficiente
La tasa de errores de palabras mide las sustituciones, eliminaciones e inserciones con respecto a una transcripción de referencia. Es útil, pero un solo promedio puede ocultar los errores más importantes.
Compare estos dos errores:
- “Podemos realizar envíos en Jueves” se convierte en “Podemos enviar en Martes.”
- “Por favor, abra el panel de configuración” se convierte en “Por favor, abra un panel de configuración.”
Ambos pueden contabilizarse de forma similar, pero el primero modifica un compromiso. Cree un libro mayor de errores para:
- Nombres e identidad de los hablantes.
- Números, monedas, fechas y unidades.
- Negaciones y condiciones.
- Nombres de productos y terminología especializada.
- Cambio de código y cambios lingüísticos.
- Interrupciones y autocorrecciones.
- Signos de puntuación que cambian de significado.
Luego, hay que considerar el factor tiempo. Una palabra correcta pronunciada después de que se haya tomado la decisión puede ser incorrecta desde el punto de vista operativo. Un error provisional corregido posteriormente aún podría haber provocado que un agente de voz o un participante actuara.
El derecho Conversión de voz a texto en tiempo real Por lo tanto, la puntuación combina la gravedad del error fáctico, la estabilidad, el momento de la intervención y la forma de expresarse, y no simplemente la precisión media de las palabras.
La cinta de la verdad de dos minutos
Utilice una única fuente de audio grabada para que todos los candidatos reciban la misma señal. No permita que cada proveedor elija su propia demostración.
Guion
- “Hola, soy Niamh O'Rourke de Aster-Q.”
- “La referencia es BX-417, no BX-471.”
- “Los ingresos fueron de 15,05 millones de dólares, un 13,6 por ciento más.”
- “No renueve a menos que se haya firmado el acuerdo de nivel de servicio.”
- “Enviaremos quince —perdón, cincuenta— unidades el jueves.”
- “La API utiliza transmisión WebSocket y un punto final de 300 milisegundos.”
- Haz una pausa de 700 milisegundos en medio de una oración condicional.
- Deje que una segunda persona interrumpa y luego retome la palabra al primer orador.
- Añade una frase en el segundo idioma requerido.
- Finaliza con una frase en voz baja mientras se oye el sonido de un teclado.
Hoja de captura
| Medición | Cómo grabarlo | Pasar la condición a definir antes de realizar la prueba. |
|---|---|---|
| Hora del primer mensaje de texto | El audio comienza con la primera hipótesis no vacía. | En función de la necesidad del usuario de recibir retroalimentación visual. |
| Tiempo para estabilizar el texto | Última palabra pronunciada al texto final inmutable | Lo suficientemente rápido como para que la gente no actúe en consecuencia. |
| retraso de finalización del turno | Fin del giro previsto al evento de punto final o desencadenador de respuesta | No interrumpe las pausas normales ni da sensación de falta de respuesta. |
| Número de revisiones | Número de cambios de hipótesis visibles o a nivel de API | La interfaz sigue siendo legible y las acciones posteriores esperan a que se complete. |
| Errores críticos de hecho | Nombres, cifras, negaciones, fechas, unidades y condiciones | Cero errores graves no detectados en el piloto |
| recuperación de etiquetas de oradores | Tiempo y corrección después de la interrupción | La transcripción almacenada refleja la atribución corregida. |
| Finalización del flujo de trabajo | Fin de la reunión para la acción de búsqueda/exportación de registros o aplicaciones. | Se ajusta al plazo operativo |
Realice diez ensayos y, a continuación, registre la mediana, el percentil 95 y el peor resultado observado, siempre que la muestra lo permita. Un solo ensayo perfecto no garantiza la fiabilidad.
Siete modos de fallo y la primera solución
| Síntoma | Capa probable | Primera comprobación útil |
|---|---|---|
| El texto aparece tarde desde la primera palabra. | Captura, almacenamiento en búfer, codificación, red o modelo | Medir cada salto; reducir los fragmentos de audio demasiado grandes. |
| El texto aparece rápidamente, pero se reescribe mucho. | Comportamiento de la hipótesis provisional | Espere a que se confirme la resolución antes de activar las acciones; rediseñe la visualización provisional. |
| El sistema corta las voces de quienes están pensando | Detección de umbral de punto final o actividad de voz | Pruebe pausas más largas y ajuste el punto final cuando esté disponible. |
| El sistema espera demasiado tiempo después de recibir comandos cortos. | Lógica de umbral de punto final o de giro de la aplicación | Prueba con umbrales más cortos o controles explícitos al final del turno. |
| Los nombres y los códigos fallan repetidamente | Ambigüedad acústica y falta de contexto de dominio | Agregue términos/contexto clave y mejore la calidad del micrófono. |
| Las etiquetas de los altavoces cambian después de la visualización. | La diarización en tiempo real está revisando los clústeres. | Admite etiquetas pendientes y aplica eventos de revisión al registro. |
| La transcripción es rápida pero posteriormente resulta inutilizable. | Flujo de trabajo del producto faltante | Agregue corrección, almacenamiento, búsqueda, permisos, exportación y eliminación, o elija una aplicación terminada. |
Solución de problemas Conversión de voz a texto en tiempo real De izquierda a derecha. Reemplazar el modelo no solucionará una entrada silenciada, una frecuencia de muestreo incorrecta ni una interfaz de usuario que guarda texto provisional como final.
Cuando la conversión de voz a texto no es el trabajo final
La transcripción responde a la pregunta: "¿Qué palabras se reconocieron?". La traducción responde a la pregunta: "¿Qué significan esas palabras en otro idioma?". Un documento de reunión también debe responder a la pregunta: "¿Puede la otra persona comprender, responder y recordar la decisión posteriormente?".“
Si todos hablan el mismo idioma y necesitan subtítulos, dictado, búsqueda o análisis de accesibilidad, una API de transcripción o un producto de transcripción dedicado pueden ser suficientes. Si los participantes usan idiomas diferentes, el flujo de trabajo necesita controles adicionales:
- El texto original se muestra junto a la traducción.
- Selección de idioma o gestión automática.
- Preparación de la terminología y el contexto.
- Texto en el idioma meta pronunciado durante la conversación.
- Voz traducida opcional cuando la lectura no sea práctica.
- Registros y notas que preservan el debate multilingüe.
Este es el punto donde Conversión de voz a texto en tiempo real se convierte en un componente del más grande Transync AI flujo de trabajo más que producto final.
Preguntas frecuentes sobre conversión de voz a texto en tiempo real
¿Qué es la conversión de voz a texto en tiempo real?
Conversión de voz a texto en tiempo real Convierte el audio en tiempo real en texto provisional y finalizado mientras se reproduce el habla. El sistema puede revisar las hipótesis iniciales a medida que recibe más contexto, detecta el final de una intervención, aplica la puntuación o mejora la identificación del hablante.
¿Cuánto retraso se considera tiempo real?
No existe un umbral único. Se mide el tiempo hasta la primera aparición del texto, la estabilidad del texto, la finalización del turno y la utilidad del flujo de trabajo. Un lector de subtítulos, un agente de voz, un participante en una reunión y un revisor posterior a la llamada tienen diferentes niveles de retraso aceptables.
¿Por qué cambia constantemente el texto en tiempo real?
Los reconocedores de audio en tiempo real publican hipótesis parciales antes de que la oración esté completa. El audio posterior puede modificar la redacción, la puntuación, el idioma o el hablante más probables. Las aplicaciones deben distinguir los resultados provisionales del texto finalizado.
¿La conversión de voz a texto en tiempo real es lo mismo que la traducción en directo?
No. La función de reconocimiento de voz a texto reconoce las palabras habladas en el idioma de origen. La traducción en vivo añade otra transformación lingüística y también puede incluir la voz traducida. Transync AI Combina el reconocimiento y la traducción para conversaciones multilingües.
¿Qué API es la mejor para la conversión de voz a texto en tiempo real?
No existe un ganador universal. Deepgram ofrece controles detallados de puntos finales y estado de resultados, EnsamblajeAI ofrece comportamiento de revisión y diarización de transmisión compatible, y Soniox Combina opciones de transcripción y traducción multilingües. Pruebe cada una con el mismo audio y los requisitos exactos del producto.
¿Puede la conversión de voz a texto en tiempo real identificar a los hablantes?
Algunos modelos admiten la diarización o la entrada multicanal, pero las etiquetas pueden ser provisionales y cambiar a medida que llega más audio. Pruebe las interrupciones, las voces similares, los cambios de dispositivo y las correcciones de etiquetas almacenadas.
¿Qué debería probar primero una empresa?
Comience con la ruta de audio real y un guion de dos minutos que contenga nombres, números, negaciones, correcciones, pausas, interrupciones, terminología y los idiomas requeridos. Mida los cuatro relojes e inspeccione el registro guardado.
Veredicto final
El más rápido Conversión de voz a texto en tiempo real El sistema no es necesariamente el que muestra la primera palabra primero. Un sistema confiable equilibra cuatro relojes:
primer texto → texto estable → turno completado → registro utilizable
Elija una API de transmisión cuando los desarrolladores necesiten controlar la asignación de puntos finales, los resultados parciales, las revisiones de los oradores y el comportamiento de la aplicación. Elija un producto de reunión completo cuando el equipo necesite el flujo completo, desde el audio hasta los subtítulos, la traducción, las grabaciones y las notas, sin tener que construir esa infraestructura.
Lo más importante es probar la entrada real y la consecuencia real. Mida la palabra que aparece, la palabra que cambia, el turno que termina y el registro en el que alguien confiará después.