การแปลงเสียงพูดเป็นข้อความแบบเรียลไทม์นั้นไม่ใช่แค่การแสดงคำบรรยายที่รวดเร็วเท่านั้น ควรพิจารณาตัวชี้วัดต่างๆ เช่น นาฬิกาที่ซ่อนอยู่ 4 ตัว การแก้ไข การจัดการผู้พูด และความเหมาะสมสำหรับการประชุมหลายภาษา ก่อนที่จะเลือกใช้.
การแปลงเสียงพูดเป็นข้อความแบบเรียลไทม์อาจดูดีเยี่ยมในการสาธิต แต่ก็อาจล้มเหลวในการสนทนาจริง คำแรกอาจปรากฏขึ้นใน 300 มิลลิวินาที แต่ประโยคอาจเปลี่ยนแปลงไปเรื่อยๆ เป็นเวลาสองวินาที อาจมีการระบุผู้พูดแล้วแก้ไข หรืออาจถอดเสียงเสร็จเร็ว แต่กลับละเว้นคำปฏิเสธที่เปลี่ยนการตัดสินใจไป.
นั่นคือเหตุผลว่าทำไม “เร็วแค่ไหน?” จึงเป็นคำถามแรกที่ไม่ถูกต้อง การประเมินผลที่มีประสิทธิภาพต้องอาศัยตัวชี้วัดสี่อย่าง ได้แก่ เวลาถึงข้อความแรก เวลาที่ข้อความคงที่ เวลาที่ใช้ในการตอบเสร็จสมบูรณ์ และเวลาที่ใช้ในการบันทึกข้อมูลที่ใช้งานได้ ตัวชี้วัดแต่ละตัวตอบสนองความต้องการในการปฏิบัติงานที่แตกต่างกัน.
บทความนี้กล่าวถึง แปลงเสียงเป็นข้อความแบบเรียลไทม์ โดยนำเสนอในรูปแบบของกระบวนการทำงานที่วัดผลได้ แทนที่จะเป็นเพียงผลลัพธ์ทางภาพ บทความนี้เปรียบเทียบ API สตรีมมิ่งเฉพาะทางกับผลิตภัณฑ์การประชุมหลายภาษาที่พร้อมใช้งาน มีสคริปต์ทดสอบที่ทำซ้ำได้ และอธิบายว่าเมื่อใดที่การถอดเสียงเพียงอย่างเดียวไม่เพียงพอ เนื่องจากผู้เข้าร่วมจำเป็นต้องมีการแปล การออกเสียง หรือบันทึกเพิ่มเติม.
คำตอบใน 60 วินาที
แปลงเสียงเป็นข้อความแบบเรียลไทม์ แปลงสตรีมเสียงสดเป็นข้อความขณะที่ผู้พูดกำลังพูดอยู่ ข้อความที่แสดงมักจะเป็นข้อความชั่วคราว คำแรกๆ สามารถแก้ไขได้เมื่อโมเดลได้รับบริบทเพิ่มเติม ตรวจจับการหยุดชั่วคราว ระบุผู้พูด ใส่เครื่องหมายวรรคตอน หรือสรุปประโยค.
นาฬิกาทั้งสี่เรือนได้แก่:
- ความล่าช้าของข้อความแรก: ต้องใช้เวลานานแค่ไหนกว่าจะมีสมมติฐานใดๆ ปรากฏขึ้น?
- ความหน่วงของความเสถียร: อีกนานแค่ไหนกว่าคำเหล่านั้นจะหยุดเปลี่ยนแปลง?
- ความล่าช้าในการสิ้นสุดเทิร์น: ระบบจะตัดสินว่าการพูดหรือประโยคนั้นจบลงเมื่อไร ต้องใช้เวลานานแค่ไหน?
- ความล่าช้าของเวิร์กโฟลว์: ต้องใช้เวลานานแค่ไหนจึงจะสามารถนำเอกสารถอดเสียงไปใช้ในการค้นหา บันทึก ดำเนินการ แปล หรือตอบใบสมัครได้?
ระบบตอบรับอัตโนมัติด้วยเสียงอาจให้ความสำคัญกับความแน่นอนของการพูด เพราะต้องตัดสินใจว่าจะตอบเมื่อใด คำบรรยายเพื่อการเข้าถึงอาจให้ความสำคัญกับข้อความบางส่วนที่อ่านได้รวดเร็ว การบันทึกการประชุมอาจยอมรับการแสดงผลที่ช้าลงเล็กน้อยได้ หากชื่อ หมายเลข และการระบุผู้พูดมีความน่าเชื่อถือมากขึ้น การประชุมหลายภาษาเพิ่มขั้นตอนอีกขั้นหลังจากระบบจดจำเสียงแล้ว นั่นคือ การแปลต้องมาถึงเร็วพอที่จะให้มีคนตอบกลับได้.
การแปลงเสียงพูดเป็นข้อความแบบเรียลไทม์เป็นสมมติฐานที่กำลังพัฒนาอยู่
การถอดเสียงสดไม่ได้ทำเสร็จในขั้นตอนเดียว:
ไมโครโฟนหรือเสียงระบบ → การเข้ารหัสและการส่ง → การตรวจจับเสียงพูด → การรับรู้เบื้องต้น → การแก้ไข → การทำให้เสร็จสมบูรณ์ → การติดป้ายและการจัดรูปแบบผู้พูด → การดำเนินการของแอปพลิเคชัน
โดยปกติแล้วหน้าจอจะแสดงเฉพาะส่วนตรงกลางเท่านั้น ซึ่งทำให้เกิดความเข้าใจผิดทั่วไป คือ เนื่องจากข้อความปรากฏขึ้นทันที ผู้ใช้จึงคิดว่าผลลัพธ์เสร็จสมบูรณ์แล้ว ในความเป็นจริงแล้ว เครื่องมือค้นหาอาจยังคงพิจารณาขอบเขตของคำ เครื่องหมายวรรคตอน ภาษา หรือตัวตนของผู้พูดอยู่.
API เฉพาะทางจะทำให้ความแตกต่างนี้ชัดเจนยิ่งขึ้น. ดีพแกรม ฟังก์ชันนี้จะแสดงผลลัพธ์ชั่วคราวและผลลัพธ์สุดท้ายแยกกัน เอกสารประกอบอธิบายว่าข้อความเบื้องต้นสามารถเปลี่ยนแปลงได้ ในขณะที่ส่วนที่เสร็จสมบูรณ์แล้วควรนำมาต่อกันเพื่อสร้างประโยคที่สมบูรณ์ สัญญาณสิ้นสุดการพูดที่แยกต่างหากจะบ่งชี้ว่าระบบตรวจพบจุดสิ้นสุด เช่น การหยุดชั่วคราว.
โซนิอ็อกซ์ แสดงโทเค็นสุดท้ายและโทเค็นที่ไม่ใช่สุดท้าย การประทับเวลา ความมั่นใจ ข้อมูลภาษา ป้ายกำกับผู้พูด (ถ้ามี) และความคืบหน้าในการประมวลผลผ่านการเชื่อมต่อสตรีมมิ่งแบบต่อเนื่อง. แอสเซมบลีไอ ในทำนองเดียวกัน โปรแกรมนี้ยังมีฟีเจอร์ต่างๆ เช่น การถอดเสียงบางส่วนและถอดเสียงทั้งหมด การระบุจุดสิ้นสุด การประทับเวลาในระดับคำ การแจ้งเตือนคำสำคัญ และการแยกแยะผู้พูดแบบเรียลไทม์ในโมเดลที่รองรับ.
การควบคุมเหล่านั้นมีประโยชน์สำหรับนักพัฒนา และยังแสดงให้เห็นว่าทำไมผู้ใช้ปลายทางไม่ควรตัดสิน แปลงเสียงเป็นข้อความแบบเรียลไทม์ พิจารณาจากเส้นแรกที่มองเห็นได้เพียงอย่างเดียว.
นาฬิกาเรือนที่ 1: เวลาถึงข้อความแรก
นาฬิกาเรือนแรกจะเริ่มทำงานเมื่อเสียงพูดเข้าสู่ระบบ และจะหยุดเมื่อสมมติฐานที่ไม่ว่างเปล่าข้อแรกปรากฏให้เห็นหรือพร้อมใช้งานสำหรับแอปพลิเคชัน.
การวัดนี้ครอบคลุมมากกว่าแค่การอนุมานแบบจำลอง:
- การบันทึกเสียงจากไมโครโฟนหรือการประชุม.
- ขนาดบัฟเฟอร์และการแบ่งส่วนเสียง.
- การสุ่มตัวอย่างใหม่หรือการเข้ารหัส.
- การขนส่งผ่านเครือข่าย.
- กำลังประมวลผลเซิร์ฟเวอร์.
- บริการขนส่งกลับ.
- การแสดงผลอินเทอร์เฟซ.
วัด แปลงเสียงเป็นข้อความแบบเรียลไทม์ วัดจากอุปกรณ์ของผู้ใช้จริง ไม่ใช่จากแดชบอร์ด API ตัวเลขฝั่งเซิร์ฟเวอร์ของผู้ให้บริการอาจไม่รวมถึงเวลาในการบัฟเฟอร์เสียง การเชื่อมต่อเครือข่ายของไคลเอ็นต์ การแสดงผลของเบราว์เซอร์ และความล่าช้าของแพลตฟอร์มการประชุมเอง.
ข้อความที่แสดงอย่างรวดเร็วในตอนแรกนั้นมีประโยชน์เมื่อผู้ใช้ต้องการความมั่นใจว่าระบบกำลังรับฟังอยู่ แต่จะมีประโยชน์น้อยลงเมื่ออินเทอร์เฟซกระตุ้นให้ผู้ใช้ดำเนินการกับคำที่ไม่มั่นคง การออกแบบคำบรรยายที่ดีจะช่วยแยกแยะข้อความชั่วคราวได้อย่างชัดเจนโดยไม่ทำให้ข้อความอ่านยาก.
วิธีการทดสอบนาฬิกาเรือนแรก
บันทึกเสียงและภาพหน้าจอเดียวกันที่ 60 เฟรมต่อวินาที ปรบมือหนึ่งครั้ง จากนั้นพูดว่า “การต่ออายุไม่ได้รับการอนุมัติ” ทำเครื่องหมายเฟรมที่รูปคลื่นเสียงหรือเสียงปรบมือตรงกับสัญญาณอินพุต และเฟรมที่ข้อความแรกปรากฏขึ้น ทำซ้ำสิบครั้ง และรายงานค่ามัธยฐานและผลลัพธ์ที่ช้าที่สุด ไม่ใช่ผลลัพธ์ที่ดีที่สุด.
ทดสอบ แปลงเสียงเป็นข้อความแบบเรียลไทม์ ภายใต้สภาวะ Wi-Fi ปกติ เครือข่ายที่แออัด แล็ปท็อปที่ใช้ระบบตัดเสียงรบกวน และหูฟังหรือไมโครโฟนในห้อง ความเร็วในการพิมพ์ข้อความที่ลดลงเมื่อใช้งานในสภาวะปกติ ไม่ใช่คุณสมบัติที่เชื่อถือได้ของผลิตภัณฑ์.
นาฬิกาเรือนที่ 2: เวลาที่ข้อความจะเสถียร
นาฬิกาตัวที่สองจะหยุดเมื่อข้อความช่วงนั้นจะไม่เปลี่ยนแปลงอีกต่อไป นี่คือนาฬิกาที่การสาธิตทางการตลาดส่วนใหญ่ซ่อนไว้.
ลองพิจารณาคำพูดต่อไปนี้:
“จัดส่งสินค้าจำนวนสิบห้า—ขออภัย ห้าสิบ—หน่วยในวันพฤหัสบดี”
หน้าจอแสดงผลอาจแสดงข้อความ “เรือลำที่ 15” จากนั้น “เรือลำที่ 50” แล้วจึงมีการแก้ไขด้วยเครื่องหมายวรรคตอน เวอร์ชันแรกมาถึงอย่างรวดเร็ว แต่มีเพียงเวอร์ชันสุดท้ายเท่านั้นที่ปลอดภัยสำหรับการคัดลอกลงในใบสั่งซื้อ.
ความเสถียรเป็นสิ่งสำคัญ เพราะระบบปลายทางอาจตอบสนองเร็วเกินไป ระบบสรุปข้อมูลแบบเรียลไทม์ ผู้ช่วยฝ่ายขาย ตัวกระตุ้นการปฏิบัติตามกฎระเบียบ เลเยอร์การแปล หรือตัวแทนเสียง อาจได้รับข้อผิดพลาดชั่วคราวมาด้วย แปลงเสียงเป็นข้อความแบบเรียลไทม์ ตามหลักการทำงาน นักพัฒนาควรประมวลผลสัญญาณความสมบูรณ์ของเอนจิน แทนที่จะถือว่าการอัปเดตบางส่วนทุกครั้งเป็นการดำเนินการที่เสร็จสมบูรณ์แล้ว.
วัดระยะเวลาการแก้ไข ไม่ใช่แค่ความล่าช้า
สำหรับประโยคทดสอบแต่ละประโยค ให้บันทึกข้อมูลดังนี้:
- จำนวนเวอร์ชันชั่วคราว.
- จำนวนคำที่ถูกแทนที่หรือลบออก.
- ระยะเวลาระหว่างคำพูดสุดท้ายกับข้อความที่คงที่.
- ตรวจสอบว่าไฟล์ถอดเสียงที่บันทึกไว้สุดท้ายตรงกับการแสดงผลที่เสถียรหรือไม่.
- ไม่ว่าการดำเนินการในขั้นตอนถัดไปจะถูกกระตุ้นก่อนที่จะเกิดเสถียรภาพหรือไม่.
ช้าลงเล็กน้อย แปลงเสียงเป็นข้อความแบบเรียลไทม์ ระบบจะปลอดภัยยิ่งขึ้นหากมีการแก้ไขอย่างไม่รุนแรงเกินไป จุดสมดุลที่เหมาะสมนั้นขึ้นอยู่กับว่าผู้ใช้กำลังอ่าน บันทึกด้วยเสียง ควบคุมซอฟต์แวร์ หรือเจรจาต่อรองอยู่.
นาฬิกาเรือนที่ 3: เวลาที่เหลือจนครบหนึ่งรอบ
คำพูดอาจจบลงแล้ว แม้ว่าตาพูดจะยังไม่จบก็ตาม บุคคลอาจหยุดคิด หายใจ ค้นหาตัวเลข หรือรอให้มีการขัดจังหวะ หากระบบประกาศว่าตาพูดจบเร็วเกินไป ระบบตอบรับอัตโนมัติอาจพูดแทรกผู้ใช้ หากรอช้าเกินไป การสนทนาจะดูไม่ตอบสนอง.
โดยทั่วไป การกำหนดจุดสิ้นสุดจะใช้ความเงียบหรือการเคลื่อนไหวของเสียงเพื่อบ่งชี้ว่าการพูดได้สิ้นสุดลงแล้ว. ดีพแกรม เอกสารการกำหนดค่าปลายทางและแยกต่างหาก คือขั้นสุดท้าย และ สุนทรพจน์สุดท้าย คำแนะนำระบุว่า เกณฑ์เวลาสั้นๆ เหมาะสำหรับคำตอบสั้นๆ ของแชทบอท ในขณะที่ช่วงหยุดสนทนาที่ยาวนานกว่าอาจต้องใช้เวลาหลายร้อยมิลลิวินาทีจึงจะถือว่าการสนทนาเสร็จสมบูรณ์.
ไม่มีรูปแบบการพูดใดที่ใช้ได้กับผู้พูดทุกคน การพูดเร็วในศูนย์บริการลูกค้า การซักประวัติทางการแพทย์ที่ลังเล การบรรยายในห้องเรียน และการเจรจาแบบสองภาษา ล้วนมีรูปแบบการหยุดพูดที่แตกต่างกัน ดังนั้น ความชัดเจนของการจบการสนทนาจึงเป็นหัวใจสำคัญ แปลงเสียงเป็นข้อความแบบเรียลไทม์ การวัดผล ไม่ใช่แค่การตั้งค่า API เท่านั้น.
ทำการทดสอบการลังเล
ใช้บรรทัดทั้งสี่นี้:
- “หมายเลขบัญชีของฉันคือ … 4172”
- “ฉันเห็นด้วย…หากกำหนดส่งมอบยังคงเป็นวันศุกร์”
- “ปริมาณยาคือสิบห้า—ไม่สิ ห้าสิบ—มิลลิกรัม”
- “อนา คุณช่วย—” ตามด้วยเสียงพูดแทรกจากผู้พูดคนที่สอง.
นับจำนวนการจบประโยคที่ไม่ถูกต้อง การสิ้นสุดประโยคที่ล่าช้า การขัดจังหวะ และคำที่ถูกตัดทอน จากนั้นปรับค่าเกณฑ์การสิ้นสุดประโยคเฉพาะในกรณีที่แอปพลิเคชันเปิดเผยข้อมูลนั้น หากผลิตภัณฑ์เป็นแอปพลิเคชันที่เสร็จสมบูรณ์แล้ว ให้สังเกตพฤติกรรมและตัดสินใจว่าเหมาะสมกับงานหรือไม่.
นาฬิกาเรือนนี้คือที่ไหน แปลงเสียงเป็นข้อความแบบเรียลไทม์ กลายเป็นการออกแบบบทสนทนาเชิงสร้างสรรค์มากกว่าการถอดเสียงแบบธรรมดา.
นาฬิกาเรือนที่ 4: เวลาที่ใช้ในการบันทึกข้อมูล
นาฬิกาเรือนที่สี่มีความสำคัญที่สุดสำหรับทีม มันจะหยุดลงเมื่อผลลัพธ์สามารถสนับสนุนการดำเนินการต่อไปได้.
“คำว่า ”ใช้งานได้” อาจหมายถึง:
- คำบรรยายยังคงอ่านได้ชัดเจนตลอดการบรรยาย.
- สามารถระบุตัวตนของผู้พูดได้.
- ชื่อ ตัวเลข และคำศัพท์ต่างๆ สามารถแก้ไขได้.
- สามารถคัดลอกหรือส่งออกเอกสารถอดเสียงฉบับสมบูรณ์ได้.
- สามารถค้นหาข้อมูลได้และได้รับอนุญาตแล้ว.
- ระบบจะสร้างบทสรุปและรายการดำเนินการ.
- ข้อความต้นฉบับและข้อความที่แปลแล้วจะยังคงอยู่คู่กัน.
- การเก็บรักษาและการลบข้อมูลเป็นสิ่งที่เข้าใจได้.
ระบบอาจชนะสามรอบแรกและแพ้ในรอบที่สี่ ข้อมูล JSON ดิบที่ส่งมาแบบสตรีมมิ่งไม่ใช่บันทึกการประชุม คำบรรยายที่หายไปอย่างรวดเร็วไม่ใช่หลักฐาน บทสรุปที่สวยงามแต่ไม่มีบันทึกถอดเสียงที่ตรวจสอบได้อาจปกปิดข้อผิดพลาดในการจดจำ นี่คือเหตุผล แปลงเสียงเป็นข้อความแบบเรียลไทม์ ฝ่ายจัดซื้อต้องวัดผลทั้งกระบวนการทำงานที่เสร็จสมบูรณ์และรูปแบบการทำงานแบบสตรีมมิ่ง.
แปลงเสียงเป็นข้อความแบบเรียลไทม์ ดังนั้น ควรประเมินผล ณ จุดใช้งาน ไม่ใช่ ณ จุดสร้าง ขอให้ผู้เข้าร่วม ผู้ตรวจสอบ ผู้พัฒนา และผู้ดูแลระบบ ทดสอบเซสชันเดียวกันจากมุมมองของตนเอง.
สี่เส้นทางเปรียบเทียบโดยนาฬิกาทั้งสี่เรือน
| ผลิตภัณฑ์ | ประเภทผลิตภัณฑ์ | ข้อความแรก | การควบคุมเสถียรภาพและความสมบูรณ์ | การจัดการลำโพง | บทบาทหลายภาษา | ขั้นตอนการทำงานของบันทึกที่ใช้งานได้ | เหมาะสมที่สุด |
|---|---|---|---|---|---|---|---|
| Transync เอไอ | แอปแปลการประชุมพร้อมใช้งาน | จอแสดงผลสองภาษาแบบสด | จัดการโดยตัวผลิตภัณฑ์เอง แทนที่จะเปิดเผยเป็นพารามิเตอร์ API | ระบบจะแยกแยะคู่ภาษาที่เลือกโดยอัตโนมัติ และตรวจสอบทั้งในรูปแบบข้อความต้นฉบับและข้อความที่แปลแล้ว | 60 ภาษา, คำบรรยายสองภาษา, เสียงพากย์แปล | บันทึกการแปล บันทึกถอดเสียง และสรุปการประชุมด้วย AI | บุคคลและทีมที่ต้องการการสื่อสารข้ามภาษาแบบเรียลไทม์โดยไม่ต้องสร้างแอปพลิเคชัน |
| ดีพแกรม | API แปลงเสียงเป็นข้อความแบบสตรีมมิ่ง | สามารถเปิดใช้งานผลลัพธ์ระหว่างกาลได้ | แสดงผลลัพธ์ระหว่างกาล/สุดท้าย การกำหนดจุดสิ้นสุด เหตุการณ์เมื่อสิ้นสุดการพูด การควบคุมเมื่อสิ้นสุดประโยค และการสรุปผลด้วยตนเอง | ตัวเลือกการแยกเสียงและการสื่อสารหลายช่องทางขึ้นอยู่กับการกำหนดค่า/รุ่น | ตัวเลือกภาษาและรูปแบบการสตรีม การแปลเป็นขั้นตอนการทำงานที่แยกต่างหาก | ลูกค้าต้องสร้างระบบจัดเก็บข้อมูล ระบบแก้ไขข้อมูล ระบบกำหนดสิทธิ์การเข้าถึง ข้อมูลสรุป และส่วนติดต่อผู้ใช้ (UI) ด้วยตนเอง | นักพัฒนาซอฟต์แวร์ที่สร้างระบบตอบรับอัตโนมัติด้วยเสียง คำบรรยาย ระบบวิเคราะห์ข้อมูลการโทร หรือผลิตภัณฑ์ถอดเสียงแบบกำหนดเอง |
| แอสเซมบลีไอ | API แปลงเสียงเป็นข้อความแบบสตรีมมิ่ง | ส่งคืนเอกสารถอดเสียงบางส่วนผ่านการเชื่อมต่อสตรีมมิ่ง | การกำหนดจุดสิ้นสุดอย่างชาญฉลาดและบันทึกการถอดเสียงขั้นสุดท้ายที่ไม่สามารถเปลี่ยนแปลงได้ พฤติกรรมเฉพาะรุ่นจะถูกนำมาใช้ | ฟังก์ชันการสตรีมเพื่อแยกเสียงผู้พูดและการแก้ไขเสียงผู้พูด สามารถใช้งานได้ในรุ่นที่รองรับ | รูปแบบการสตรีมหลายภาษารองรับชุดภาษาที่เผยแพร่แล้ว | ลูกค้าสร้างแอปพลิเคชันที่เสร็จสมบูรณ์และบันทึกวงจรชีวิตของแอปพลิเคชัน | ทีมพัฒนาผลิตภัณฑ์ที่ต้องการระบบจดจำเสียงแบบเรียลไทม์พร้อมระบบแยกเสียงพูดและระบบประมวลผลอัจฉริยะขั้นปลาย |
| โซนิอ็อกซ์ | API AI สำหรับการพูดแบบเรียลไทม์ | สตรีมโทเค็นที่ไม่ใช่โทเค็นสุดท้ายด้วยความหน่วงต่ำ | สถานะโทเค็นสุดท้าย การยืนยันโทเค็นด้วยตนเอง การประทับเวลาของโทเค็น และความคืบหน้าในการประมวลผล | ตัวเลือกการแยกแยะเสียงผู้พูด | การถอดเสียงและการแปลหลายภาษาแบบเรียลไทม์ผ่านการกำหนดค่า API | ลูกค้าสร้างอินเทอร์เฟซ การจัดเก็บข้อมูล การตรวจสอบ และการกำกับดูแล | นักพัฒนาซอฟต์แวร์ที่สร้างระบบการประชุม การออกอากาศ ผู้ช่วย หรืออินเทอร์เฟซเสียงหลายภาษา |
ข้อมูลความสามารถได้รับการตรวจสอบเทียบกับเอกสารผลิตภัณฑ์อย่างเป็นทางการเมื่อวันที่ 3 ตุลาคม 2569 รุ่น ภาษา ข้อจำกัด และราคาอาจมีการเปลี่ยนแปลงได้.
ตารางนี้ไม่ได้จัดอันดับผู้ชนะเพียงหนึ่งเดียว แต่เป็นการแยกการตัดสินใจซื้อออกเป็นสองส่วน คือ สร้างผลิตภัณฑ์โดยใช้ API สตรีมมิ่ง หรือใช้เวิร์กโฟลว์สำเร็จรูป ที่ดีที่สุด แปลงเสียงเป็นข้อความแบบเรียลไทม์ เส้นทางการดำเนินงานขึ้นอยู่กับว่าใครเป็นเจ้าของระบบบันทึกเสียง การออกแบบส่วนติดต่อผู้ใช้ การแก้ไข การจัดเก็บ และการสนับสนุน.
เส้นทางที่ 1: ใช้ AI Transync เมื่อจำเป็นต้องสื่อสารข้ามภาษา
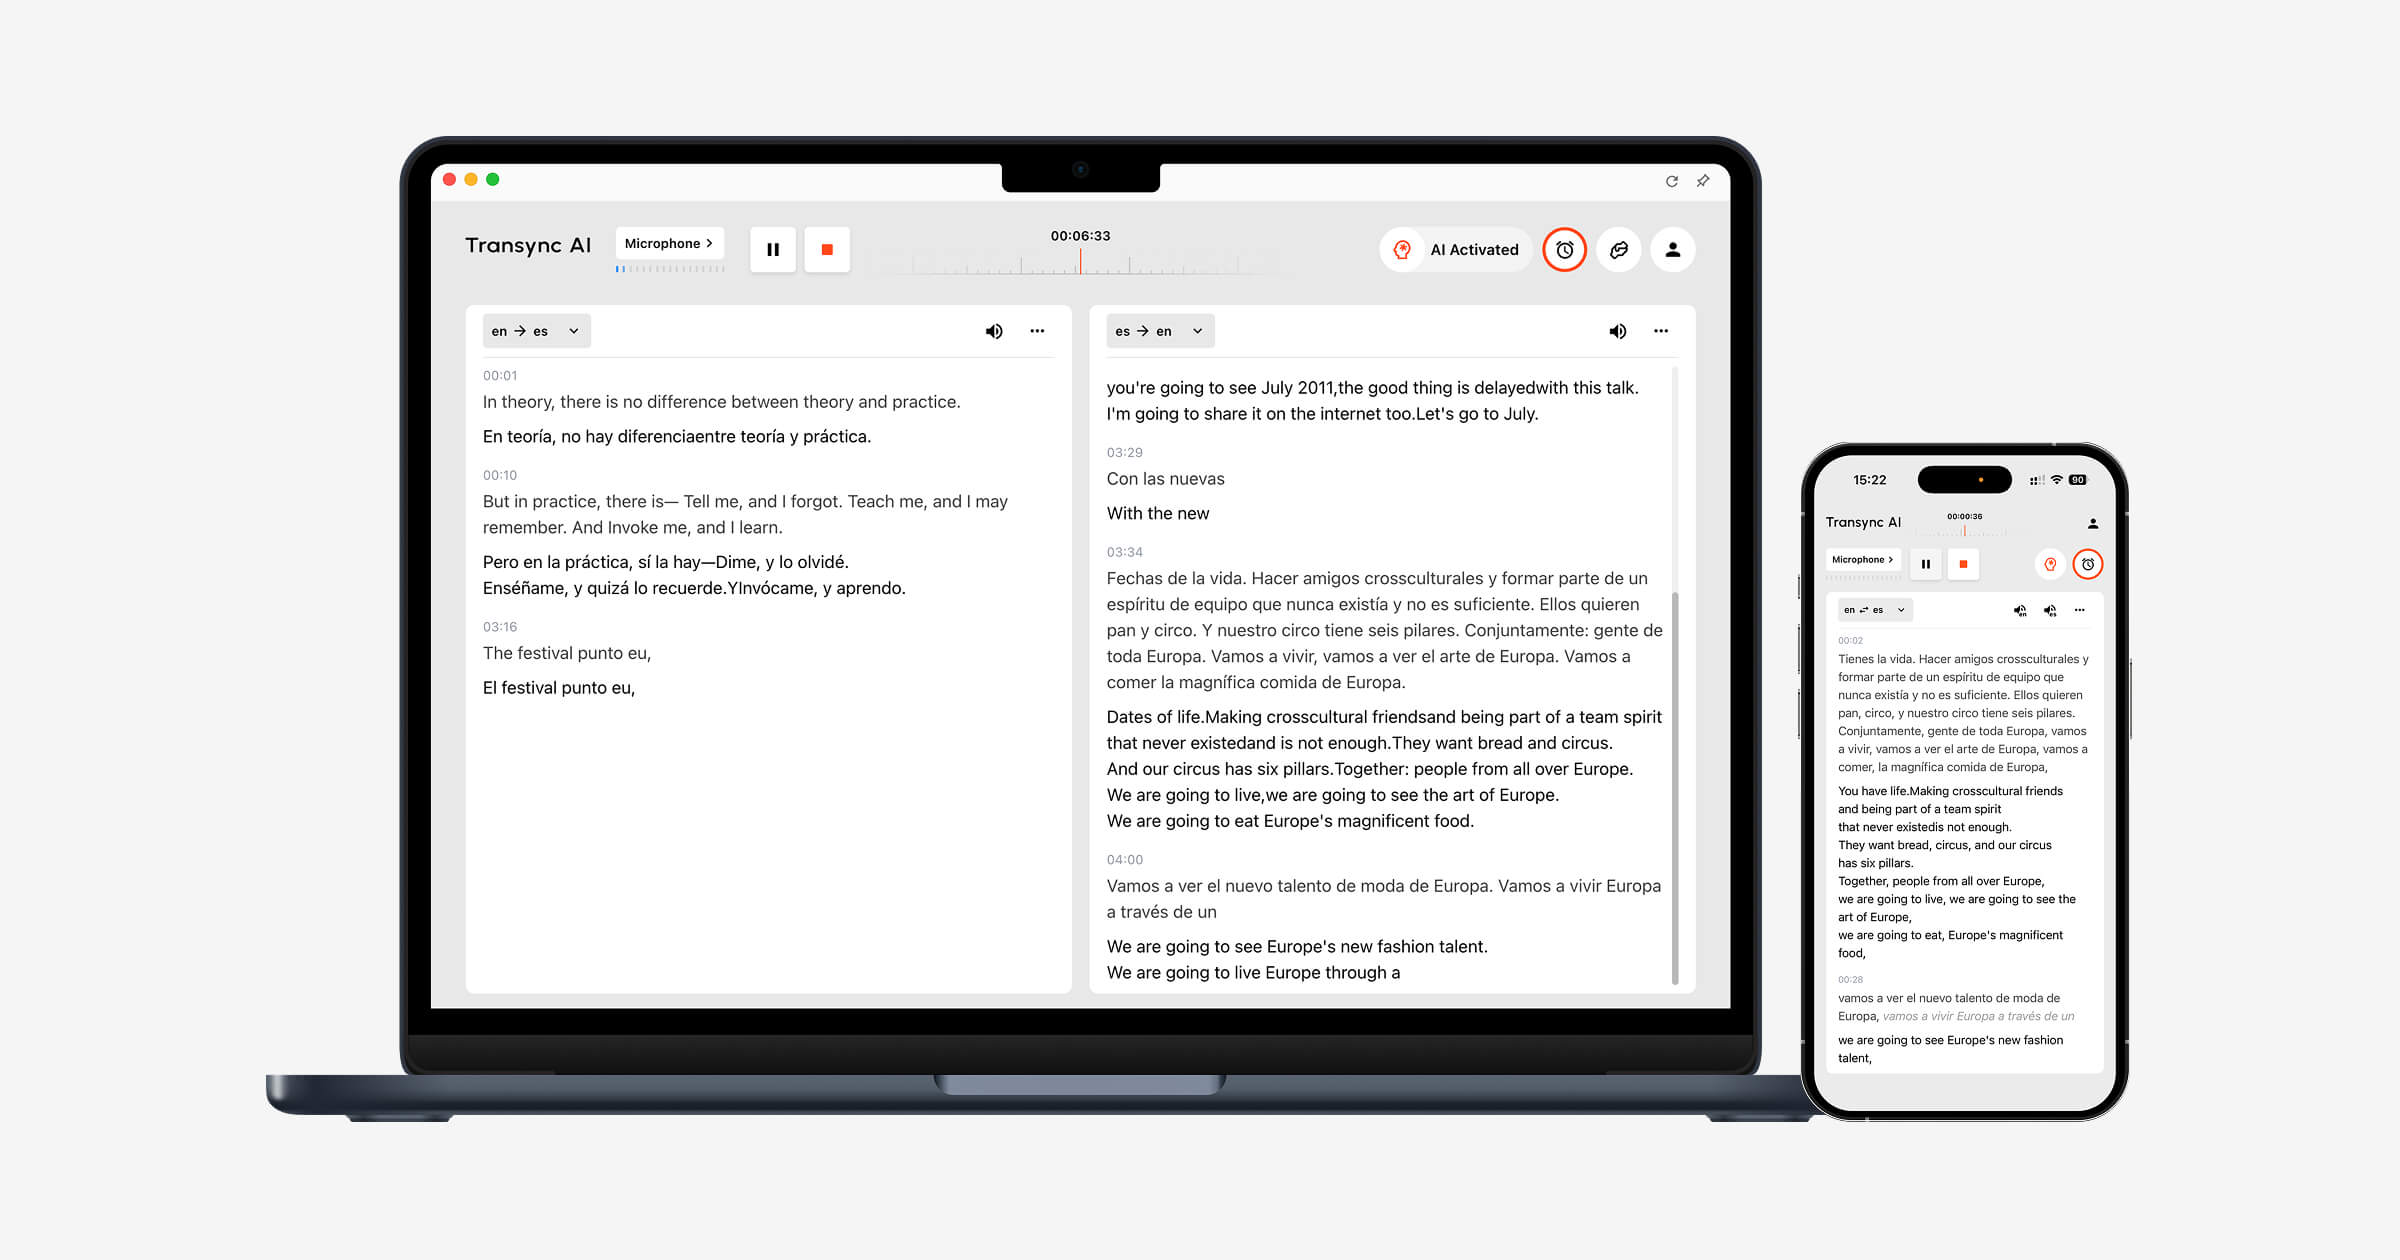
Transync เอไอ ไม่ได้จำหน่ายในฐานะ API แปลงเสียงเป็นข้อความอเนกประสงค์ แต่เป็นผลิตภัณฑ์สำหรับการประชุมและการสนทนาที่พร้อมใช้งาน ซึ่งผสานรวมการจดจำเสียงเข้ากับการแปล ขั้นตอนการทำงานการแปลแบบเรียลไทม์ รองรับ 60 ภาษา และคงเสียงต้นฉบับไว้ควบคู่กับข้อความที่แปลแล้ว ซึ่งช่วยให้ผู้ใช้แยกแยะข้อผิดพลาดจากการจดจำเสียงออกจากข้อผิดพลาดในการแปลได้.
สำหรับการโทรออนไลน์นั้น การแปลการประชุมสด สามารถใช้งานร่วมกับสภาพแวดล้อมการประชุมต่างๆ ได้ผ่านทางไมโครโฟนหรือเส้นทางเสียงผ่านคอมพิวเตอร์ที่เลือกไว้. คำบรรยายภาพซ้อนภาพ แสดงข้อความสองภาษาไว้เหนือแอปพลิเคชันที่รองรับ แทนที่จะบังคับให้ผู้ใช้ดูแท็บถอดเสียงแยกต่างหาก.
ก่อนโทรศัพท์, คำสำคัญและบริบท สามารถเตรียมชื่อ คำย่อ คำศัพท์ผลิตภัณฑ์ และข้อมูลพื้นฐานได้ หลังจากเสร็จสิ้นการประชุมแล้ว เอกสารถอดเสียงจะเก็บรักษาทั้งข้อความต้นฉบับและข้อความที่แปลแล้วไว้ด้วยกัน บันทึกการประชุม AI สามารถสร้างบทสรุปและรายการดำเนินการได้ คู่มือการถอดเสียงฉบับปัจจุบันระบุว่าสามารถสร้างบทสรุปการประชุมได้ใน 55 ภาษา.
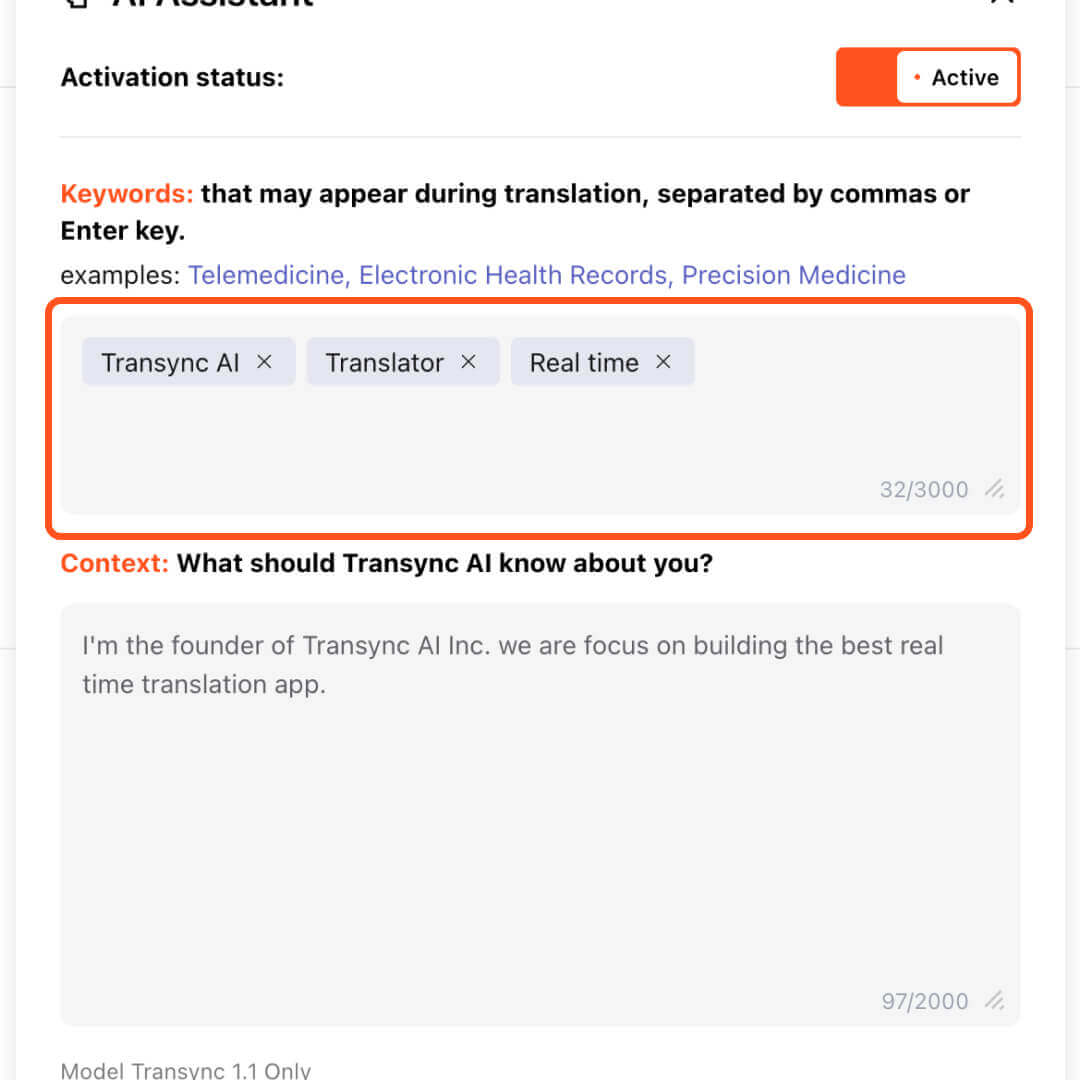
อินเทอร์เฟซ Transync AI เน้นแผงการเปิดใช้งานผู้ช่วย AI ด้วยคำสำคัญ 'Transync AI', 'Translator' และ 'Real time' ซึ่งแสดงวิธีการป้อนคำสำคัญที่กำหนดเองเพื่อให้ได้การแปลที่แม่นยำ.
เลือก Transync เอไอ เมื่อผลลัพธ์ทางธุรกิจคือการทำความเข้าใจและตอบสนองในหลายภาษา ควรเลือกใช้ API แบบสตรีมมิ่งแทนเมื่อทีมกำลังสร้างตัวแทนเสียงอัตโนมัติ แพลตฟอร์มวิเคราะห์การโทร ผลิตภัณฑ์เพื่อการเข้าถึง หรืออินเทอร์เฟซการถอดเสียงแบบฝังตัวด้วยตนเอง.
ข้อจำกัดนี้สำคัญมาก: Transync เอไอ นี่ไม่ใช่โปรแกรมบันทึกเสียงแบบออฟไลน์ทั่วไป หรือจุดเชื่อมต่อ STT สำหรับนักพัฒนา การกำหนดเส้นทางเสียง คุณภาพเครือข่าย คู่ภาษา ไมโครโฟน และการส่งสัญญาณระยะไกล ควรได้รับการทดสอบก่อนการประชุมที่สำคัญ.
เส้นทางที่ 2: ใช้ Deepgram เมื่อการกำหนดเวลาเลี้ยวเป็นส่วนหนึ่งของผลิตภัณฑ์
ดีพแกรม เอกสารนี้มีประโยชน์อย่างยิ่งสำหรับนักพัฒนา เนื่องจากเอกสารได้แยกผลลัพธ์ชั่วคราว ส่วนที่เสร็จสมบูรณ์ จุดสิ้นสุดของเสียงพูดที่ตรวจพบ และเหตุการณ์สิ้นสุดของประโยคออกจากกัน การแยกส่วนนี้ช่วยให้แอปพลิเคชันสามารถตัดสินใจได้ว่าจะแสดงข้อความ เพิ่มข้อความที่เสถียร หรือเรียกใช้การตอบสนองเมื่อใด.
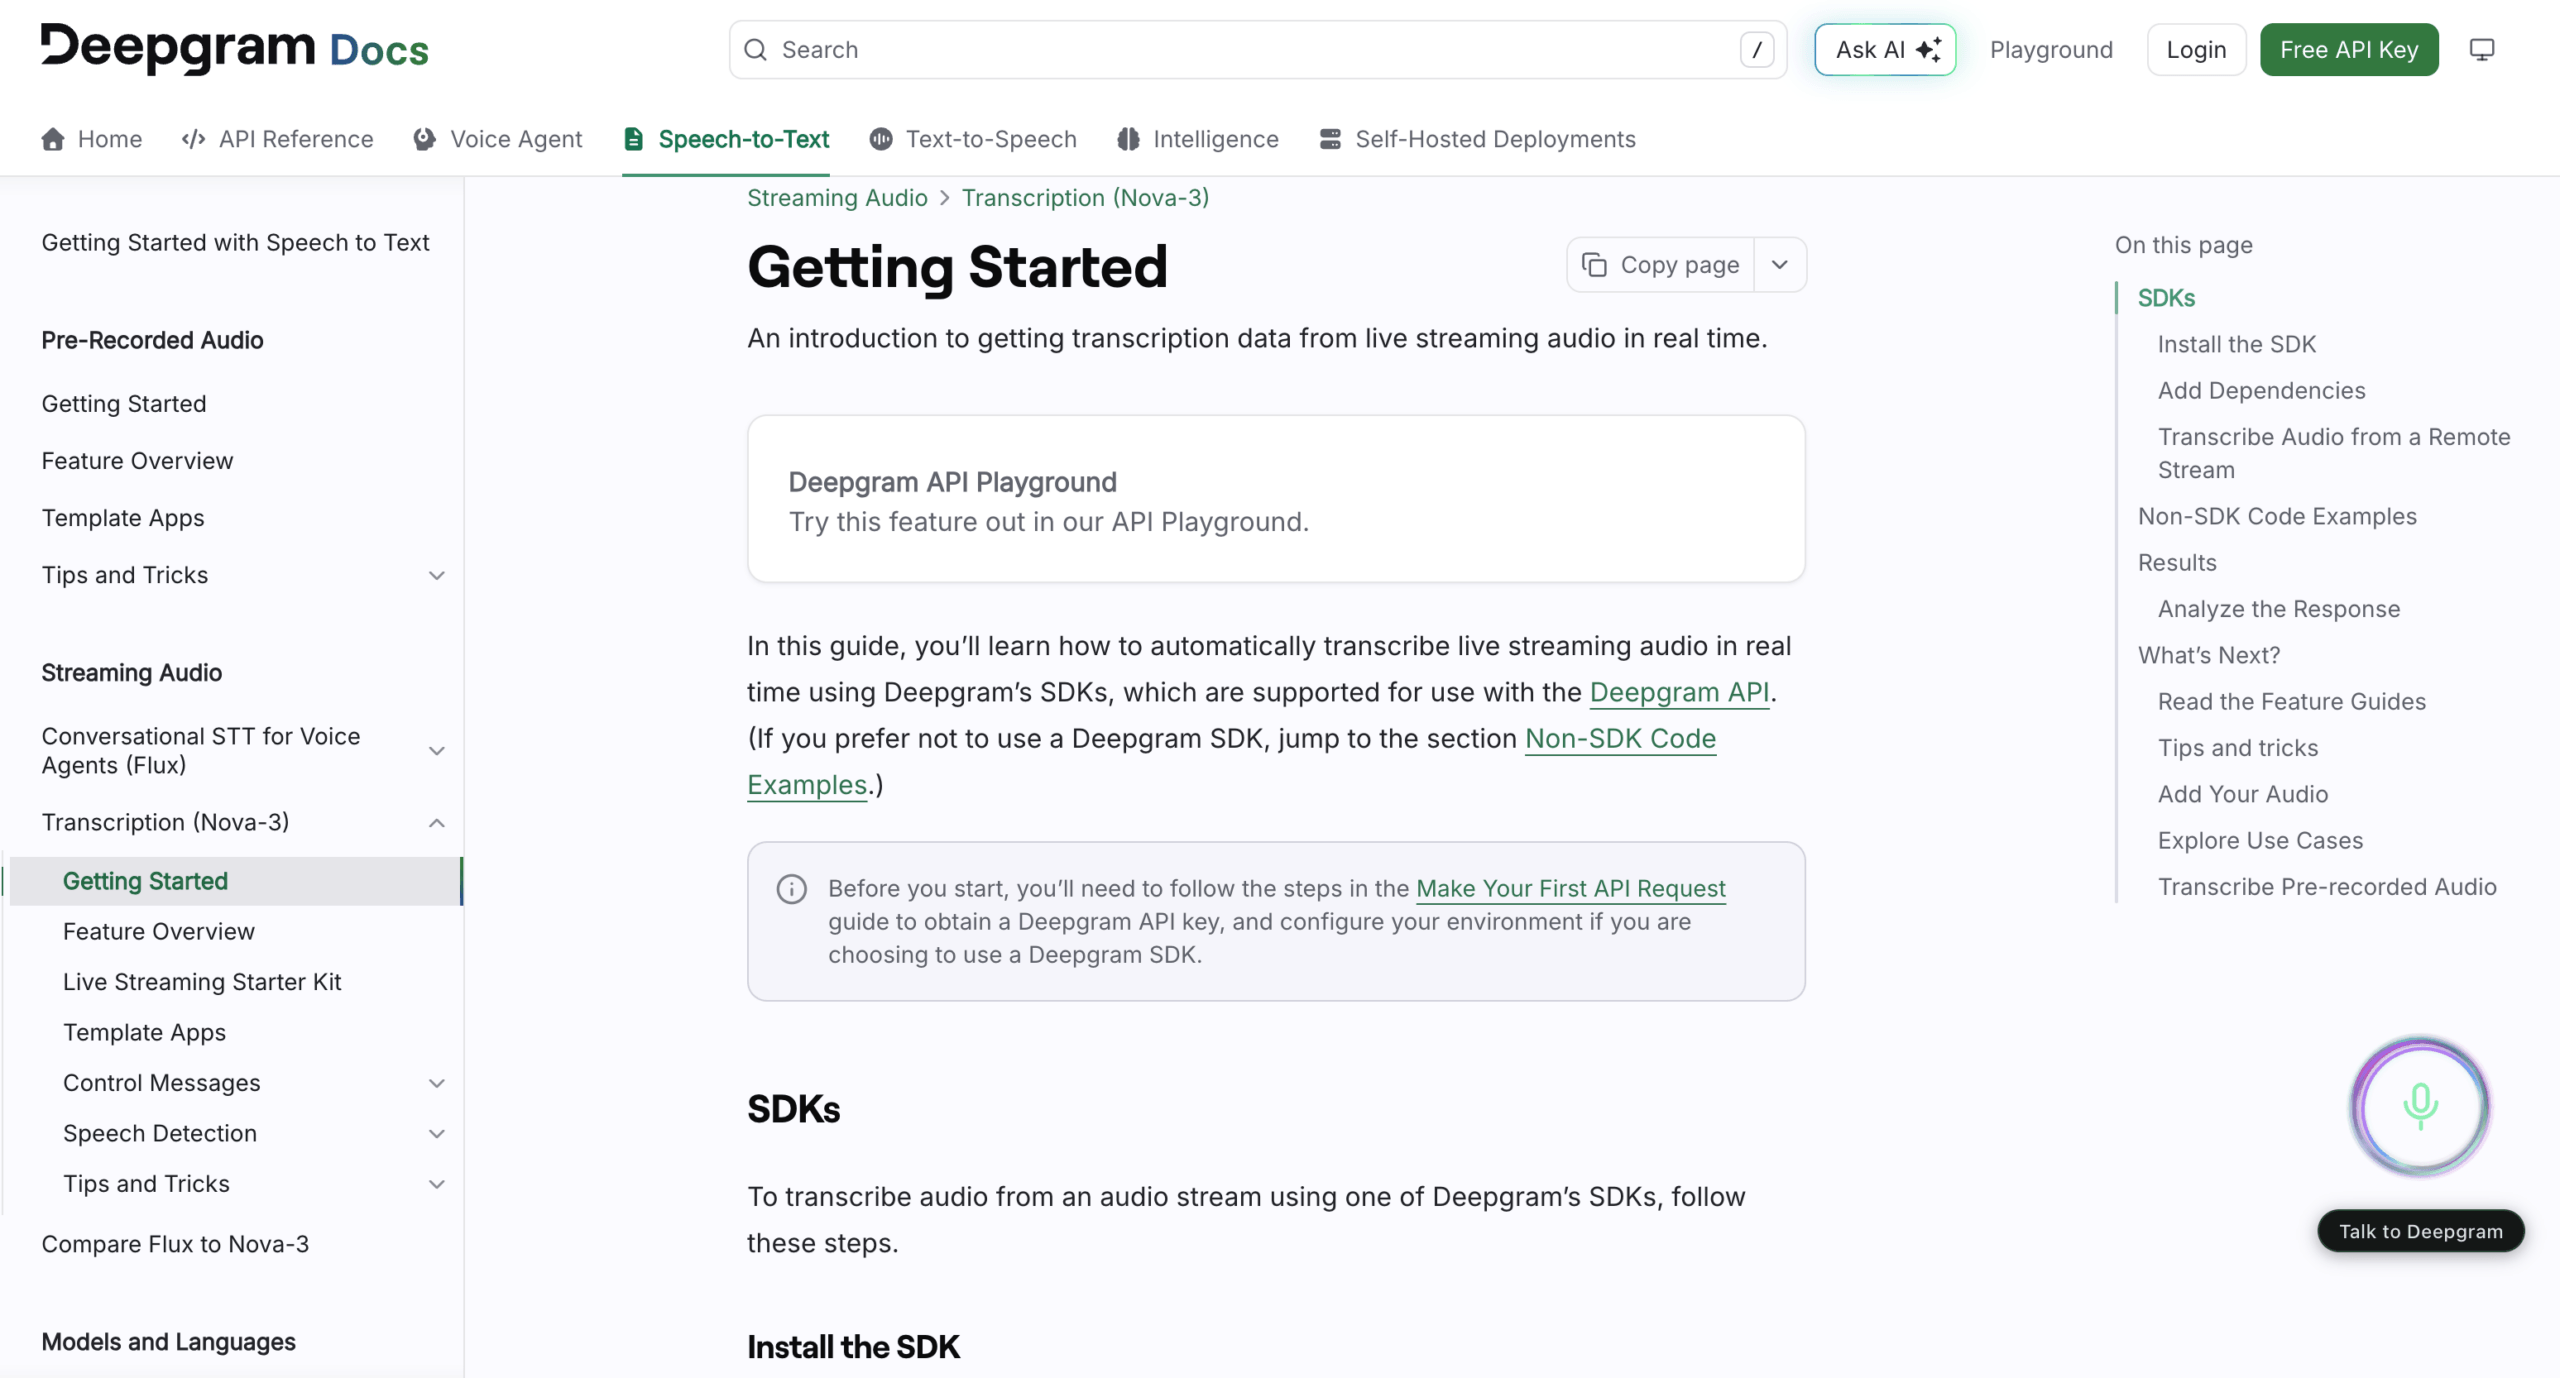
ใช้ ดีพแกรม เมื่อทีมพัฒนาผลิตภัณฑ์จำเป็นต้องปรับแต่งพฤติกรรมการสนทนาแทนที่จะยอมรับอินเทอร์เฟซคำบรรยายแบบตายตัว ทีมยังคงรับผิดชอบการส่งสัญญาณเสียง การจัดการสถานะ การแสดงผลข้อความบางส่วน การจัดเก็บข้อมูล การตรวจสอบสิทธิ์ การอนุญาต การแก้ไข และประสบการณ์การใช้งานขั้นสุดท้ายของผู้ใช้.
ข้อผิดพลาดในการใช้งานที่พบบ่อยคือ การบันทึกเฉพาะคำตอบล่าสุด หรือรอเฉพาะเหตุการณ์ที่เสียงพูดจบลงเท่านั้น คำแนะนำอย่างเป็นทางการอธิบายว่า คำพูดที่ยาวอาจมีส่วนถอดเสียงที่เสร็จสมบูรณ์หลายส่วนก่อนที่จะตรวจพบจุดสิ้นสุดของเสียงพูด แอปพลิเคชันจะต้องเชื่อมต่อส่วนถอดเสียงที่เสร็จสมบูรณ์แล้วอย่างถูกต้อง.
เส้นทางที่ 3: ใช้ AssemblyAI เมื่อสตรีมมิ่ง ป้ายกำกับผู้พูดมีความสำคัญ
แอสเซมบลีไอ โมเดลนี้มีฟังก์ชันการสตรีมข้อมูลพร้อมถอดเสียงบางส่วนและถอดเสียงทั้งหมด การระบุจุดสิ้นสุด การแจ้งเตือนคำสำคัญ การประทับเวลาของคำ และโหมดการแยกแยะผู้พูดที่รองรับ นอกจากนี้ เอกสารประกอบยังอธิบายถึงเหตุการณ์การแก้ไขผู้พูดด้วย กล่าวคือ โมเดลสามารถแก้ไขป้ายกำกับผู้พูดก่อนหน้านี้ได้เมื่อรวบรวมหลักฐานเพิ่มเติม.
พฤติกรรมการแก้ไขนั้นมีความสำคัญในอินเทอร์เฟซแบบเรียลไทม์ หากแอปพลิเคชันแสดงผล "ผู้พูด A" เป็นค่าถาวรเร็วเกินไป การแก้ไขในภายหลังอาจไม่ได้รับการบันทึกในระบบ อินเทอร์เฟซผู้ใช้จึงจำเป็นต้องมีกลยุทธ์ที่รอบคอบสำหรับป้ายกำกับและการแก้ไขที่รอดำเนินการ.
เลือก แอสเซมบลีไอ เมื่อการสตรีมที่คำนึงถึงผู้พูดและการควบคุมในระดับแอปพลิเคชันมีความสำคัญ โปรดตรวจสอบรุ่นที่แน่นอน การรองรับภาษา พฤติกรรมการแยกเสียงผู้พูด ตัวเลือกทางการแพทย์ และข้อกำหนดด้านข้อมูลสำหรับการใช้งานที่วางแผนไว้ คุณสมบัติจะแตกต่างกันไปตามรุ่นการสตรีม.
เส้นทางที่ 4: ใช้ Soniox สำหรับ API การสตรีมหลายภาษา
โซนิอ็อกซ์ แอปพลิเคชันนี้ผสานรวมการถอดเสียงและการแปลแบบเรียลไทม์ผ่าน API WebSocket อินเทอร์เฟซปัจจุบันรองรับคำแนะนำด้านภาษา การปรับแต่งบริบท การแยกเสียงผู้พูด การกำหนดค่าการแปล การประทับเวลาในระดับโทเค็น ความมั่นใจ ความสมบูรณ์ และข้อมูลภาษา.
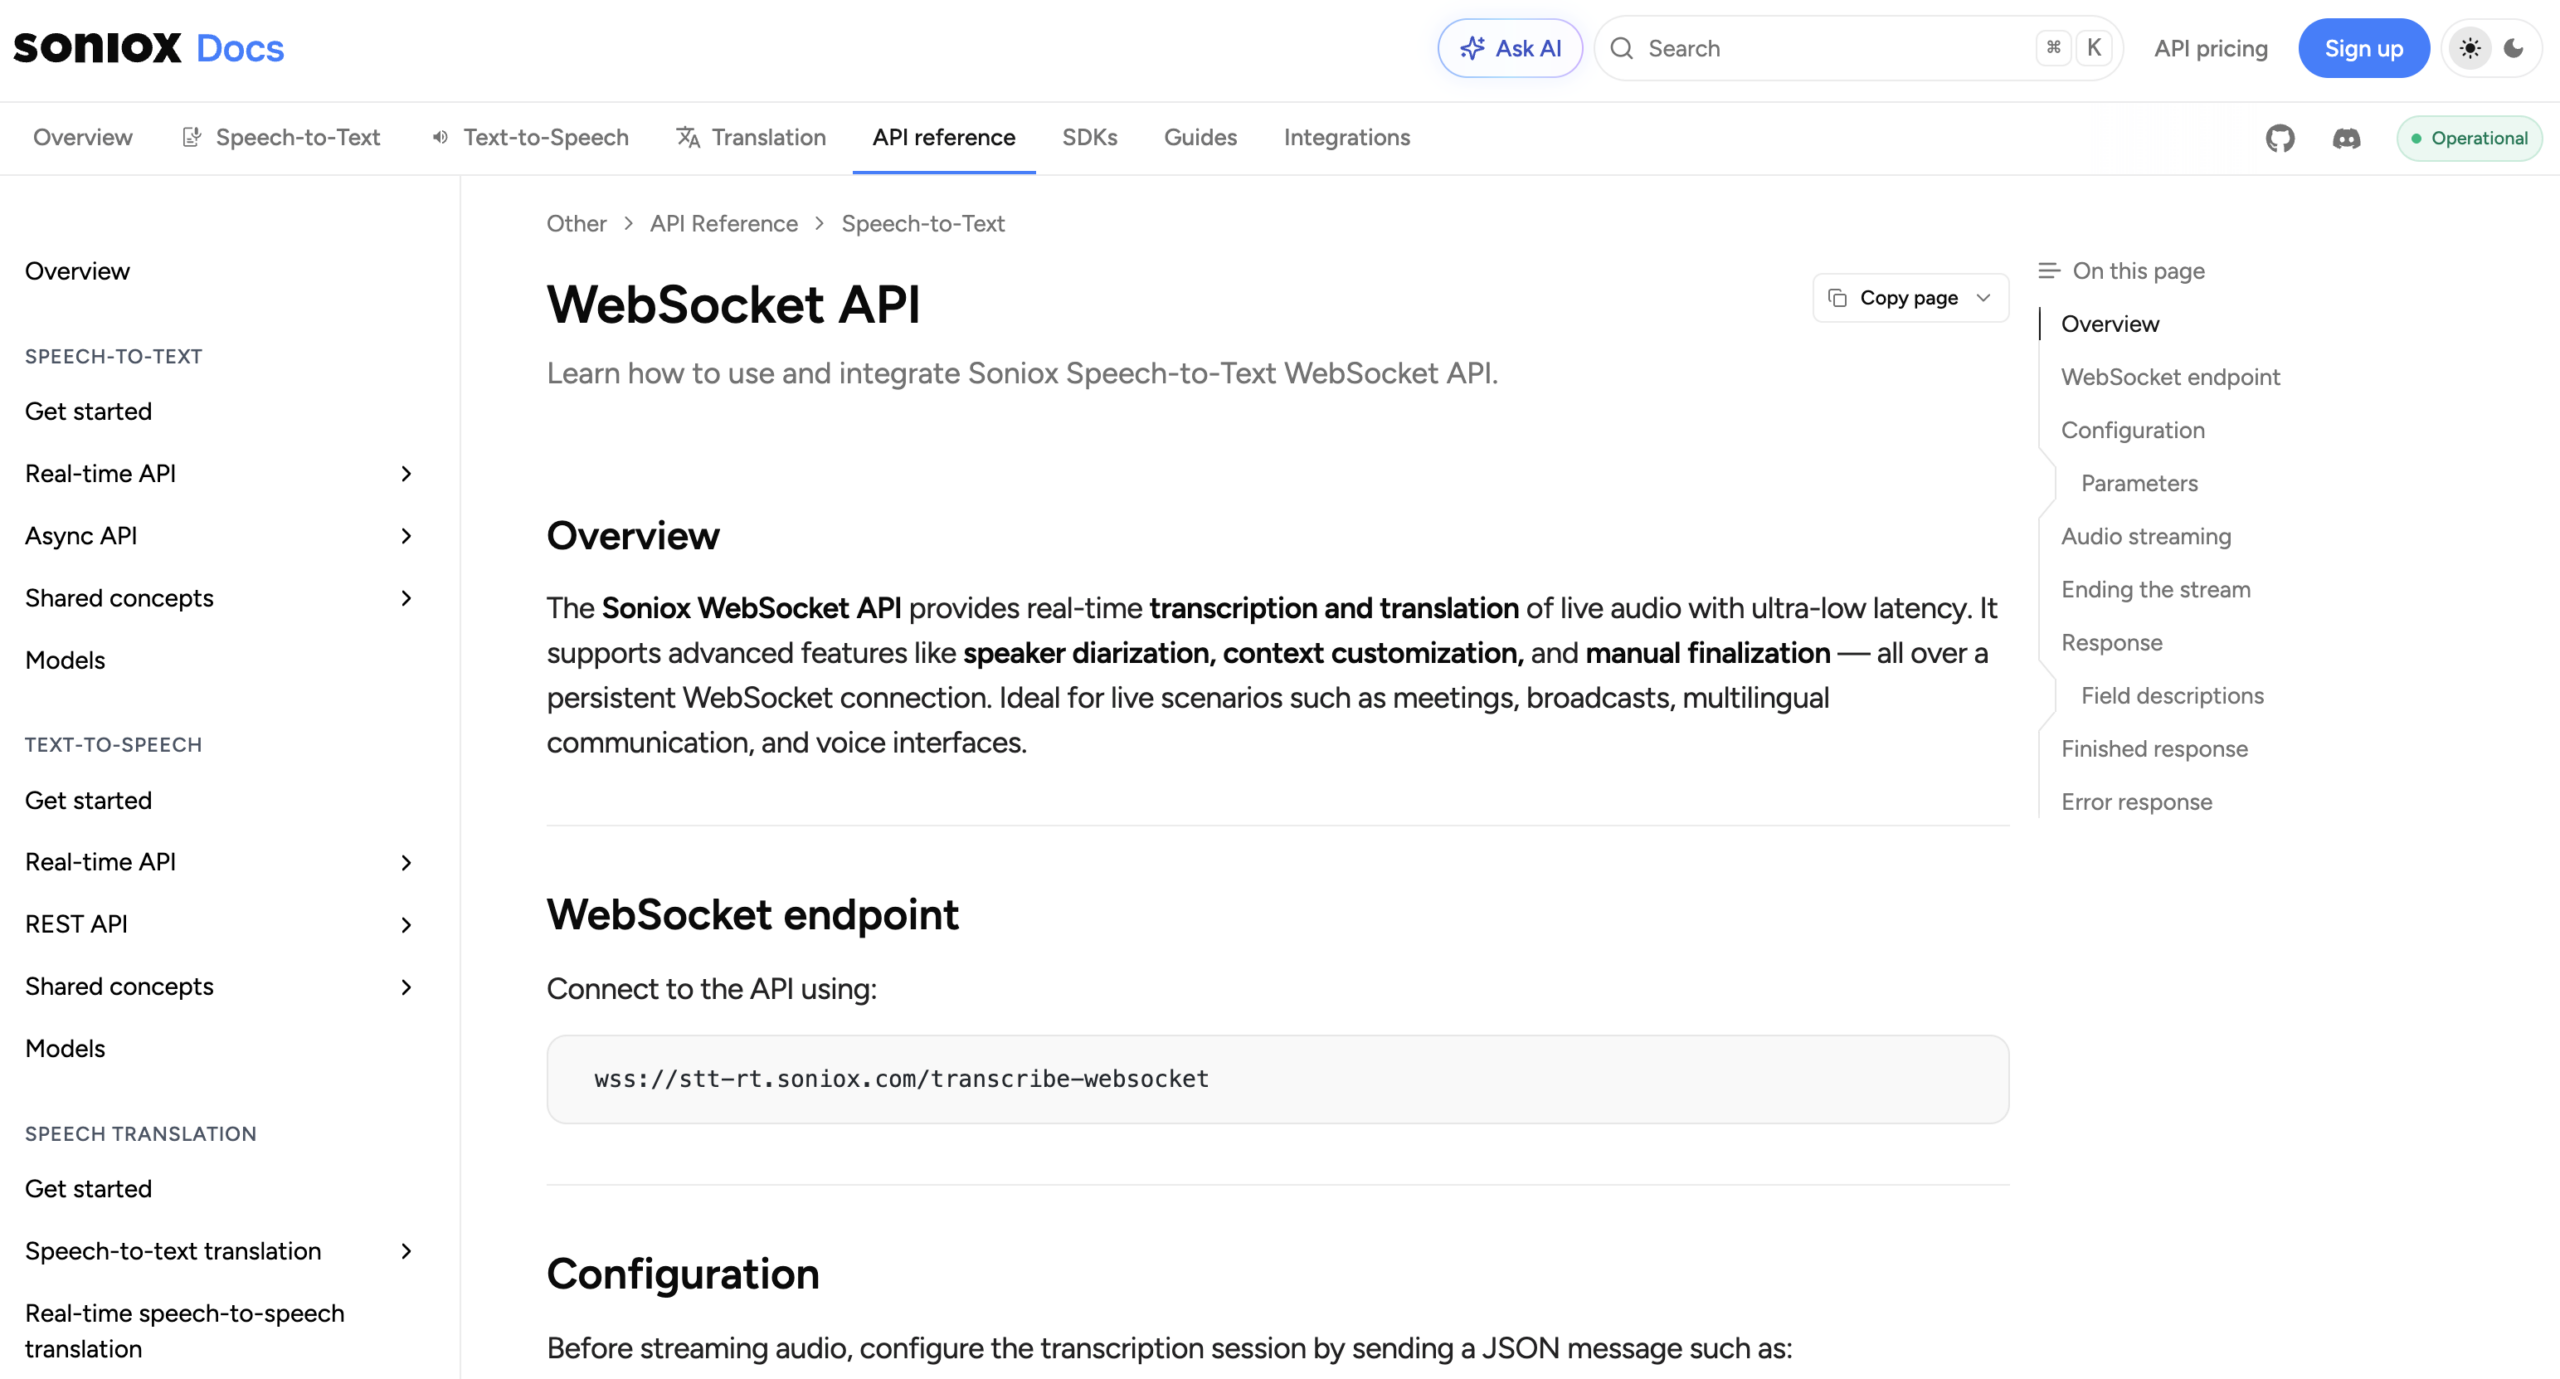
นี่ทำให้ โซนิอ็อกซ์ เหมาะสมเมื่อนักพัฒนาต้องการ แปลงเสียงเป็นข้อความแบบเรียลไทม์ และแสดงผลหลายภาษาภายในแอปพลิเคชันของตนเอง การกำหนดค่าบริบทสามารถช่วยในเรื่องคำศัพท์เฉพาะทางได้ แต่ควรทดสอบด้วยสคริปต์คำศัพท์ที่กำหนดไว้ล่วงหน้า แทนที่จะสันนิษฐานจากชื่อฟีเจอร์.
เช่นเดียวกับ API อื่นๆ บริการนี้จะส่งคืนส่วนประกอบพื้นฐาน ผู้ซื้อยังคงต้องสร้างการเข้าถึงของผู้เข้าร่วม การแก้ไข การเก็บรักษา การส่งออก สรุป การควบคุมโดยผู้ดูแลระบบ การตรวจสอบ การกู้คืนข้อผิดพลาด และการสนับสนุนด้วยตนเอง.
เหตุใดอัตราข้อผิดพลาดของคำจึงไม่เพียงพอ
อัตราความผิดพลาดของคำวัดการแทนที่ การลบ และการแทรกคำเทียบกับต้นฉบับ การวัดนี้มีประโยชน์ แต่ค่าเฉลี่ยเพียงค่าเดียวอาจปกปิดข้อผิดพลาดที่สำคัญที่สุดได้.
เปรียบเทียบข้อผิดพลาดสองข้อนี้:
- “เราสามารถจัดส่งสินค้าได้” วันพฤหัสบดี”เราสามารถจัดส่งได้“ วันอังคาร.”
- “กรุณาเปิด แผงการตั้งค่า”กรุณาเปิด“ แผงการตั้งค่า.”
ทั้งสองวิธีอาจนับได้คล้ายกัน แต่แบบแรกจะเปลี่ยนแปลงข้อผูกพัน สร้างบัญชีบันทึกข้อผิดพลาดสำหรับ:
- ชื่อและข้อมูลผู้พูด.
- ตัวเลข สกุลเงิน วันที่ และหน่วยวัด.
- การปฏิเสธและเงื่อนไข.
- ชื่อผลิตภัณฑ์และศัพท์เฉพาะทาง.
- การสลับรหัสภาษาและการเปลี่ยนแปลงภาษา.
- การขัดจังหวะและการแก้ไขตนเอง.
- เครื่องหมายวรรคตอนที่เปลี่ยนความหมาย.
จากนั้นให้พิจารณาเรื่องเวลา คำพูดที่ถูกต้องซึ่งกล่าวหลังจากมีการตัดสินใจไปแล้ว อาจผิดพลาดในเชิงปฏิบัติการได้ ความผิดพลาดชั่วคราวที่แก้ไขในภายหลัง อาจยังคงทำให้ตัวแทนเสียงหรือผู้เข้าร่วมกระทำการใดๆ อยู่ดี.
ด้านขวา แปลงเสียงเป็นข้อความแบบเรียลไทม์ ดังนั้น คะแนนจึงรวมเอาความรุนแรงของข้อผิดพลาดทางข้อเท็จจริง ความเสถียร จังหวะเวลาในการพูด และการนำเสนอเข้าด้วยกัน ไม่ใช่เพียงแค่ความถูกต้องของคำโดยเฉลี่ยเท่านั้น.
เทปความจริงสองนาที
ใช้แหล่งบันทึกเสียงเพียงแหล่งเดียว เพื่อให้ผู้สมัครทุกคนได้รับเสียงที่เหมือนกัน อย่าปล่อยให้ผู้ขายแต่ละรายเลือกตัวอย่างเสียงเอง.
สคริปต์
- “สวัสดีค่ะ ดิฉันเนียม โอ'รูร์ค จากบริษัทแอสเตอร์-คิว ค่ะ”
- “รหัสอ้างอิงคือ BX-417 ไม่ใช่ BX-471”
- “รายได้อยู่ที่ 15.05 ล้านเหรียญสหรัฐ เพิ่มขึ้น 13.6 เปอร์เซ็นต์”
- “อย่าต่ออายุสัญญาหากยังไม่ได้ลงนามในข้อตกลงระดับบริการ”
- “จัดส่งสินค้าจำนวนสิบห้า—ขออภัย ห้าสิบ—หน่วยในวันพฤหัสบดี”
- “API นี้ใช้การสตรีมมิ่งผ่าน WebSocket และมีจุดสิ้นสุดที่เวลา 300 มิลลิวินาที”
- หยุดชั่วคราว 700 มิลลิวินาทีตรงกลางประโยคเงื่อนไข.
- อนุญาตให้บุคคลที่สองขัดจังหวะ จากนั้นจึงกลับไปที่ผู้พูดคนแรก.
- เพิ่มประโยคหนึ่งประโยคในภาษาที่สองที่กำหนดไว้.
- จบด้วยประโยคเบาๆ ขณะที่ยังได้ยินเสียงแป้นพิมพ์อยู่.
แผ่นบันทึกข้อมูล
| การวัด | วิธีการบันทึก | เงื่อนไขที่ต้องกำหนดก่อนทำการทดสอบ |
|---|---|---|
| ได้เวลาส่งข้อความแรกแล้ว | เสียงเริ่มต้นสำหรับสมมติฐานที่ไม่ว่างเปล่าข้อแรก | โดยพิจารณาจากความต้องการการตอบสนองทางภาพของผู้ใช้ |
| เวลาสำหรับข้อความที่เสถียร | คำพูดสุดท้ายที่เปล่งออกมาจนถึงข้อความสุดท้ายที่ไม่เปลี่ยนแปลง | เร็วพอที่ผู้คนจะไม่ทันได้ดำเนินการแก้ไข |
| ความล่าช้าในการสิ้นสุดเทิร์น | สิ้นสุดรอบการทำงานที่ตั้งใจไว้ไปยังเหตุการณ์ปลายทางหรือตัวกระตุ้นการตอบสนอง | ไม่ขัดจังหวะช่วงหยุดพักปกติ หรือรู้สึกไม่ตอบสนอง |
| จำนวนการแก้ไข | จำนวนการเปลี่ยนแปลงสมมติฐานที่มองเห็นได้หรือระดับ API | อินเทอร์เฟซยังคงอ่านได้ และการดำเนินการในขั้นตอนถัดไปจะรอการอนุมัติขั้นสุดท้าย |
| ข้อผิดพลาดข้อเท็จจริงที่สำคัญ | ชื่อ ตัวเลข การปฏิเสธ วันที่ หน่วย และเงื่อนไข | ไม่มีข้อผิดพลาดร้ายแรงที่ไม่ได้แจ้งเตือนเลยในโครงการนำร่อง |
| การกู้คืนป้ายกำกับลำโพง | เวลาและความถูกต้องหลังจากถูกขัดจังหวะ | บันทึกการถอดเสียงที่บันทึกไว้แสดงการระบุแหล่งที่มาที่ถูกต้อง |
| การดำเนินการตามขั้นตอนเสร็จสมบูรณ์ | การประชุมสิ้นสุดเพื่อบันทึกหรือการดำเนินการแอปพลิเคชันที่สามารถค้นหา/ส่งออกได้ | ตรงตามกำหนดเวลาในการดำเนินงาน |
ทำการทดลอง 10 ครั้ง จากนั้นรายงานค่ามัธยฐาน ค่าเปอร์เซ็นไทล์ที่ 95 และผลลัพธ์ที่แย่ที่สุดที่พบ (หากข้อมูลตัวอย่างเอื้ออำนวย) การทดลองที่สมบูรณ์แบบเพียงครั้งเดียวไม่ถือเป็นการยืนยันความน่าเชื่อถือ.
เจ็ดโหมดความล้มเหลวและวิธีแก้ไขเบื้องต้น
| อาการ | ชั้นที่น่าจะเป็นไปได้ | การตรวจสอบที่มีประโยชน์ครั้งแรก |
|---|---|---|
| ข้อความปรากฏขึ้นช้ากว่าคำแรก | การจับภาพ การบัฟเฟอร์ การเข้ารหัส เครือข่าย หรือแบบจำลอง | วัดระยะการกระโดดแต่ละครั้ง ลดขนาดไฟล์เสียงที่ใหญ่เกินไป |
| ข้อความปรากฏขึ้นอย่างรวดเร็ว แต่มีการแก้ไขเปลี่ยนแปลงอย่างมาก | พฤติกรรมสมมติฐานชั่วคราว | รอจนกว่าจะได้รับการยืนยันขั้นสุดท้ายก่อนจึงจะดำเนินการใดๆ; ออกแบบการแสดงผลชั่วคราวใหม่ |
| ระบบตัดโอกาสผู้พูดที่มีความคิด | การตรวจจับเกณฑ์จุดสิ้นสุดหรือกิจกรรมเสียง | ทดสอบช่วงหยุดที่ยาวขึ้นและปรับแต่งการกำหนดจุดสิ้นสุดหากทำได้ |
| ระบบรอเป็นเวลานานเกินไปหลังจากคำสั่งสั้นๆ | เกณฑ์ปลายทางหรือตรรกะการปิดใช้งานแอปพลิเคชัน | ทดสอบค่าเกณฑ์ที่สั้นลงหรือการควบคุมการสิ้นสุดรอบที่ชัดเจน |
| ชื่อและรหัสใช้งานไม่ได้ซ้ำแล้วซ้ำเล่า | ความกำกวมทางเสียงและบริบทโดเมนที่ขาดหายไป | เพิ่มคำสำคัญ/บริบท และปรับปรุงคุณภาพไมโครโฟน |
| ป้ายกำกับลำโพงจะเปลี่ยนไปหลังจากแสดงผล | การแยกเสียงพูดแบบสตรีมมิ่งกำลังปรับปรุงคลัสเตอร์ | สนับสนุนป้ายกำกับที่รอดำเนินการและใช้เหตุการณ์การแก้ไขกับบันทึก |
| การถอดเสียงทำได้เร็ว แต่ใช้งานไม่ได้หลังจากนั้น | ขั้นตอนการทำงานของผลิตภัณฑ์ที่ขาดหายไป | เพิ่มฟังก์ชันการแก้ไข การจัดเก็บ การค้นหา สิทธิ์การเข้าถึง การส่งออก และการลบ หรือเลือกแอปสำเร็จรูป |
แก้ไขปัญหา แปลงเสียงเป็นข้อความแบบเรียลไทม์ จากซ้ายไปขวา การเปลี่ยนโมเดลจะไม่แก้ไขปัญหาเสียงเบา อัตราการสุ่มตัวอย่างที่ไม่ถูกต้อง หรืออินเทอร์เฟซผู้ใช้ที่บันทึกข้อความชั่วคราวเป็นข้อความสุดท้าย.
เมื่อการแปลงเสียงเป็นข้อความไม่ใช่ขั้นตอนสุดท้าย
การถอดเสียงตอบคำถามว่า “คำใดบ้างที่ถูกจดจำได้?” การแปลตอบคำถามว่า “คำเหล่านั้นหมายความว่าอย่างไรในอีกภาษาหนึ่ง?” ผลลัพธ์ของการประชุมต้องตอบคำถามด้วยว่า “อีกฝ่ายสามารถเข้าใจ ตอบสนอง และกู้คืนการตัดสินใจได้ในภายหลังหรือไม่?”
หากทุกคนพูดภาษาเดียวกันและต้องการคำบรรยายประกอบ การบันทึกเสียง การค้นหา หรือการวิเคราะห์ข้อมูล การใช้ API สำหรับการถอดเสียงแบบเฉพาะทาง หรือผลิตภัณฑ์ถอดเสียงอาจเพียงพอ แต่หากผู้เข้าร่วมใช้ภาษาที่แตกต่างกัน กระบวนการทำงานจะต้องมีการควบคุมเพิ่มเติม:
- ข้อความต้นฉบับจะปรากฏอยู่ข้างๆ คำแปล.
- การเลือกภาษาหรือการจัดการอัตโนมัติ.
- การเตรียมความพร้อมด้านคำศัพท์และบริบท.
- ข้อความภาษาเป้าหมายที่ส่งระหว่างการสนทนา.
- การเปิดใช้งานเสียงแปลเสริมขณะอ่านนั้นไม่สะดวกในทางปฏิบัติ.
- บันทึกและข้อความที่ช่วยเก็บรักษาการสนทนาหลายภาษาไว้.
นี่คือจุดที่ แปลงเสียงเป็นข้อความแบบเรียลไทม์ กลายเป็นส่วนประกอบหนึ่งของสิ่งที่ใหญ่กว่า Transync เอไอ เน้นที่กระบวนการทำงานมากกว่าผลลัพธ์สุดท้าย.
คำถามที่พบบ่อยเกี่ยวกับการแปลงเสียงพูดเป็นข้อความแบบเรียลไทม์
การแปลงเสียงพูดเป็นข้อความแบบเรียลไทม์คืออะไร?
แปลงเสียงเป็นข้อความแบบเรียลไทม์ ระบบจะแปลงเสียงสตรีมมิ่งเป็นข้อความชั่วคราวและข้อความสุดท้ายในขณะที่กำลังพูดอยู่ ระบบอาจแก้ไขสมมติฐานเบื้องต้นเมื่อได้รับบริบทเพิ่มเติม ตรวจจับการสิ้นสุดของการพูด ใส่เครื่องหมายวรรคตอน หรือปรับปรุงการระบุผู้พูดให้ดียิ่งขึ้น.
ความล่าช้าระดับไหนถึงจะนับว่าเป็นเวลาจริง?
ไม่มีเกณฑ์ตายตัว ควรวัดเวลาตั้งแต่เริ่มแสดงข้อความแรก ข้อความที่เสถียร ความสมบูรณ์ของการสนทนา และผลลัพธ์ของเวิร์กโฟลว์ที่ใช้งานได้ ผู้ที่อ่านคำบรรยาย ผู้ตอบเสียง ผู้เข้าร่วมประชุม และผู้ตรวจสอบหลังการสนทนา มีความล่าช้าที่ยอมรับได้แตกต่างกัน.
ทำไมข้อความสดถึงเปลี่ยนไปเรื่อยๆ?
โปรแกรมรู้จำเสียงแบบสตรีมมิ่งจะเผยแพร่สมมติฐานบางส่วนก่อนที่ประโยคจะสมบูรณ์ เสียงที่ได้ยินในภายหลังอาจเปลี่ยนแปลงคำพูด เครื่องหมายวรรคตอน ภาษา หรือผู้พูดที่น่าจะเป็นไปได้มากที่สุด แอปพลิเคชันควรแยกแยะผลลัพธ์ชั่วคราวออกจากข้อความที่เสร็จสมบูรณ์แล้ว.
การแปลงเสียงพูดเป็นข้อความแบบเรียลไทม์เหมือนกับการแปลสดหรือไม่?
ไม่ การแปลงเสียงเป็นข้อความจะรับรู้คำพูดในภาษาต้นฉบับเท่านั้น การแปลแบบเรียลไทม์จะเพิ่มการแปลงภาษาอีกขั้นตอนหนึ่ง และอาจเพิ่มเสียงที่แปลแล้วเข้าไปด้วย. Transync เอไอ ผสานการจดจำและการแปลสำหรับการสนทนาหลายภาษา.
API ใดดีที่สุดสำหรับการแปลงเสียงพูดเป็นข้อความแบบเรียลไทม์?
ไม่มีผู้ชนะที่เป็นเอกฉันท์. ดีพแกรม นำเสนอการควบคุมการกำหนดจุดสิ้นสุดและสถานะผลลัพธ์อย่างละเอียด, แอสเซมบลีไอ นำเสนอระบบการแยกเสียงพูดแบบสตรีมมิ่งที่รองรับ และพฤติกรรมการแก้ไข และ โซนิอ็อกซ์ ผสานรวมตัวเลือกการถอดเสียงและการแปลหลายภาษา ทดสอบแต่ละตัวเลือกด้วยไฟล์เสียงที่เหมือนกันและข้อกำหนดของผลิตภัณฑ์ที่แน่นอน.
ระบบแปลงเสียงพูดเป็นข้อความแบบเรียลไทม์สามารถระบุผู้พูดได้หรือไม่?
บางรุ่นรองรับการแยกเสียงพูดหรือการรับเสียงหลายช่องสัญญาณ แต่ป้ายกำกับอาจเป็นเพียงชั่วคราวและอาจเปลี่ยนแปลงได้เมื่อมีเสียงเพิ่มเติมเข้ามา ตรวจสอบการขัดจังหวะการทดสอบ เสียงที่คล้ายกัน การเปลี่ยนแปลงอุปกรณ์ และการแก้ไขป้ายกำกับที่บันทึกไว้.
ธุรกิจควรทดสอบอะไรเป็นอันดับแรก?
เริ่มต้นด้วยไฟล์เสียงต้นฉบับและสคริปต์ความยาวสองนาทีที่ประกอบด้วยชื่อ ตัวเลข คำปฏิเสธ การแก้ไข การหยุดชั่วคราว การขัดจังหวะ คำศัพท์เฉพาะ และภาษาที่ต้องการ วัดเวลาจากนาฬิกาทั้งสี่เรือนและตรวจสอบไฟล์บันทึกที่บันทึกไว้.
คำตัดสินสุดท้าย
เร็วที่สุด แปลงเสียงเป็นข้อความแบบเรียลไทม์ ระบบไม่จำเป็นต้องเป็นระบบที่แสดงคำแรกได้เร็วที่สุดเสมอไป ระบบที่เชื่อถือได้จะปรับสมดุลนาฬิกาทั้งสี่เรือน:
ข้อความแรก → ข้อความที่เสถียร → การดำเนินการเสร็จสมบูรณ์ → บันทึกที่ใช้งานได้
เลือกใช้ API สตรีมมิ่งเมื่อนักพัฒนาต้องการควบคุมการกำหนดเอนด์พอยต์ ผลลัพธ์บางส่วน การแก้ไขของผู้พูด และพฤติกรรมของแอปพลิเคชัน เลือกใช้ผลิตภัณฑ์การประชุมสำเร็จรูปเมื่อทีมต้องการเส้นทางที่สมบูรณ์ตั้งแต่เสียงไปจนถึงคำบรรยาย การแปล การบันทึก และบันทึกย่อ โดยไม่ต้องสร้างโครงสร้างพื้นฐานเหล่านั้นเอง.
สิ่งสำคัญที่สุดคือ ต้องทดสอบข้อมูลป้อนเข้าจริงและผลลัพธ์ที่เกิดขึ้นจริง วัดคำที่ปรากฏ คำที่เปลี่ยนแปลง ขั้นตอนสุดท้าย และบันทึกที่ผู้คนจะเชื่อถือได้ในภายหลัง.