Konversi ucapan ke teks secara real-time lebih dari sekadar teks terjemahan cepat. Pertimbangkan 4 jam tersembunyi, revisi, penanganan pembicara, dan kesesuaian rapat multibahasa sebelum memilih.
Konversi ucapan ke teks secara real-time mungkin terlihat bagus dalam demo, tetapi tetap gagal dalam percakapan. Kata-kata pertama mungkin muncul dalam 300 milidetik, namun kalimat dapat terus berubah selama dua detik. Label pembicara mungkin muncul, lalu direvisi. Transkrip yang disempurnakan mungkin siap dengan cepat tetapi menghilangkan negasi yang mengubah keputusan.
Itulah mengapa "Seberapa cepat?" bukanlah pertanyaan pertama yang tepat. Evaluasi yang bermanfaat membutuhkan empat indikator: waktu hingga teks pertama, waktu hingga teks stabil, waktu hingga giliran selesai, dan waktu hingga catatan yang dapat digunakan. Setiap indikator menjawab kebutuhan operasional yang berbeda.
Artikel ini membahas Konversi ucapan ke teks secara waktu nyata Sebagai alur kerja yang terukur, bukan sekadar efek visual. Ini membandingkan API streaming khusus dengan produk rapat multibahasa yang siap pakai, menyediakan skrip pengujian yang dapat diulang, dan menjelaskan kapan transkripsi saja tidak cukup karena peserta membutuhkan terjemahan, keluaran suara, atau catatan.
Jawaban 60 Detik
Konversi ucapan ke teks secara waktu nyata Mengubah aliran audio langsung menjadi teks saat pembicara masih berbicara. Teks yang ditampilkan seringkali bersifat sementara. Kata-kata awal dapat direvisi saat model menerima lebih banyak konteks, mendeteksi jeda, mengidentifikasi pembicara, menerapkan tanda baca, atau menyelesaikan ucapan.
Keempat jam tersebut adalah:
- Latensi teks pertama: Berapa lama lagi sampai hipotesis muncul?
- Latensi stabilitas: Berapa lama lagi sampai kata-kata itu berhenti berubah?
- Latensi finalitas giliran: Berapa lama waktu yang dibutuhkan sistem untuk memutuskan bahwa giliran berbicara atau ucapan telah berakhir?
- Latensi alur kerja: Berapa lama waktu yang dibutuhkan hingga transkrip dapat digunakan untuk pencarian, catatan, tindakan, terjemahan, atau tanggapan aplikasi?
Agen suara dapat memprioritaskan ketepatan waktu respons karena harus memutuskan kapan harus menjawab. Teks terjemahan yang mudah diakses dapat memprioritaskan teks parsial yang cepat dan mudah dibaca. Rekaman rapat dapat mentolerir tampilan yang sedikit lebih lambat jika nama, angka, dan atribusi pembicara menjadi lebih andal. Rapat multibahasa menambahkan tahap lain setelah pengenalan: terjemahan harus tiba cukup cepat agar seseorang dapat merespons.
Konversi Ucapan ke Teks Secara Real Time Adalah Hipotesis yang Terus Berkembang
Transkrip langsung tidak dihasilkan dalam satu langkah:
Mikrofon atau audio sistem → pengkodean dan pengiriman → deteksi suara → pengenalan sementara → revisi → finalisasi → pelabelan dan pemformatan pembicara → tindakan aplikasi
Layar biasanya hanya menampilkan bagian tengah. Hal itu menciptakan ilusi umum: karena teks muncul secara langsung, pengguna menganggap hasilnya sudah selesai. Padahal, mesin tersebut mungkin masih mempertimbangkan batas kata, tanda baca, bahasa, atau identitas pembicara.
API khusus memperjelas perbedaan ini. Deepgram Mengembalikan hasil sementara dan hasil akhir secara terpisah. Dokumentasinya menjelaskan bahwa teks pendahuluan dapat berubah, sementara segmen yang telah diselesaikan harus ditambahkan untuk merekonstruksi ujaran lengkap. Sinyal akhir ucapan terpisah menunjukkan bahwa sistem mendeteksi titik akhir seperti jeda.
Soniox Menampilkan token akhir dan non-akhir, stempel waktu, tingkat kepercayaan, informasi bahasa, label pembicara opsional, dan kemajuan pemrosesan melalui koneksi streaming yang berkelanjutan. AssemblyAI similarly menawarkan transkrip parsial dan final, penandaan titik akhir, stempel waktu tingkat kata, pengingat istilah kunci, dan pencatatan pembicara secara streaming dalam model yang didukung.
Kontrol-kontrol tersebut berguna bagi para pengembang. Kontrol-kontrol tersebut juga mengungkapkan mengapa pengguna akhir tidak seharusnya menghakimi. Konversi ucapan ke teks secara waktu nyata hanya berdasarkan garis pertama yang terlihat.
Jam 1: Waktu ke Pesan Teks Pertama
Penghitung waktu pertama dimulai ketika suara mencapai sistem dan berhenti ketika hipotesis non-kosong pertama menjadi terlihat atau tersedia untuk aplikasi.
Pengukuran ini mencakup lebih dari sekadar inferensi model:
- Perekaman audio melalui mikrofon atau rapat.
- Ukuran buffer dan pembagian audio menjadi bagian-bagian kecil.
- Pengambilan sampel ulang atau pengkodean.
- Transportasi jaringan.
- Pemrosesan server.
- Transportasi pulang pergi.
- Rendering antarmuka.
Ukuran Konversi ucapan ke teks secara waktu nyata Angka tersebut berasal dari perangkat pengguna sebenarnya, bukan dari dasbor API. Angka dari sisi server vendor dapat mengecualikan buffering audio, jaringan klien, rendering browser, dan penundaan dari platform rapat itu sendiri.
Teks awal yang cepat sangat berharga ketika pengguna membutuhkan kepastian bahwa sistem sedang mendengarkan. Namun, teks ini kurang berguna ketika antarmuka mendorong mereka untuk bertindak berdasarkan kata-kata yang belum pasti. Desain keterangan yang baik secara visual membedakan teks sementara tanpa membuatnya sulit dibaca.
Cara menguji jam pertama
Rekam audio dan layar yang sama pada 60 frame per detik. Tepuk tangan sekali, lalu ucapkan: “Perpanjangan tidak disetujui.” Tandai frame di mana gelombang suara atau tepukan mencapai input dan frame di mana teks pertama muncul. Ulangi sepuluh kali dan laporkan hasil median dan hasil paling lambat, bukan hasil terbaik.
Tes Konversi ucapan ke teks secara waktu nyata Dalam kondisi Wi-Fi biasa, jaringan yang padat, laptop yang menggunakan peredam kebisingan, dan headset atau mikrofon ruangan sebenarnya. Kecepatan teks pertama yang hilang di bawah beban normal bukanlah fitur produk yang dapat diandalkan.
Jam 2: Waktu Menuju Teks Stabil
Jam kedua berhenti ketika suatu rentang teks tidak akan berubah lagi. Inilah jam yang paling sering disembunyikan dalam demonstrasi pemasaran.
Perhatikan frasa yang diucapkan:
“Kirim lima belas—maaf, lima puluh—unit pada hari Kamis.”
Tampilan mungkin akan berlanjut melalui “kapal 15,” lalu “kapal 50,” kemudian koreksi dengan tanda baca. Versi pertama tiba dengan cepat, tetapi hanya versi final yang aman untuk disalin ke dalam pesanan.
Stabilitas penting karena sistem hilir mungkin bereaksi terlalu dini. Ringkasan langsung, asisten penjualan, pemicu kepatuhan, lapisan terjemahan, atau agen suara dapat mewarisi kesalahan sementara. Dalam hal ini, Konversi ucapan ke teks secara waktu nyata Dalam alur kerja, pengembang harus memproses sinyal finalitas mesin daripada memperlakukan setiap pembaruan parsial sebagai pernyataan yang lengkap.
Ukur jarak revisi, bukan hanya penundaan.
Untuk setiap kalimat uji, catat:
- Jumlah versi sementara.
- Jumlah kata yang diganti atau dihapus.
- Jeda waktu antara kata terakhir yang diucapkan dan teks yang stabil.
- Apakah transkrip akhir yang tersimpan sesuai dengan tampilan yang stabil.
- Apakah tindakan hilir dipicu sebelum stabilitas tercapai.
Sedikit lebih lambat Konversi ucapan ke teks secara waktu nyata Sistem akan lebih aman jika revisinya tidak terlalu agresif. Kompromi yang tepat bergantung pada apakah pengguna sedang membaca, mendikte, mengendalikan perangkat lunak, atau melakukan negosiasi.
Jam 3: Waktu untuk Menyelesaikan Giliran
Kata-kata bisa menjadi final meskipun giliran berbicara belum. Seseorang mungkin berhenti sejenak untuk berpikir, bernapas, mencari sosok yang tepat, atau menunggu interupsi. Jika sistem menyatakan giliran selesai terlalu cepat, agen suara mungkin akan menyela pengguna. Jika menunggu terlalu lama, percakapan terasa tidak responsif.
Penentuan akhir percakapan biasanya menggunakan keheningan atau aktivitas suara untuk menyimpulkan bahwa ucapan telah berakhir. Deepgram dokumen yang dapat dikonfigurasi untuk pengaturan titik akhir dan terpisah adalah_final Dan pidato_akhir pedoman tersebut menyatakan bahwa ambang batas yang singkat cocok untuk jawaban chatbot yang ringkas, sementara jeda percakapan yang lebih lama mungkin membutuhkan ratusan milidetik sebelum giliran dianggap selesai.
Tidak ada pengaturan universal yang cocok untuk setiap pembicara. Skrip pusat panggilan yang cepat, riwayat medis yang ragu-ragu, kuliah di kelas, dan negosiasi dwibahasa memiliki pola jeda yang berbeda. Oleh karena itu, penentuan akhir giliran bicara merupakan hal yang sangat penting. Konversi ucapan ke teks secara waktu nyata pengukuran, bukan sekadar pengaturan API.
Lakukan tes keraguan
Gunakan keempat baris ini:
- “Nomor rekening saya adalah … 4172.”
- “Saya setuju… jika tanggal pengirimannya tetap hari Jumat.”
- “Dosisnya adalah lima belas—tidak, lima puluh—miligram.”
- “Ana, bisakah kamu—” kemudian disela oleh pembicara kedua.
Hitunglah akhiran giliran yang salah, titik akhir yang terlambat, interupsi, dan kata-kata yang terpotong. Kemudian sesuaikan ambang batas titik akhir hanya jika aplikasi tersebut menyediakannya. Jika produk tersebut adalah aplikasi yang sudah jadi, amati perilakunya dan putuskan apakah sesuai dengan tugasnya.
Jam ini berada di mana Konversi ucapan ke teks secara waktu nyata berubah menjadi rekayasa percakapan, bukan transkripsi biasa.
Jam 4: Waktu Menuju Rekaman yang Dapat Digunakan
Sesi keempat adalah yang terpenting bagi tim. Sesi ini berakhir ketika hasil yang diperoleh dapat mendukung tindakan selanjutnya.
“Dapat digunakan” dapat berarti:
- Teks keterangan tetap mudah dibaca selama sesi berlangsung.
- Pembicara dapat diidentifikasi.
- Nama, angka, dan terminologi dapat dikoreksi.
- Transkrip lengkap dapat disalin atau diekspor.
- Data tersebut dapat dicari dan memerlukan izin akses.
- Ringkasan dan poin-poin tindakan telah dibuat.
- Teks sumber dan teks terjemahan tetap berpasangan.
- Retensi dan penghapusan sudah dipahami.
Suatu sistem dapat memenangkan tiga jam pertama dan kalah pada jam keempat. Streaming JSON mentah bukanlah catatan rapat. Teks keterangan cepat yang menghilang bukanlah bukti. Ringkasan yang indah tanpa transkrip yang dapat dilacak dapat menyembunyikan kesalahan pengenalan. Inilah alasannya. Konversi ucapan ke teks secara waktu nyata Pengadaan harus mengukur alur kerja yang telah selesai serta model streaming.
Konversi ucapan ke teks secara waktu nyata Oleh karena itu, evaluasi harus dilakukan pada saat digunakan, bukan pada saat dihasilkan. Mintalah peserta, peninjau, pengembang, dan administrator untuk menguji sesi yang sama dari perspektif mereka masing-masing.
Empat Rute Dibandingkan dengan Empat Jam
| Produk | Jenis produk | Teks pertama | Kontrol stabilitas dan finalitas | Penanganan pembicara | Peran multibahasa | Alur kerja catatan yang dapat digunakan | Paling cocok |
|---|---|---|---|---|---|---|---|
| Transink AI | Aplikasi terjemahan rapat yang siap digunakan. | Tampilan dwibahasa langsung | Dikelola oleh produk, bukan diekspos sebagai parameter API. | Secara otomatis membedakan pasangan bahasa yang dipilih; tinjau dalam teks asli dan terjemahan. | 60 bahasa, subtitle dwibahasa, sulih suara | Catatan terjemahan, transkrip, dan ringkasan rapat AI. | Individu dan tim yang membutuhkan komunikasi lintas bahasa secara langsung tanpa perlu membuat aplikasi. |
| Deepgram | API streaming pengenalan suara ke teks | Hasil sementara dapat diaktifkan. | Menampilkan hasil sementara/akhir, penentuan titik akhir, peristiwa akhir ucapan, kontrol akhir ujaran, dan finalisasi manual. | Opsi diari dan multi-saluran bergantung pada konfigurasi/model. | Opsi bahasa dan model streaming; penerjemahan adalah keputusan alur kerja terpisah. | Pelanggan harus membangun penyimpanan, pengeditan, izin, ringkasan, dan antarmuka pengguna (UI). | Pengembang yang membuat agen suara, teks terjemahan, kecerdasan panggilan, atau produk transkripsi khusus. |
| AssemblyAI | API streaming pengenalan suara ke teks | Transkrip sebagian dikembalikan melalui koneksi streaming. | Penentuan titik akhir yang cerdas dan transkrip akhir yang tidak dapat diubah; perilaku spesifik model berlaku. | Fitur streaming diarization dan revisi pembicara tersedia pada model yang didukung. | Model streaming multibahasa mendukung kumpulan bahasa yang dipublikasikan. | Pelanggan membangun aplikasi jadi dan mencatat siklus hidup. | Tim produk yang membutuhkan pengenalan streaming dengan diarization dan kecerdasan hilir. |
| Soniox | API AI ucapan waktu nyata | Token non-final mengalir dengan latensi rendah. | Bendera token akhir, finalisasi manual, stempel waktu token, dan kemajuan pemrosesan. | Diarisasi pembicara opsional | Transkripsi dan terjemahan multibahasa secara real-time melalui konfigurasi API. | Pelanggan membangun antarmuka, persistensi, peninjauan, dan tata kelola. | Pengembang yang membuat aplikasi rapat, siaran, asisten, atau antarmuka suara multibahasa. |
Kemampuan telah diperiksa berdasarkan dokumentasi produk resmi pada tanggal 3 Oktober 2026. Model, bahasa, batasan, dan harga dapat berubah.
Tabel ini tidak menentukan satu pemenang universal. Tabel ini memisahkan dua keputusan pembelian: membangun produk di sekitar API streaming, atau menggunakan alur kerja yang sudah jadi. Yang terbaik Konversi ucapan ke teks secara waktu nyata Rute tersebut bergantung pada siapa yang memiliki hak atas perekaman audio, desain antarmuka, koreksi, penyimpanan, dan dukungan.
Rute 1: Gunakan AI Transync Saat Komunikasi Antar Bahasa Diperlukan
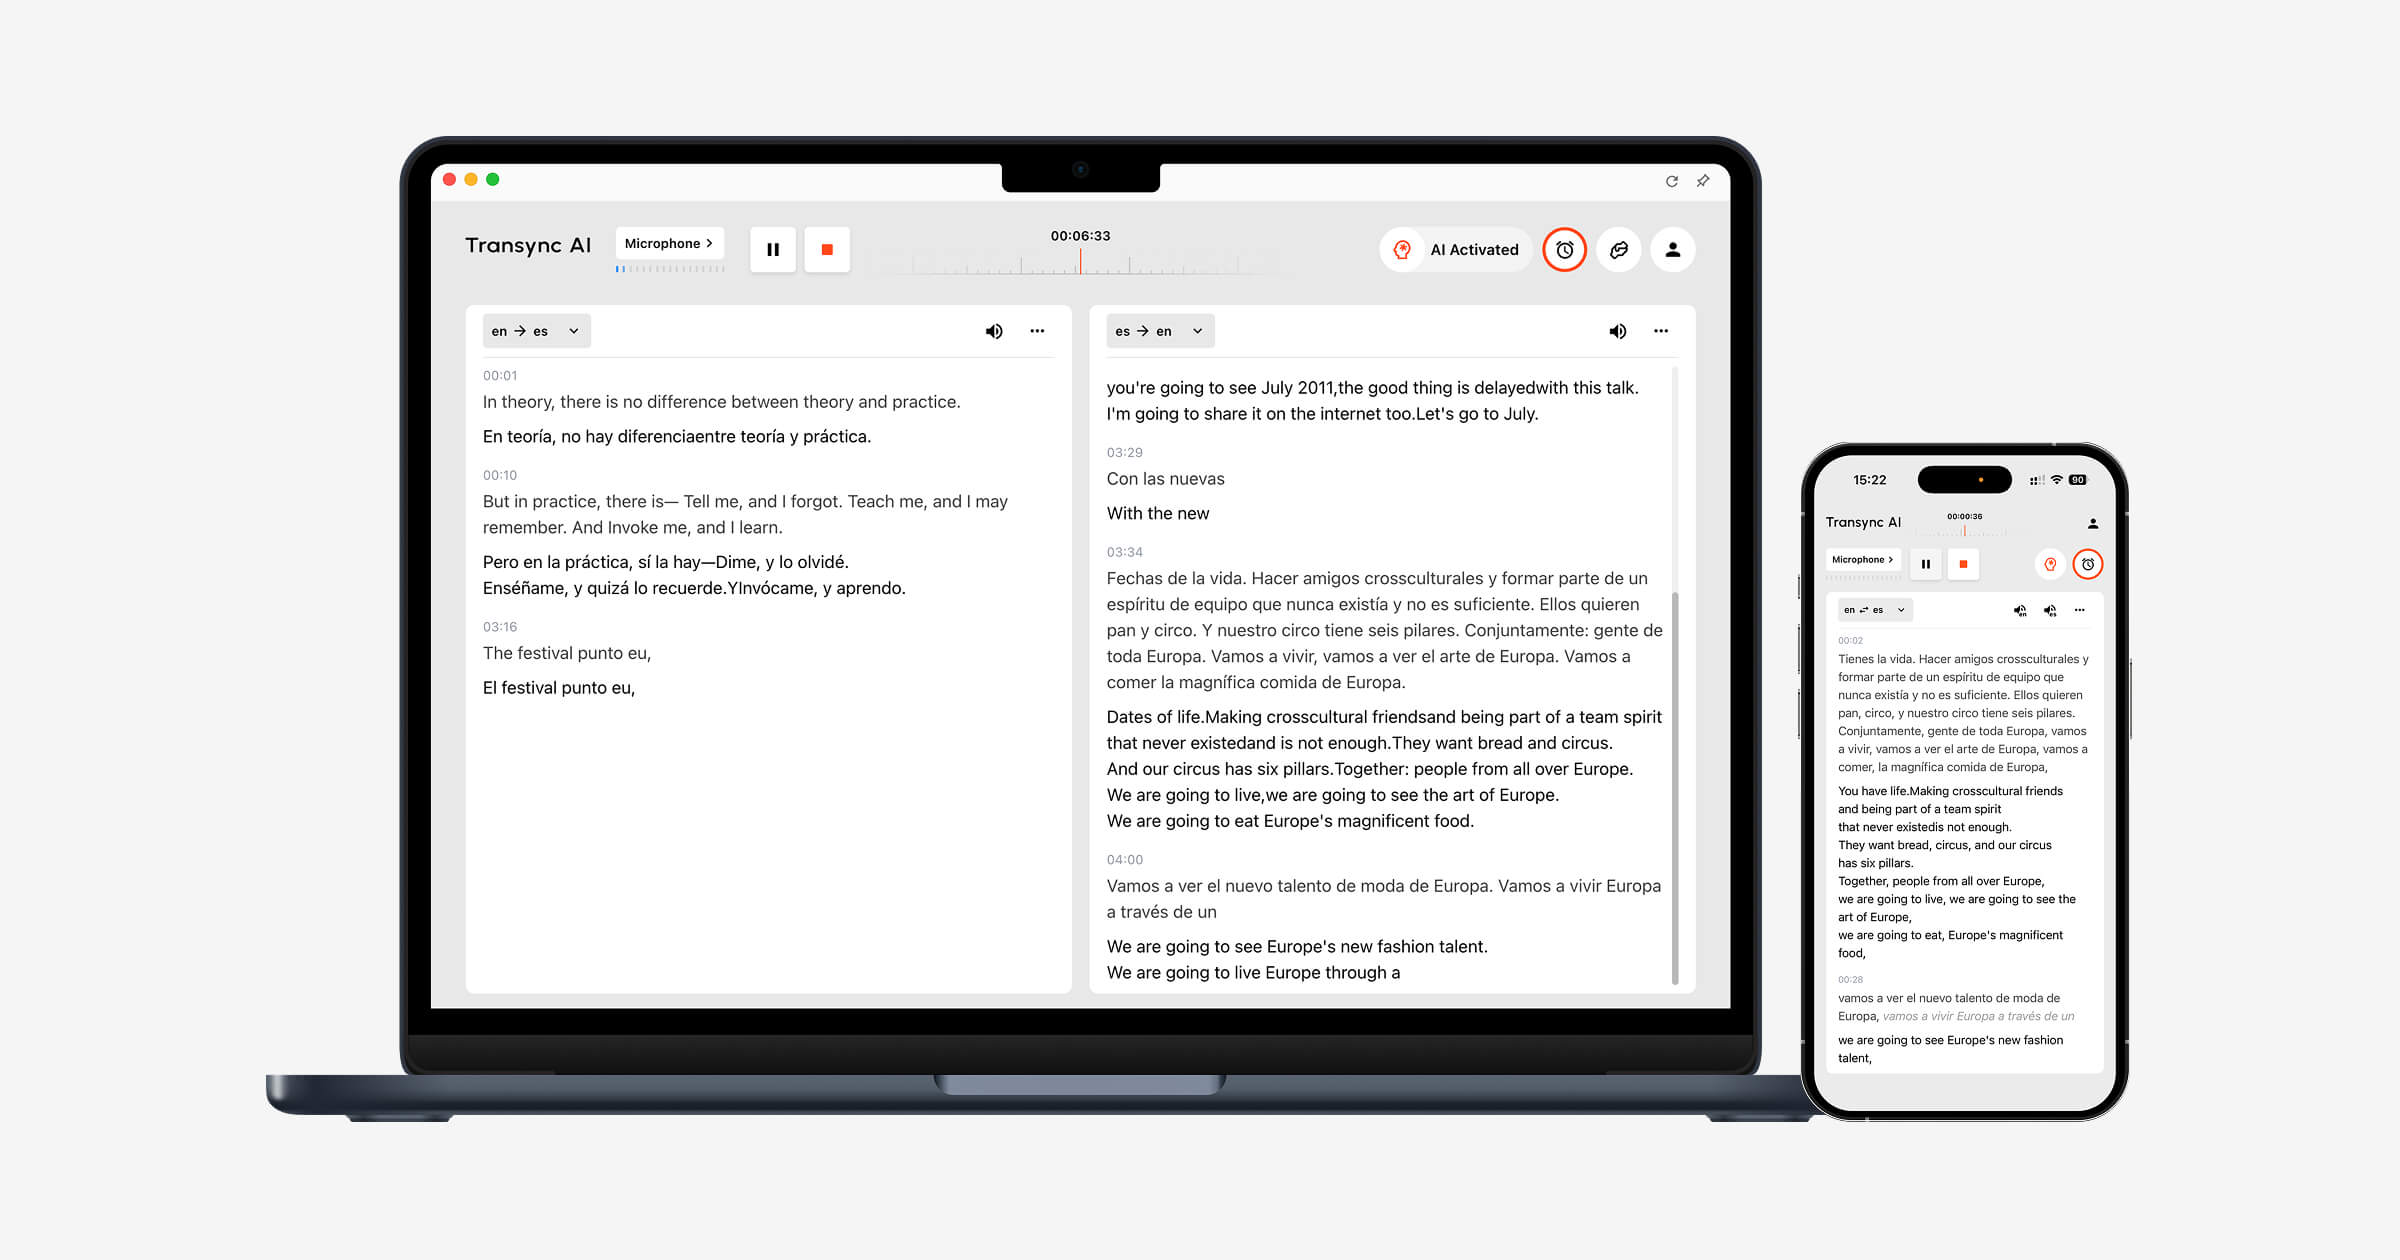
Transink AI Produk ini tidak dijual sebagai API pengenalan suara ke teks untuk tujuan umum. Ini adalah produk rapat dan percakapan siap pakai yang menggabungkan pengenalan suara dengan terjemahan. alur kerja penerjemahan waktu nyata Mendukung 60 bahasa dan menampilkan teks asli di samping teks terjemahan, yang membantu pengguna memisahkan kesalahan pengenalan dari kesalahan terjemahan.
Untuk panggilan online, terjemahan pertemuan langsung Dapat bekerja bersama berbagai lingkungan konferensi melalui mikrofon atau jalur audio komputer yang dipilih. Teks terjemahan gambar-dalam-gambar Pertahankan agar teks dwibahasa tetap terlihat di atas aplikasi yang didukung, alih-alih memaksa pengguna untuk melihat tab transkrip terpisah.
Sebelum melakukan panggilan, Kata Kunci dan Konteks Dapat menyiapkan nama, akronim, istilah produk, dan latar belakang. Setelah sesi, transkrip menyimpan teks asli dan terjemahan, sementara Catatan Rapat AI Dapat menghasilkan ringkasan dan poin tindakan. Panduan transkrip saat ini menyatakan bahwa ringkasan rapat dapat dihasilkan dalam 55 bahasa.
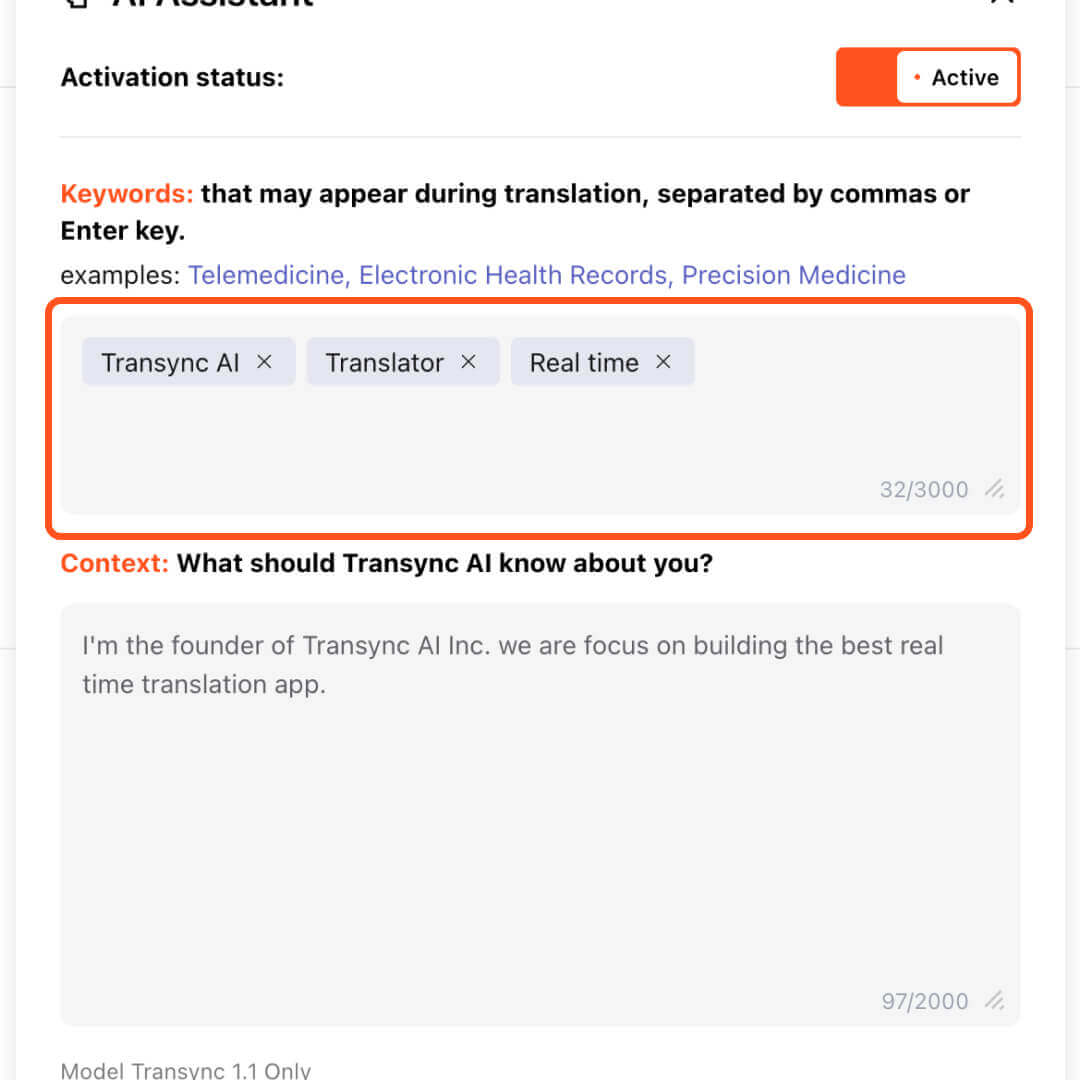
Antarmuka Transync AI menyoroti panel aktivasi asisten AI dengan kata kunci 'Transync AI', 'Penerjemah', dan 'Waktu nyata', yang menunjukkan cara memasukkan kata kunci khusus untuk terjemahan yang akurat.
Memilih Transink AI Saat hasil bisnisnya adalah memahami dan merespons lintas bahasa, pilihlah API streaming jika tim sedang membangun agen suara sendiri, platform analisis panggilan, produk aksesibilitas, atau antarmuka transkripsi terintegrasi.
Batasan ini penting: Transink AI Ini bukan mesin dikte offline generik atau titik akhir STT pengembang. Perutean audio, kualitas jaringan, pasangan bahasa, mikrofon, dan pengiriman jarak jauh harus diuji sebelum pertemuan penting.
Rute 2: Gunakan Deepgram Saat Pengaturan Waktu Belok Merupakan Bagian dari Produk
Deepgram Hal ini sangat bermanfaat bagi pengembang karena dokumentasinya memisahkan hasil sementara, segmen yang telah diselesaikan, titik akhir ucapan yang terdeteksi, dan peristiwa akhir ucapan. Pemisahan tersebut memungkinkan aplikasi untuk memutuskan kapan harus menampilkan teks, menambahkan teks tetap, atau memicu respons.
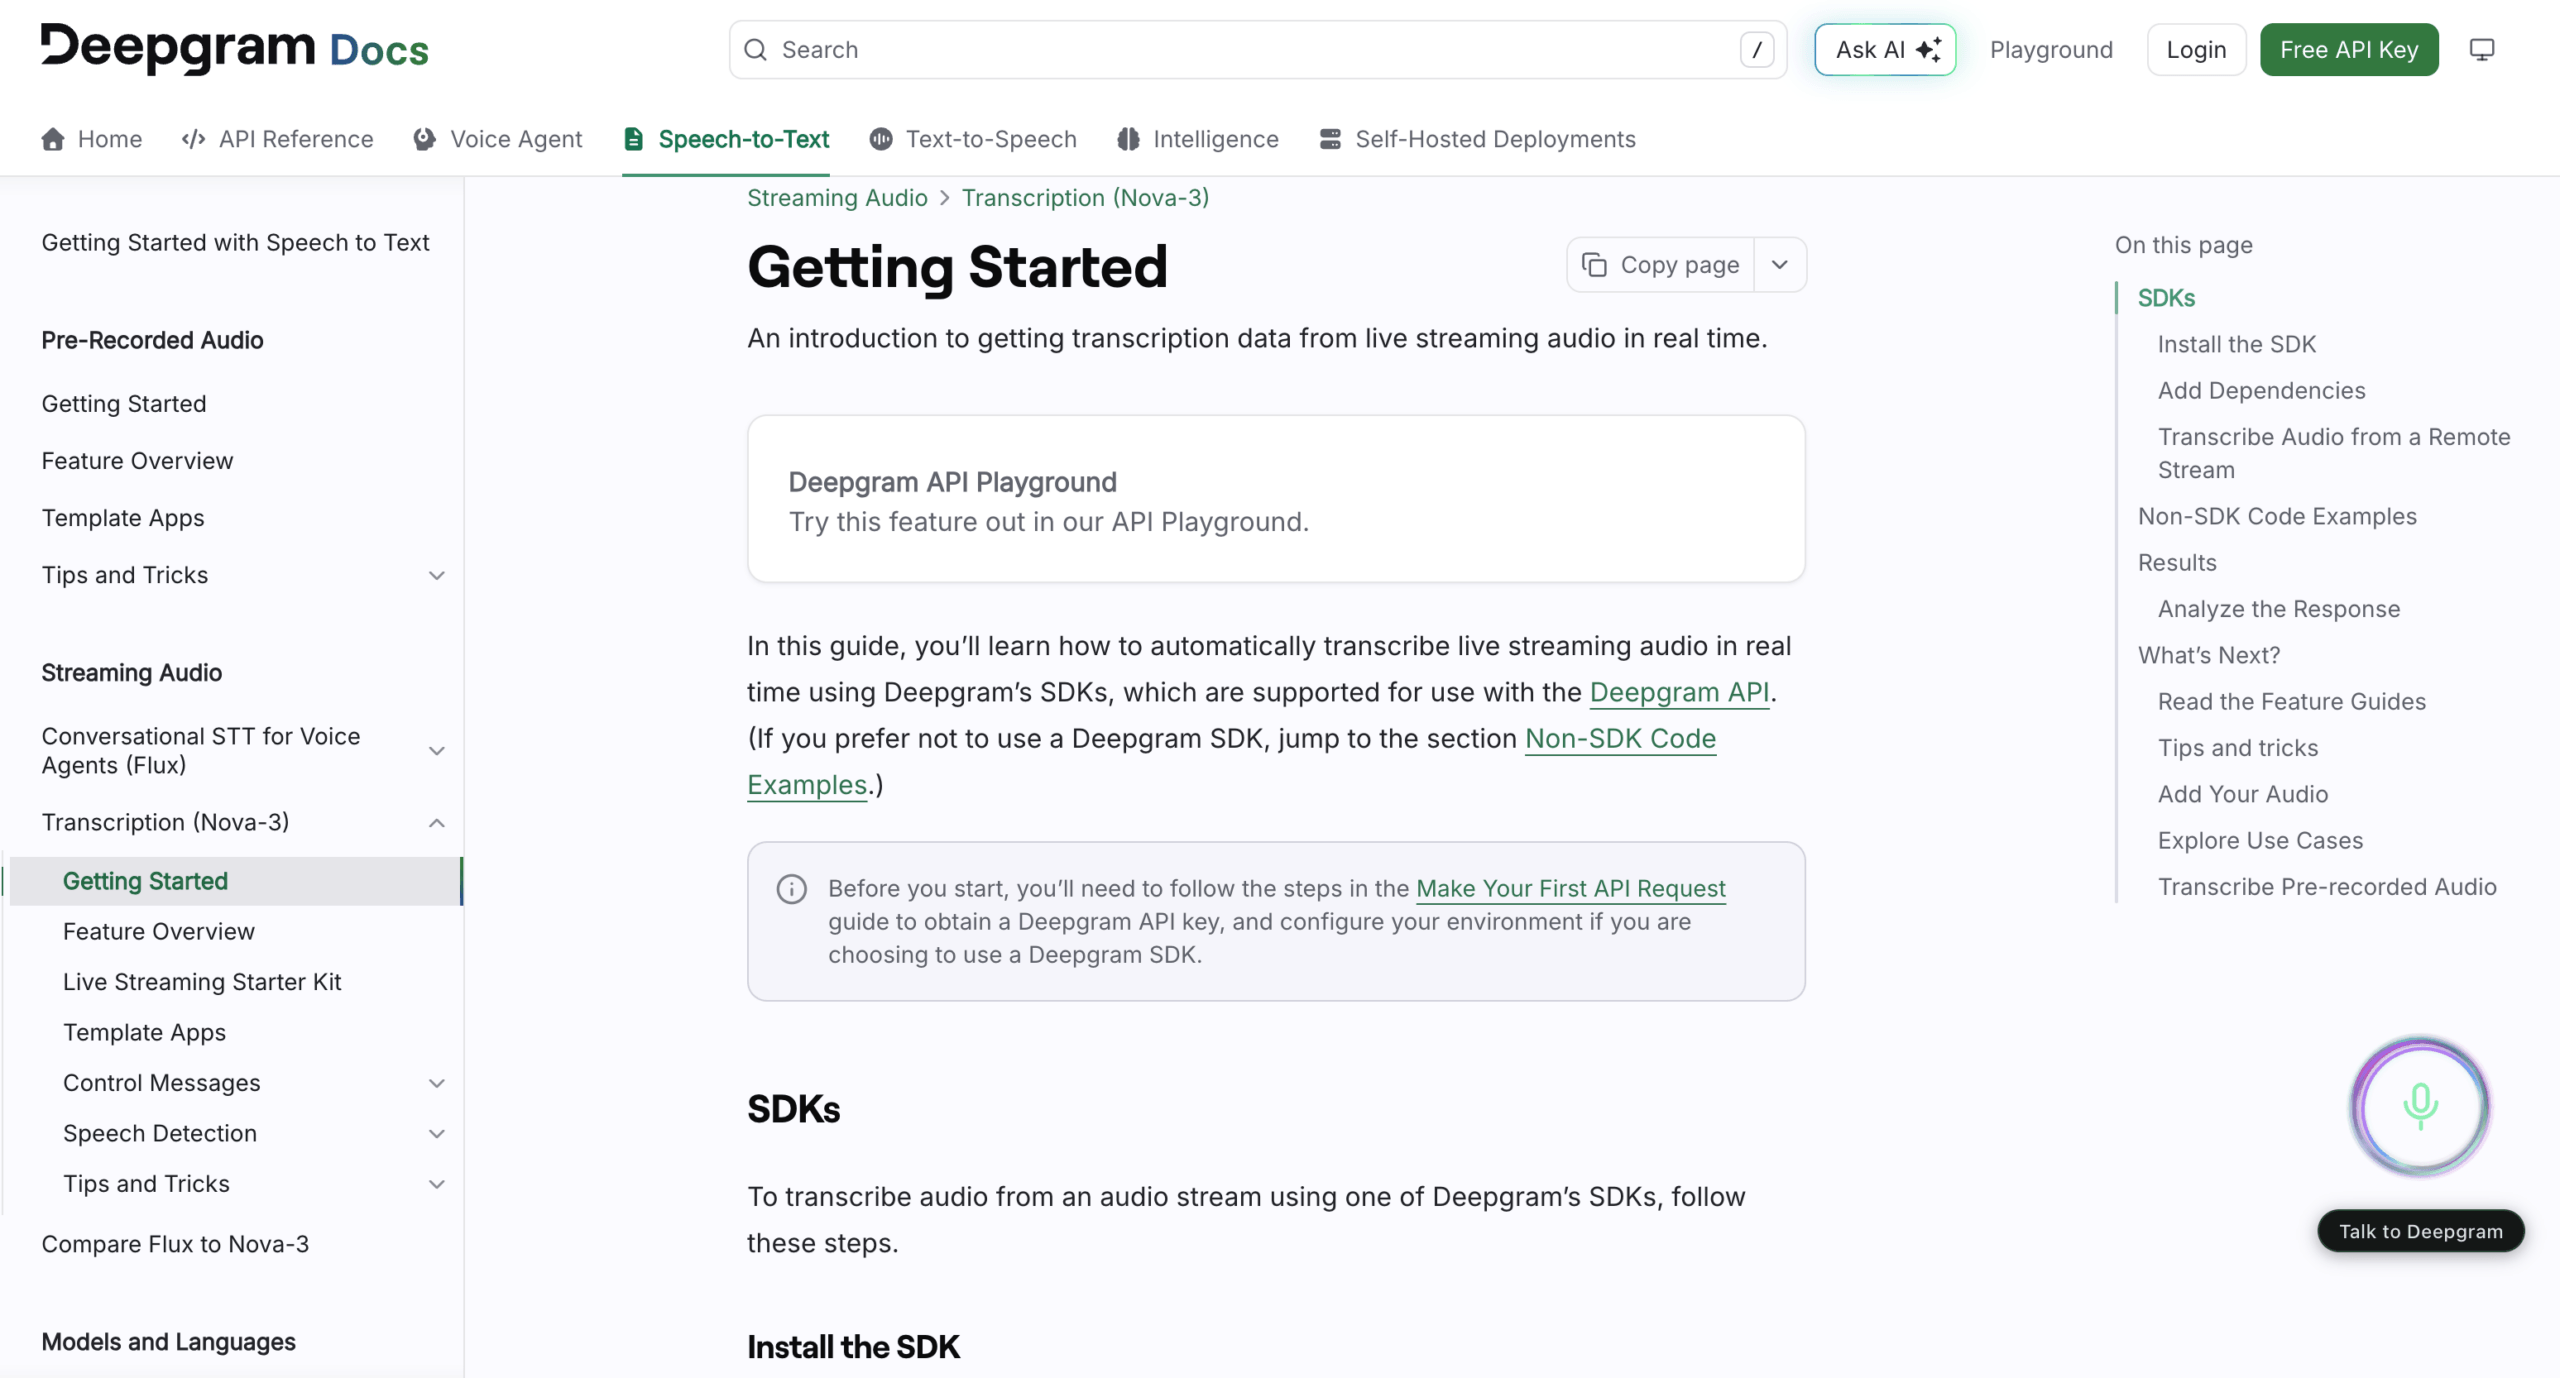
Menggunakan Deepgram Ketika tim produk perlu menyesuaikan perilaku percakapan daripada menerima antarmuka teks tetap. Tim tetap bertanggung jawab atas peng传输 audio, manajemen status, rendering teks parsial, penyimpanan, otentikasi, izin, koreksi, dan pengalaman pengguna akhir.
Kesalahan implementasi yang umum adalah hanya menyimpan respons terbaru atau hanya menunggu hingga peristiwa akhir ucapan terjadi. Panduan resmi menjelaskan bahwa ujaran yang panjang dapat berisi beberapa segmen transkrip yang telah diselesaikan sebelum akhir ucapan terdeteksi. Aplikasi harus menggabungkan segmen akhir dengan benar.
Rute 3: Gunakan AssemblyAI Saat Label Pembicara Penting dalam Streaming
AssemblyAI menyediakan model streaming dengan transkrip parsial dan final, penentuan titik akhir, pemberian petunjuk kata kunci, stempel waktu kata, dan mode diarization pembicara yang didukung. Dokumentasinya juga menjelaskan peristiwa revisi pembicara: model dapat mengoreksi label pembicara sebelumnya saat mengumpulkan lebih banyak bukti.
Perilaku revisi tersebut penting dalam antarmuka langsung. Jika aplikasi menampilkan "Pembicara A" sebagai permanen terlalu dini, koreksi selanjutnya mungkin tidak akan pernah mencapai catatan yang tersimpan. Antarmuka pengguna membutuhkan strategi yang disengaja untuk label dan revisi yang tertunda.
Memilih AssemblyAI Saat streaming yang peka terhadap pembicara dan kontrol tingkat aplikasi menjadi penting. Konfirmasikan model yang tepat, dukungan bahasa, perilaku diarization, opsi medis, dan persyaratan data untuk penerapan yang direncanakan; fitur bervariasi tergantung model streaming.
Rute 4: Gunakan Sonyox untuk API Streaming Multibahasa
Soniox Menggabungkan transkripsi dan terjemahan waktu nyata melalui API WebSocket-nya. Antarmuka saat ini mendukung petunjuk bahasa, penyesuaian konteks, penanggalan pembicara, konfigurasi terjemahan, stempel waktu tingkat token, kepercayaan, finalitas, dan informasi bahasa.
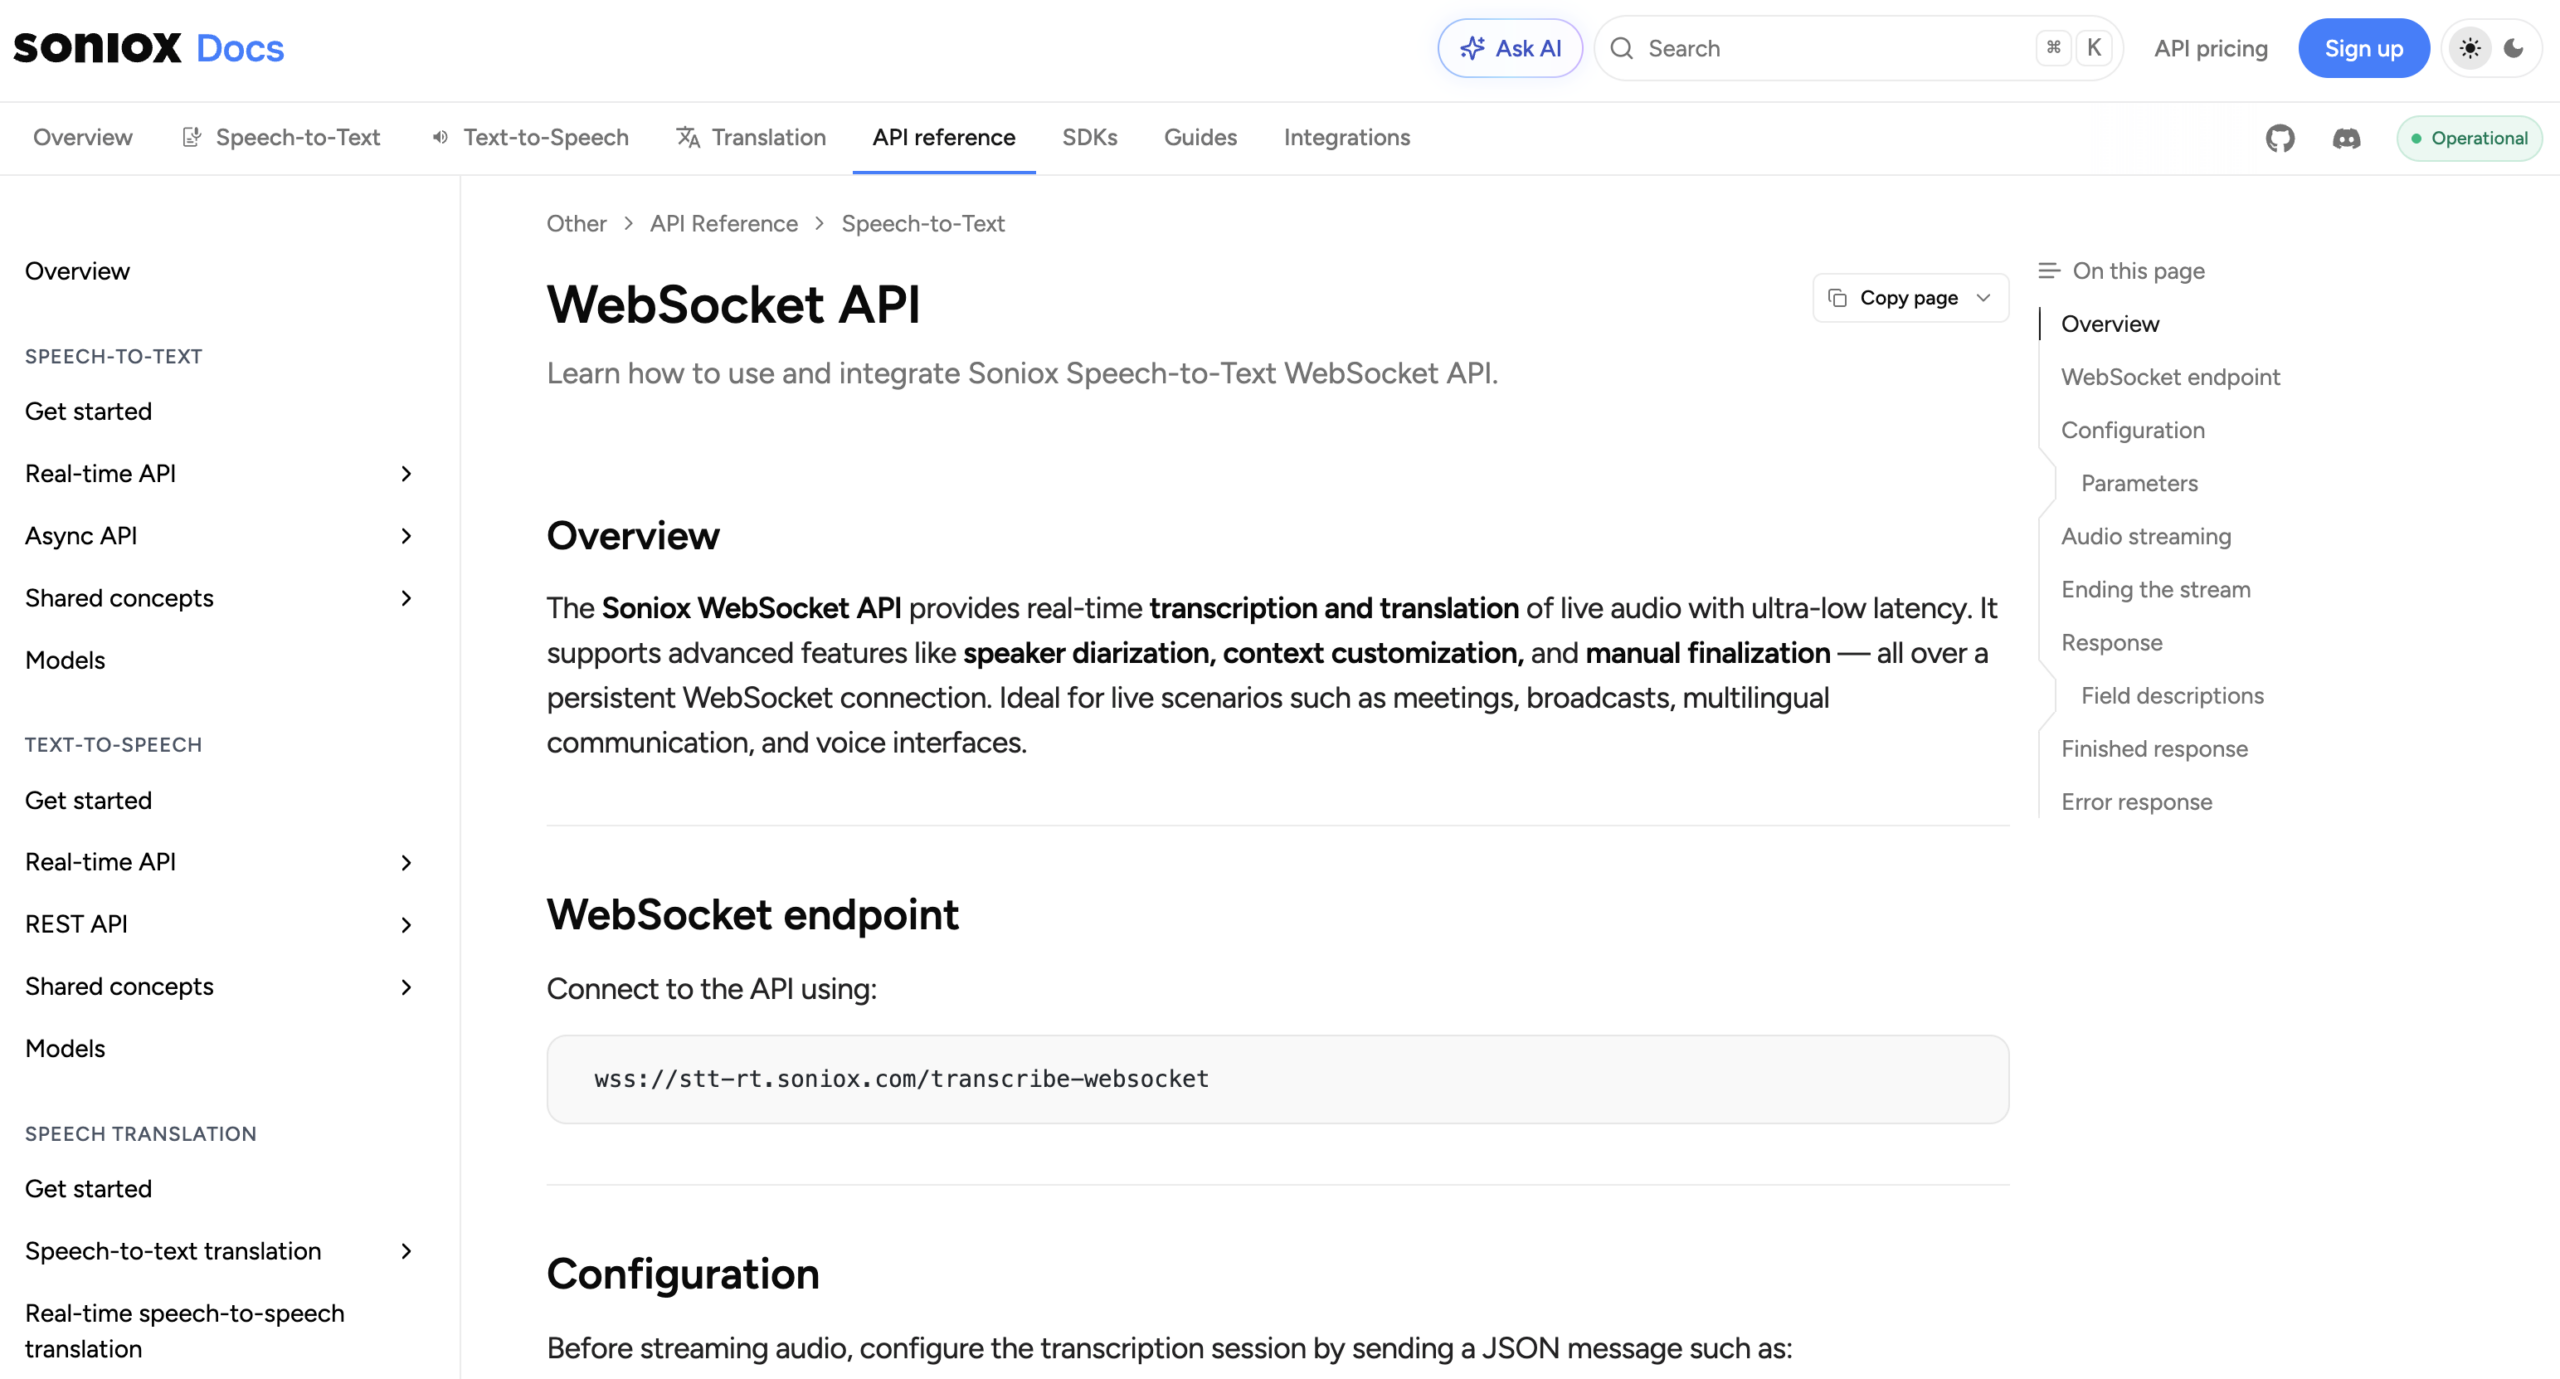
Hal ini membuat Soniox relevan ketika pengembang menginginkan Konversi ucapan ke teks secara waktu nyata dan keluaran multibahasa di dalam aplikasi mereka sendiri. Konfigurasi konteks dapat membantu istilah domain, tetapi harus diuji dengan skrip terminologi tetap daripada diasumsikan dari nama fitur.
Seperti halnya API lainnya, layanan ini mengembalikan blok bangunan. Pembeli tetap harus membuat akses peserta, koreksi, retensi, ekspor, ringkasan, kontrol admin, pemantauan, pemulihan kesalahan, dan dukungan.
Mengapa Tingkat Kesalahan Kata Saja Tidak Cukup
Tingkat kesalahan kata mengukur substitusi, penghapusan, dan penyisipan terhadap transkrip referensi. Ini berguna, tetapi satu nilai rata-rata dapat menyembunyikan kesalahan yang paling penting.
Bandingkan kedua kesalahan ini:
- “Kita bisa mengirimkannya Kamis” menjadi “Kita bisa mengirimkannya pada Selasa.”
- “Silakan buka panel pengaturan” menjadi “Silakan buka panel pengaturan.”
Keduanya mungkin dihitung secara serupa, tetapi yang pertama mengubah sebuah komitmen. Buat buku besar kesalahan untuk:
- Nama dan identitas pembicara.
- Angka, mata uang, tanggal, dan satuan.
- Negasi dan syarat.
- Nama produk dan terminologi khusus.
- Peralihan kode dan perubahan bahasa.
- Gangguan dan koreksi diri.
- Tanda baca yang berubah makna.
Kemudian tambahkan faktor waktu. Kata yang benar yang disampaikan setelah keputusan dibuat mungkin secara operasional salah. Kesalahan sementara yang dikoreksi kemudian mungkin masih menyebabkan agen suara atau peserta untuk bertindak.
Hak Konversi ucapan ke teks secara waktu nyata Oleh karena itu, skor menggabungkan tingkat keparahan kesalahan faktual, stabilitas, pengaturan waktu giliran bicara, dan penyampaian—bukan hanya akurasi kata rata-rata.
Rekaman Kebenaran Dua Menit
Gunakan satu sumber rekaman agar setiap kandidat menerima audio yang identik. Jangan biarkan setiap vendor memilih demo mereka sendiri.
Naskah
- “Halo, saya Niamh O'Rourke dari Aster-Q.”
- “Referensi yang dimaksud adalah BX-417, bukan BX-471.”
- “Pendapatan pada $ adalah 15,05 juta, naik 13,6 persen.”
- “Jangan perpanjang kontrak kecuali perjanjian tingkat layanan telah ditandatangani.”
- “Kirim lima belas—maaf, lima puluh—unit pada hari Kamis.”
- “API ini menggunakan streaming WebSocket dan endpoint 300 milidetik.”
- Berhentilah selama 700 milidetik di tengah kalimat kondisional.
- Biarkan orang kedua menyela, lalu kembali ke pembicara pertama.
- Tambahkan satu kalimat dalam bahasa kedua yang dibutuhkan.
- Akhiri dengan kalimat pelan selagi suara keyboard masih terdengar.
Lembar tangkapan
| Pengukuran | Cara merekamnya | Lewatkan kondisi untuk didefinisikan sebelum pengujian. |
|---|---|---|
| Waktu untuk pesan teks pertama | Audio dimulai dengan hipotesis non-kosong pertama. | Berdasarkan kebutuhan pengguna akan umpan balik visual. |
| Waktu menuju teks stabil | Kata terakhir yang diucapkan hingga teks akhir yang tak berubah. | Cukup cepat sehingga orang-orang tidak menindaklanjuti revisi tersebut. |
| penundaan finalitas putaran | Akhir giliran yang dimaksudkan menuju pemicu peristiwa atau respons titik akhir. | Tidak mengganggu jeda normal atau terasa tidak responsif. |
| Jumlah revisi | Jumlah perubahan hipotesis yang terlihat atau pada tingkat API. | Antarmuka tetap mudah dibaca dan tindakan selanjutnya menunggu hingga selesai. |
| Kesalahan fakta penting | Nama, angka, negasi, tanggal, satuan, dan kondisi | Tidak ada kesalahan tingkat keparahan tinggi yang tidak ditandai dalam uji coba. |
| Pemulihan label pembicara | Waktu dan ketepatan setelah gangguan | Transkrip yang tersimpan mencerminkan atribusi yang telah dikoreksi. |
| Penyelesaian alur kerja | Mengakhiri catatan atau tindakan aplikasi yang dapat dicari/diekspor | Sesuai dengan tenggat waktu operasional. |
Lakukan sepuluh percobaan, kemudian laporkan nilai median, persentil ke-95, dan hasil terburuk yang diamati jika sampel memungkinkan. Satu kali percobaan sempurna tidak menjamin keandalan.
Tujuh Mode Kegagalan dan Perbaikan Pertama
| Gejala | Lapisan yang mungkin | Pemeriksaan pertama yang bermanfaat |
|---|---|---|
| Teks muncul terlambat sejak kata pertama. | Pengambilan, penyangga, pengkodean, jaringan, atau model | Ukur setiap lompatan; kurangi potongan audio yang terlalu besar. |
| Teks muncul dengan cepat tetapi banyak ditulis ulang. | Perilaku hipotesis sementara | Tunggu hingga keputusan final sebelum memicu tindakan; rancang ulang tampilan sementara. |
| Sistem memutus pembicaraan para pembicara yang bijaksana. | Ambang batas titik akhir atau deteksi aktivitas suara | Uji jeda yang lebih lama dan sesuaikan titik akhir jika tersedia. |
| Sistem menunggu terlalu lama setelah perintah singkat. | Ambang batas titik akhir atau logika giliran aplikasi | Uji ambang batas yang lebih pendek atau kontrol akhir putaran yang eksplisit. |
| Nama dan kode berulang kali gagal. | Ambiguitas akustik dan konteks domain yang hilang | Tambahkan istilah/konteks kunci dan tingkatkan kualitas mikrofon. |
| Label pembicara berubah setelah ditampilkan. | Streaming diarization merevisi klaster. | Mendukung label yang tertunda dan menerapkan peristiwa revisi ke catatan tersebut. |
| Transkripnya cepat tetapi tidak dapat digunakan setelahnya. | Alur kerja produk yang hilang | Tambahkan koreksi, penyimpanan, pencarian, izin, ekspor, dan penghapusan—atau pilih aplikasi yang sudah jadi. |
Penyelesaian Masalah Konversi ucapan ke teks secara waktu nyata dari kiri ke kanan. Mengganti model tidak akan memperbaiki input yang dibisukan, laju sampel yang salah, atau antarmuka pengguna yang menyimpan teks sementara sebagai teks final.
Ketika Konversi Ucapan ke Teks Bukanlah Tugas Akhir
Transkripsi menjawab, “Kata-kata apa saja yang dikenali?” Terjemahan menjawab, “Apa arti kata-kata tersebut dalam bahasa lain?” Produk rapat juga harus menjawab, “Apakah orang lain dapat memahami, menanggapi, dan memperbaiki keputusan tersebut di kemudian hari?”
Jika semua orang berbicara bahasa yang sama dan membutuhkan teks terjemahan, dikte, pencarian, atau analitik yang memudahkan akses, API STT khusus atau produk transkripsi mungkin sudah cukup. Jika peserta menggunakan bahasa yang berbeda, alur kerja memerlukan kontrol tambahan:
- Teks sumber terlihat di samping terjemahan.
- Pemilihan bahasa atau penanganan otomatis.
- Persiapan terminologi dan konteks.
- Teks dalam bahasa target disampaikan selama percakapan.
- Terjemahan suara opsional tersedia saat membaca tidak praktis.
- Rekaman dan catatan yang melestarikan diskusi multibahasa tersebut.
Inilah titik di mana Konversi ucapan ke teks secara waktu nyata menjadi salah satu komponen dari yang lebih besar Transink AI alur kerja, bukan produk akhir.
Pertanyaan yang Sering Diajukan (FAQ) tentang Konversi Ucapan ke Teks Secara Real Time
Apa itu konversi ucapan ke teks secara waktu nyata?
Konversi ucapan ke teks secara waktu nyata Mengubah audio streaming menjadi teks sementara dan final saat percakapan berlangsung. Sistem dapat merevisi hipotesis awal saat menerima lebih banyak konteks, mendeteksi akhir giliran bicara, menerapkan tanda baca, atau meningkatkan atribusi pembicara.
Seberapa besar penundaan yang dianggap sebagai waktu nyata?
Tidak ada ambang batas tunggal. Ukur waktu hingga teks pertama, teks stabil, penyelesaian giliran, dan keluaran alur kerja yang dapat digunakan. Pembaca teks, agen suara, peserta rapat, dan peninjau pasca-panggilan memiliki penundaan yang dapat diterima berbeda-beda.
Mengapa teks langsung terus berubah?
Pengenal audio streaming mempublikasikan hipotesis parsial sebelum kalimat selesai. Audio selanjutnya dapat mengubah susunan kata, tanda baca, bahasa, atau pembicara yang paling mungkin. Aplikasi harus membedakan hasil sementara dari teks final.
Apakah konversi ucapan ke teks secara waktu nyata sama dengan terjemahan langsung?
Tidak. Konversi ucapan ke teks mengenali kata-kata yang diucapkan dalam bahasa sumber. Terjemahan langsung menambahkan transformasi bahasa lain dan mungkin juga menambahkan suara yang diterjemahkan. Transink AI Menggabungkan pengenalan dan penerjemahan untuk percakapan multibahasa.
API mana yang terbaik untuk konversi ucapan ke teks secara real-time?
Tidak ada pemenang universal. Deepgram menawarkan kontrol titik akhir dan status hasil yang terperinci, AssemblyAI menawarkan dukungan untuk perilaku diarisasi dan revisi streaming, dan Soniox Menggabungkan opsi transkripsi dan terjemahan multibahasa. Uji masing-masing dengan audio yang identik dan persyaratan produk yang tepat.
Bisakah pengubah ucapan ke teks secara real-time mengidentifikasi pembicara?
Beberapa model mendukung diarization atau input multikanal, tetapi label mungkin bersifat sementara dan dapat berubah seiring masuknya lebih banyak audio. Uji interupsi, suara serupa, perubahan perangkat, dan koreksi label yang tersimpan.
Apa yang sebaiknya diuji terlebih dahulu oleh sebuah bisnis?
Mulailah dengan rute audio yang sebenarnya dan skrip dua menit yang berisi nama, angka, negasi, koreksi, jeda, interupsi, terminologi, dan bahasa yang dibutuhkan. Ukur keempat jam tersebut dan periksa rekaman yang tersimpan.
Kesimpulan Akhir
Yang tercepat Konversi ucapan ke teks secara waktu nyata Sistem yang andal belum tentu sistem yang menampilkan kata pertama paling awal. Sistem yang dapat diandalkan menyeimbangkan empat jam:
Teks pertama → teks stabil → giliran selesai → catatan yang dapat digunakan
Pilih API streaming ketika pengembang perlu mengontrol titik akhir, hasil parsial, revisi pembicara, dan perilaku aplikasi. Pilih produk rapat yang sudah jadi ketika tim membutuhkan jalur lengkap dari audio ke teks terjemahan, rekaman, dan catatan tanpa perlu membangun infrastruktur tersebut.
Yang terpenting, uji masukan sebenarnya dan konsekuensi sebenarnya. Ukur kata yang muncul, kata yang berubah, giliran yang berakhir, dan catatan yang akan dipercaya orang lain setelahnya.